TransForge:使用本地大语言模型翻译静态网站,仅翻译发生变化的页面
- 发布日期
- 2026年10月19日
- 更新日期
- 2026年10月19日
- 作者
- Jacob Lloyd —— 项目完成后,在 AI 协助下撰写
- 阅读时长
- 约 10 分钟阅读
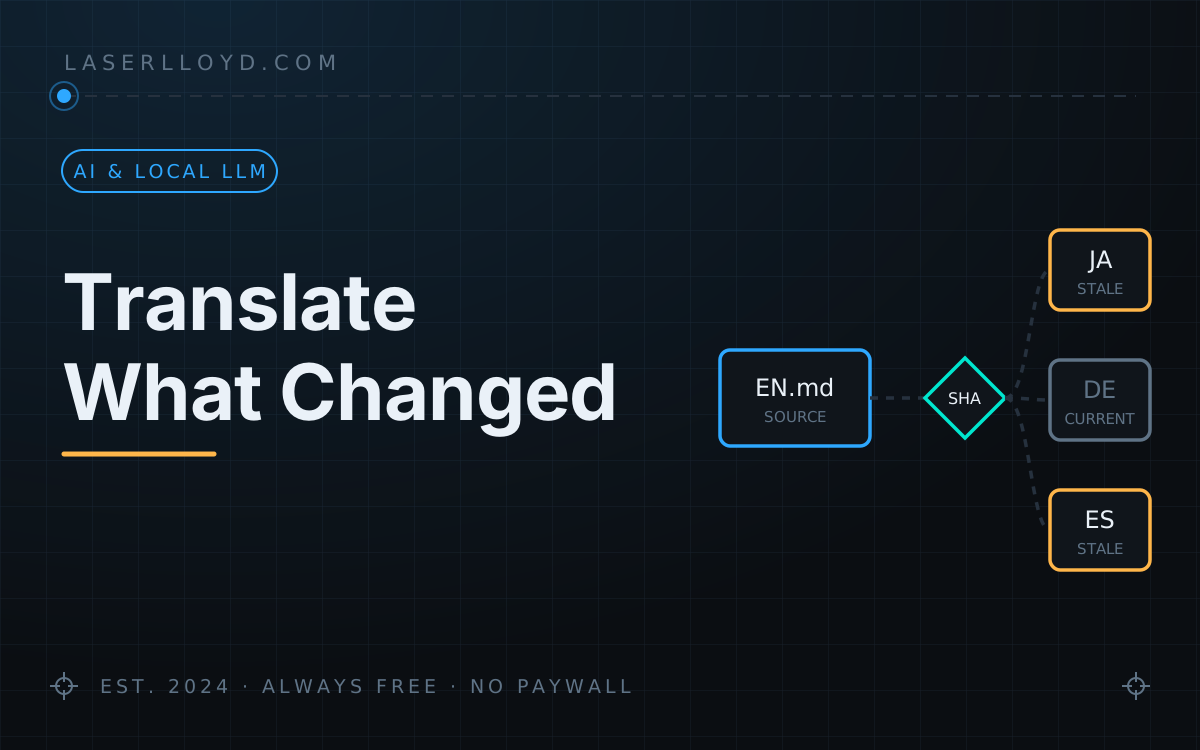
简单来说: TransForge是一款小型程序,它能利用运行在您电脑上的AI模型将网站页面翻译成其他语言。因此,不存在按单词计费的情况,也无需将内容发送给翻译公司处理。该程序会记录下每个已翻译页面的特征信息;下次运行时,它只会重新翻译那些确实被修改过的页面。此外,它绝不会覆盖那些由人工修正过的翻译内容。
这个网站使用英语以及另外七种语言,而我从未手动翻译过任何页面。TransForge 负责这项工作:这是一个命令行工具,它会将每个 Markdown 页面发送至 我自己的 GPU 服务器上的模型进行处理,随后检查翻译结果,并在 page.md 旁边生成 page.ja.md。真正让这个系统实用起来的,是其记录机制:它会保存每个源页面以及所有生成的翻译内容的“指纹”,因此每晚的自动翻译过程只会处理发生变动的内容;而任何经过人工修正的翻译内容也绝不会被覆盖。
简而言之
- 这是什么:一个免费的、采用 MIT 许可协议的 Python 命令行工具,版本为 0.2.0。它仅包含两个文件:标准库以及 PyYAML。
- 需要什么条件:需要一个由 Markdown 文件构成的静态网站,以及一个本地模型服务器。该工具专为 StudioForge 设计;所有操作均通过与 OpenAI 兼容的 API 完成,因此无需使用云端翻译服务,也不存在按字数计费的情况。
- 它能为您做什么判断:针对每个页面和每种语言,根据内容哈希值来判断其翻译是否缺失、过时、经过人工编辑或仍是最新版本——而不会依据文件日期来判断。
- 它拒绝做的事情:不会生成丢失了标题、代码块、链接或图片的翻译内容;不会覆盖人工编辑过的文本;也不会因性能测试而占用 GPU 资源。
- 如何获取:
uv tool install --python 3.13 git+https://github.com/LaserLloyd/TransForge,或者使用代码库中提供的 Docker 配置方式。
最终会得到什么
一条命令就能告诉你各种语言的现状。这是该网站在2026年10月19日的情况(43个英文页面,涉及七种语言):
$ transforge status --site laserlloyd
站点 laserlloyd:43个源页面 × 7种语言 | 使用的模型为 mradermacher/Hy-MT2-30B-A3B-i1-GGUF/Hy-MT2-30B-A3B.i1-Q4_K_S
  语言     缺失      过时    已编辑  未跟踪     偏差    当前数量
  ja             1         0        10         0         0        32
  zh             1         0         8         0         0        34
  ...
  -> 共有7个相关页面需要翻译
status 永远不会与模型服务器通信;它只读取网站内容和清单文件。transforge run --site laserlloyd 则会翻译那七个缺失的页面,仅此而已。“已编辑”列显示的是那些在 TransForge 完成翻译后又被人工修改过的页面。这些页面会保持原样,直到我另有指示。
它也能翻译松散的文本,这对于偶尔检查模型来说非常方便:
$ echo "只有发生更改的页面才会被重新翻译。" | transforge text --to ja
只有被修改过的页面才会被重新翻译。
在GPU设备上模型已经处于热状态的情况下,这只花了15秒。
它是如何决定翻译内容的
对于每一个源页面和目标语言,TransForge都会存储英文源的哈希值、所生成翻译内容的哈希值,以及决定输出结果的各项设置的哈希值(包括模型、提示词、需保留的术语以及温度参数)。通过对比这些哈希值,即可得出每个页面和每种语言对应的状态:
| 状态 | 含义 | run 能翻译吗? |
|---|---|---|
| missing | 尚未创建翻译文件 | 可以 |
| stale | 自翻译完成后,英文原文发生了变更 | 可以 |
| edited | 有人手动修改了翻译内容 | 不可以;只有使用 --force 并指定 --files 才行 |
| untracked | 存在 TransForge 未生成的翻译内容 | 不可以;但可使用 accept 来采纳该内容 |
| drift | 原文与翻译内容均未变化,但模型或提示词设置发生了变更 | 不可以;此状态仅作提示之用 |
| current | 无需任何操作 | 不可以 |
其中两个选项的重要性超乎表面所见。手动编辑的效果优于直接修改源代码:如果两者都进行了操作,页面仍会被标记为“已编辑”,这样任何修正都不会因自动处理而丢失。此外,更换模型也不会在后台重新翻译整个网站;你会看到所谓的“偏差”,进而决定哪些页面值得重新翻译。
在生成翻译内容之前会进行一系列检查:确保标题、代码块、表格、图片、图像及链接的数量与原文一致;确认目标页面确实包含相应的语言字符(例如日语页面中需有日文文字);杜绝出现虚构的受保护品牌术语;同时还需满足最低长度要求。若任何一项检查未通过,则维持原翻译不变。内部链接由 TransForge 在模型运行后予以重写,模型本身不会执行此操作:只有当对应的日语页面存在时,“/projects/foo/”才会被改为“/ja/projects/foo/”。此外,所有被覆盖的文件都会先被复制到备份文件夹中。
安装与首次运行
uv tool install --python 3.13 git+https://github.com/LaserLloyd/TransForge
mkdir -p ~/.config/transforge
cat > ~/.config/transforge/config.toml <<'EOF'
[defaults]
endpoint = "http://localhost:1234"
model = "publisher/repo/file-stem"
EOF
[sites.example]
root = "~/sites/example"
content_dirs = ["content/projects", "content/pages"]
languages = ["ja", "de"]
lang_names = { ja = "日语", de = "德语" }
link_dirs = ["projects"]
no_translate = ["MyProduct"]
translate_fields = ["title", "excerpt"]
EOF
export TRANSFORGE_LLM_API_KEY=... # 仅当服务器需要密钥时才设置
transforge config # 显示解析后的配置;会说明密钥的来源,但不会打印密钥本身
transforge models # 服务器提供的模型列表;请将完整的模型 ID 复制到配置中
transforge run --site example --dry-run # 预览将要翻译的内容
transforge run --site example --limit 2 # 翻译两页内容,然后查看结果
endpoint 即服务器的根路径,但不包含 /v1;model 则必须是服务器所列出的完整 ID(StudioForge 的 ID 格式为 publisher/repo/file-stem)。若提供的 ID 无法识别,程序将返回代码 5 并给出最接近的匹配项。no_translate 用于指定那些必须保持原样的名称,而 translate_fields 则列出了需要翻译的前置信息键名;其余所有键均会被原样复制。在 Debian 和 Ubuntu 系统中,切勿使用系统自带的 Python 来执行 pip install .,该操作会被拒绝(参见 PEP 668)。此时可使用 uv tool、pipx 或虚拟环境来完成安装。
如果您的网站已经通过其他方式完成了翻译,只需运行一次 transforge accept --site example。这样就能将现有文件标记为当前版本,而无需再次进行翻译。
退出代码适用于脚本和定时任务:0表示操作已完成或无需执行;1表示某个页面处理失败(从状态信息来看,该任务仍需处理);2表示配置有误或服务器拒绝了API密钥;4表示无法连接到服务器;5表示所需模型并未部署在服务器上;6表示有基准测试正在占用GPU资源,因此相关任务被延迟执行。
Docker
该仓库还提供了一个 Compose 配置,可将 TransForge 作为工具箱来处理您的网站文件夹;清单文件则存储在卷中,此外还提供可选的调度服务:
git clone https://github.com/LaserLloyd/TransForge.git && cd TransForge
cp deploy/compose/.env.example deploy/compose/.env    # 请设置 LLM_BASE_URL 和 TRANSFORGE_LLM_API_KEY
docker compose -f deploy/compose/compose.yml run --rm app status --all
它不会开放任何端口。在容器内部,localhost 指代的就是容器本身,因此模型服务器必须监听一个容器能够访问的地址。我是在本地直接运行 TransForge 的,并未亲自使用过容器;仓库中的 docs/deploy/docker.md 文件提供了相关详情,包括备份方法。
0.2.0版本的新特性
0.2.0版本(2026年10月发布)主要旨在支持与StudioForge 2.0服务器的对接,而这一操作需要使用API密钥:
- 支持 API 密钥。 TransForge 在向服务器发送的每个请求中都会带上
Authorization: Bearer头。它会从TRANSFORGE_LLM_API_KEY(或STUDIOFORGE_API_KEY,或者你通过api_key_env指定的环境变量)中读取密钥;更换密钥后也不会导致任何页面被标记为“过时”。若未提供密钥,对于需要密钥的服务器,程序会返回一行简短回复并返回退出码 2(具体示例如列表下方所示)。 - 在基准测试场景下具备容错能力。 开始翻译前,TransForge 会检查是否有基准测试正在占用 GPU;若有,则暂停翻译操作。过去,当检测到有任务占用资源时系统会误判为“没有任何程序在运行”,从而关闭该保护机制;如今程序会直接终止并返回退出码 2。
- 兼容 Windows 系统。 所有清单文件在各操作系统上均使用
/作为路径分隔符,因此此类文件可在 Windows、Linux 及容器环境中通用。旧版 Windows 格式的清单文件在读取时会被自动重新编码。切勿运行accept --all来“重建”清单:此举会将原本过时的翻译内容误判为最新版本。 - 原有的管理 PIN 码已不再推荐使用。 模型的加载与卸载操作现均通过 API 密钥来完成;该 PIN 码在下一个版本中仍可正常使用,但仅作为唯一凭证使用时系统会弹出警告提示。
该系统对 http://api_key_env / api_key)。
升级方法:执行 uv tool install --reinstall --python 3.13 git+https://github.com/LaserLloyd/TransForge,如果您的服务器要求使用 API 密钥,还需设置 TRANSFORGE_LLM_API_KEY。
注意事项/易错点
- 请亲自阅读前几条翻译结果。 检查机制能发现结构上的错误,但无法识别用词是否恰当。我使用的是专用的翻译模型 Hy-MT2 30B,并设置
prompt_template = "hunyuan-mt"(这是纯翻译模型所需的简短提示模板);若是通用指令型模型,则使用默认模板即可。无论如何,任何重要的内容都值得人工复核。 - 经过编辑的翻译结果会保持原状,直至您做出决定。 这正是设计初衷;不过这也意味着即便源文本有所修改,该语言的翻译也不会随之更新。
status -v命令可列出这些已编辑的内容;若需重新翻译某页面,则使用run --force --files <page>。 - 更换模型并不会触发重新翻译。 这样一来,各页面的翻译内容可能会出现“偏差”。如需修正重要页面的翻译,请使用
--force --files参数重新处理。 - 专为 StudioForge 设计。 模型预热过程(即为模型分配足够的并行处理资源)以及基准测试功能均通过 StudioForge 自身的 API 来实现。README 中提到 llama.cpp 服务器也可用于翻译;不过我仅在其上测试过与 StudioForge 相关的功能。
- 非递归处理。
content_dirs参数指定的目录仅会扫描一层子目录。请逐一列出所有包含页面的文件夹。 - 若某页面需保持英文原状,则在其前端配置中设置
en_only: true(或translate: false),这样该页面便不会被翻译。
获取方式
github.com/LaserLloyd/TransForge,采用 MIT 许可证。README 中提供了适用于 Windows、Linux 和 macOS 的安装说明,还有完整的配置参考信息。此外还设有一个可选的第二轮审核步骤,该步骤可调用托管模型来完成翻译(默认处于关闭状态;翻译过程始终在本地进行)。
相关链接:StudioForge(模型运行所用的GPU服务器)、如何利用本地AI代理来管理我的网站,以及如何让LLM将任何项目适配到您的系统中。