StudioForge:一款仅支持GPU运行的LLM服务器,成功取代了LM Studio
- 发布日期
- 2026年8月23日
- 更新日期
- 2026年9月16日
- 作者
- Jacob Lloyd —— 项目完成后,在 AI 协助下撰写
- 阅读时长
- 约 45 分钟阅读
简单来说: 这是一个运行在装有显卡的计算机上的程序。各类应用程序会向它请求人工智能相关的计算服务;它会判断某个模型适合在哪些显卡上运行,随后启动相应显卡、确保其在使用期间处于就绪状态,并在闲置时自动关机。一个模型要么能完全在显卡上运行,要么会被拒绝执行——绝不会出现只在较慢的处理器上部分运行的情况。该程序需要 NVIDIA 显卡才能工作,且在 Windows 系统上测试效果最佳。聊天应用、编程助手以及用户自编的脚本只需修改一个地址即可调用它。该程序免费且开源(遵循 MIT 许可协议)。
StudioForge是我编写的本地模型服务器,旨在替代我GPU主机上的 LM Studio。它负责管理 llama.cpp,在端口 1234 上提供 OpenAI API(特意选用了与LM Studio相同的端口),还配有浏览器控制面板以及恢复功能模块。此外,它还通过 MCP 发布管理接口,这样一来其他机器上的智能代理无需通过命令行即可操控该服务器。
我开发这个工具是因为LM Studio存在诸多令人头疼的问题:未配置路由路径时会出现 200 错误;无法查询当前实际加载了哪些模型;某些推理模型产生的输出内容超出了 8,192 个token的限制,而我的客户端配置其实并未要求这样的限制。最糟糕的情况是有些模型根本无法被裁剪,只能直接拒绝加载。虽然LM Studio的文档声称其“会自动减少GPU上的内存占用……剩余部分则存入系统RAM中”,但实际上该操作完全依赖系统RAM运行,却仍会返回成功状态。
如果您读过 关于dsh的介绍文章,就会知道其中提到的“本地GPU主机”指的就是这个服务器。我的 本地智能代理栈、DisPatch、MailForge 以及 InfoForge 也都是借助此服务器来获取模型。
简而言之:
- 简介:这是一款仅依赖GPU运行、兼容OpenAI API的服务器,底层基于 llama.cpp 的
llama-server。当前版本为 0.2.0,测试环境为 llama.cpp 的b10425版本及 NVIDIA CUDA 13.3。网关端口为1234,控制面板位于8080,监控服务端口为1235;每个被加载的模型都会对应一个子进程,这些进程的端口范围在18100–18200之间。 - 功能:首次调用时自动加载模型,并根据当时可用的显存容量来决定模型的上下文长度、KV缓存类型以及GPU资源分配方案。它会自动让暂时不用的模型进入空闲状态,同时维持那些被标记为“需常驻内存”的模型始终处于加载状态;若收到请求,还会将整个显卡分配给指定模型使用。0.2.0版本共提供了 29个 MCP 工具(其中19个用于管理,10个用于恢复功能)。
- 限制:绝对不会将计算任务转交给CPU处理。如果模型无法完全放入显存中,系统会直接拒绝加载该模型。除了从Hugging Face获取模型文件、从GitHub下载所需引擎及检查更新外,它不会发起任何外部请求;用户主动指定的图片链接也仅作展示之用。
- 运行要求:需要配备 NVIDIA 显卡且驱动版本为580系列或更高;还需安装 Python 3.12及以上版本、uv 工具以及存放GGUF格式模型文件的文件夹。如果您从未在本地运行过模型,可先阅读 这篇教程。
- 其他限制:仅支持 NVIDIA 显卡;Windows为官方推荐的运行平台。虽然Linux系统也经过持续集成测试,但我本人尚未完整验证过其引擎在Linux环境下的运行效果。整个软件采用 MIT 许可证发布,仅有一个LGPL协议的依赖项,相关说明详见 此处。
StudioForge并非什么:
- 它不是模型或计算引擎。 真正的数学运算由 llama.cpp 完成;StudioForge的作用只是决定哪个进程在哪些显卡上以何种参数运行。
- 它不是聊天应用。 界面上的“聊天”选项卡仅用于验证请求流程是否正常运行。
- 它不是纯CPU服务器。 整个代码库中
--n-gpu-layers参数的值始终被设定为999。 - 它也不是另一个独立的API服务。 系统并不提供 Ollama 或 KoboldCpp 风格的接口。用户能使用的只有 OpenAI 兼容接口、模仿LM Studio风格的
/api/v0端点以及用于管理的/apiREST接口。
对比情况
| LM Studio 0.4.21 | StudioForge 0.2.0 | |
|---|---|---|
| 引擎 | 自研的 llama.cpp 构建版本;在苹果设备上还使用了 MLX | 基于上游的 llama-server,使用一个固定版本的构建(b10425,CUDA 13.3),使用前已进行过简单测试 |
| 未匹配路径的处理方式 | 200 状态码伴随错误内容;其日志显示 Returning 200 anyway | 404 状态码并附带 JSON 响应体,任何状态下均返回 JSON 内容 |
| 错误处理方式 | 以文本形式返回错误信息,客户端需通过正则表达式解析 | 具备稳定的 error.code 字段;诊断信息则位于 error.studioforge |
| 配置加载机制 | 在两种加载路径中,context_length 参数在其中一种情况下被忽略;repetition_penalty 参数则被默默忽略 | 仅有一种加载路径,所有配置字段均被正确处理,实际生效值也会原样返回 |
| 资源不足时的处理方式 | 系统会“自动减小 GPU 上的显存占用量……剩余部分则使用系统 RAM” | 507 insufficient_vram 错误码,同时提供所需显存量、实际可用显存量、各 GPU 的空闲显存容量、可容纳的最大上下文长度以及相应建议 |
| 多 GPU 支持情况 | 支持优先级分配或平均分配,可单独控制每个 GPU 的使用情况;自 0.4.15 版本起支持张量并行 | 具备专门的规划器,可根据硬件情况确定上下文大小、KV 缓存类型以及各 GPU 上的资源分配方案 |
| 空闲超时设置 | 默认值为 60 分钟;自动清理机制最多只会保留一个通过即时编译加载的模型 | 1,800 秒(30 分钟)为默认空闲超时时间,在我的设备上该值设为 900 秒(15 分钟),每 15 秒执行一次清理;可同时保留多个模型 |
| 远程管理功能 | /api/v1 接口用于模型的加载、卸载与下载;LM Link 功能目前尚处于预览阶段 | /api REST 接口,sfctl 命令行工具,29 个 MCP 工具,可通过局域网或自建的虚拟专用网络进行远程管理 |
| MCP 支持情况 | 仅作为客户端使用(即它 调用 各类 MCP 服务器) | 自身即是一个 MCP 服务器,同时也为监控机制提供相应的 MCP 服务 |
| 源代码与授权方式 | 闭源软件;个人及企业内部使用均免费 | 开源软件,采用 MIT 许可证 |
上述关于 LM Studio 的信息均依据其更新日志、文档以及错误追踪系统进行核实,核实日期为 2026 年 8 月 23 日(当时最新版本为 0.4.21,发布于 2026 年 8 月 12 日)。其中第 2 条信息来自其公开的 Bug 跟踪系统;第 3、4 条则是我自己的客户端在 0.3.x 版本的 API 下遇到的实际问题;由于未在 0.4.21 版本中重新测试,故这些内容仅作为历史记录参考。
总体而言,LM Studio 是一款更出色的桌面端应用:它拥有精美的图形界面、对苹果芯片的 MLX 优化支持、兼容 Anthropic 协议的接口、配套的移动端应用且更新频率也很高。不过两者间真正的差异在于默认行为:LM Studio 会试图强行让模型运行起来;而 StudioForge 则会明确拒绝并说明原因。当由某个智能体来决定加载哪些模型时,这种差异便显得尤为重要——因为下游程序若不进行测量就无法区分“快速加载的模型”与“因资源不足而运行受限的模型”。
| 服务器 · 引擎 · 许可证 | 热加载/空闲超时设置 | 多 GPU 资源分配机制 | 是否拒绝向 CPU 借用资源 | 远程管理功能与 MCP 支持情况 |
|---|---|---|---|---|
| StudioForge 0.2.0 基于 llama.cpp,使用一个固定版本的构建 · MIT 许可证 | ✅ 支持即时编译加载;空闲超时时间为 1,800 秒,每 15 秒执行一次清理操作 | 可为每个模型单独规划资源分配方案,支持混合 GPU 配置、显存锁定与租赁机制 | ✅ 可通过 -ngl 999 与 --fit off 参数实现;出现资源不足时会返回包含具体数值的 507 错误码 | ✅ 提供 REST 接口以及 29 个 MCP 工具 |
| LM Studio 0.4.21 自研的 llama.cpp 构建版本且集成了 MLX 优化 · 闭源软件 | ✅ 支持即时编译加载;空闲超时时间为 60 分钟,自动清理机制最多只保留一个模型 | 支持优先级分配或平均分配;自 0.4.15 版本起还支持张量并行 | ❌ 系统会主动减少 GPU 上的显存占用量,剩余部分则使用系统 RAM 作为补充 | 提供 REST 接口;仅可作为 MCP 客户端 使用 |
| Ollama 0.32.15 基于 llama.cpp/GGML 引擎;苹果设备上还使用了 MLX 优化 · MIT 许可证 | ✅ 可通过 keep_alive 参数设置空闲超时时间,最长可达 5 分钟;每块 GPU 上最多可驻留 3 个模型 | 可自动将模型分配到各个 GPU 上运行 | ❌ 会出现向 CPU 借用资源的情况;在 ollama ps 命令的输出中会显示具体的 CPU 占用百分比 | 提供丰富的 /api/* 接口;但不具备 MCP 服务器功能 |
| llama-server 路由器(2026 年 8 月发布的 b105xx 版本) 基于 llama.cpp 引擎 · MIT 许可证 | ✅ 可为每个模型单独启动子进程;可通过 --sleep-idle-seconds 参数设置空闲超时时间,采用基于数量的 LRU 清理策略 | 需手动指定 -sm、-ts 或 -dev 等参数以完成配置 | ❌ 启用 --fit on 参数后会缩小原本规划好的资源分配方案 | 提供 /models/load|unload 接口以供调用 |
| llama-swap v251 作为代理程序可启动其他模型加载进程 · MIT 许可证 | ✅ 可为整个产品设置统一的空闲超时时间;也可针对单个模型或模型组单独指定 ttl 值 | ❌ 资源分配情况完全取决于用户指定的 cmd 参数内容 | 不适用(仅作为代理程序使用) | 提供 /ui 界面以及指向上游服务的路由配置 |
| vLLM 0.27.1 拥有独立的 PagedAttention 技术 · Apache-2.0 许可证 | ❌ 每个进程只能运行一个模型 | 支持张量并行、流水线并行以及专家并行机制 | 仅部分支持(不存在可向 CPU 借用资源的配置选项) | 仅支持 LoRA 技术;仅适用于“本地开发”场景 |
| KoboldCpp 1.119 基于 llama.cpp 的衍生版本,还支持图像与音频处理 · AGPL-3.0 许可证 | ✅ 可通过 --admin 与 --routermode 参数启用相关功能 | 需手动设置 --tensor_split 参数以完成资源分配 | ❌ 会出现向 CPU 借用资源的情况 | 提供 /api/admin/* 接口;仅可作为 MCP 客户端使用 |
| TextGen(原 oobabooga)4.9 集成了包括 ExLlamaV3、TRT-LLM 在内的 5 种模型加载器 · AGPL-3.0 许可证 | ✅ 无需重启即可切换当前运行的模型;具体空闲超时时间暂不明确 | 需手动设置 --tensor-split 参数以完成配置 | ❌ 会出现向 CPU 借用资源的情况 | 提供 /v1/internal/model/* 接口;仅可作为 MCP 客户端使用 |
| TabbyAPI(滚动更新版本) 仅支持 ExLlamaV3 引擎,不支持 GGUF 格式 · AGPL-3.0 许可证 | ✅ 可通过管理接口或在线方式加载模型;具体空闲超时时间暂不明确 | 默认启用 gpu_split_auto 机制以自动分配资源 | ✅ 该配置确实生效(因 ExLlama 引擎本身不存在可向 CPU 借用资源的路径) | 可通过管理密钥调用 /v1/model/load 接口 |
| Jan 0.8.4 具备 llama.cpp 路由器模式 · Apache-2.0 许可证 | ✅ 可通过路由器实现相关功能;具体空闲超时时间暂不明确 | 资源分配机制直接沿用 llama.cpp 的原生设置 | ❌ 会出现向 CPU 借用资源的情况 | 提供 /v1/orchestrations 接口;仅可作为 MCP 客户端使用 |
| LocalAI 4.9.0 提供超过 60 种后端服务,均以容器镜像形式提供 · MIT 许可证 | ✅ 支持按需加载模型;可通过 WATCHDOG_IDLE_TIMEOUT 参数自定义空闲超时时间 | 具备“自动适配 GPU 资源容量”的功能 | ❌ 官方宣传称“无需使用 GPU” | 提供 REST 接口与可视化 UI;仅可作为 MCP 客户端使用 |
| GPUStack 2.2.3 支持 vLLM、SGLang、MindIE、VoxBox 等多种引擎 · Apache-2.0 许可证 | 仅在特定场景下可用(如集群部署) | 可自动执行资源分配与 Binpack 优化操作,还支持跨多节点配置 | 暂不明确 | 提供完整的集群管理 API |
上述信息均于 2026 年 8 月 23 日从各官方渠道核实得出。带问号的内容表示“未知”,而非“不支持”。需注意:GPUStack 的 Worker 程序仅支持 Linux 系统;vLLM 目前也不具备原生的 Windows 平台支持。
- 即时编译加载与空闲超时机制其实并不罕见。 LM Studio、Ollama、llama-swap 以及 LocalAI 均具备这两项功能;其中 llama-swap 还提供了按模型组划分的
swap、exclusive与persistent等参数,堪称一套精巧的资源管理方案。 - 真正少见的特性主要有三项:一是拒绝向 CPU 借用资源(仅有 TabbyAPI 满足此条件,因 ExLlama 引擎本身不存在相关机制);二是能根据检测到的硬件情况自动规划上下文大小与各 GPU 上的资源分配方案;三是能将管理功能以 MCP 工具的形式对外提供——此类特性在同类型产品中实属罕见。
- 与之最为接近的竞品当属 llama.cpp 自带的路由器程序。该程序可隔离运行多个模型进程,属于免费软件且早已集成在 llama.cpp 的原生安装包中。不过它缺乏基于内存占用情况的自动清理机制(仅按数量进行清理)、显存锁定与租赁功能,也无法以带具体数值的形式反馈资源不足的情况。
与 LM Studio 的兼容性也是我们设计 StudioForge 时的核心考量之一。StudioForge 完整复刻了后者的端口设置、/v1/models 接口(用于列出已下载的模型)、即时编译加载机制、空闲超时设置、针对单个请求生效的 ttl 参数、publisher/repo/ 文件夹结构(该结构被直接沿用,方便两个程序共享同一套模型库)、/api/v0/models 镜像接口以及 lmstudio://open_from_hf 深度链接功能。因此用户只需修改主机地址即可将客户端顺利迁移至 StudioForge。不过由于两个程序无法同时占用 1234 端口,故在切换前需先关闭 LM Studio 或自行修改 server.port 参数。
各组件在何处运行
任何已经能够与 OpenAI 风格端点通信的程序,都只需要一个基础 URL 和模型 ID 即可:比如像 SillyTavern(聊天界面 → 自定义设置)、Open WebUI 以及 LibreChat 这样的前端应用;还有像 Continue、Cline、aider 以及 dsh 这类编程助手;任何语言下的 openai SDK;以及允许手动输入端点地址的自动化工具。只有 GPU 主机上才会安装任何组件。
| 组件 | 运行位置 | 用途说明 |
|---|---|---|
| 网关 | GPU 主机上,单个进程,端口 1234 | 提供 /v1、/mcp(含 19 种工具)以及 /api 接口。负责模型注册、调度及管理。 |
| 控制面板 | 与网关同属一个进程,由 uvicorn 独立服务,端口 8080 | 提供仪表盘、设置、模型管理、下载、聊天功能、服务器状态查看及日志浏览。 |
| 看门狗 | 独立的进程,端口 1235 | 自带一个包含 10 种恢复工具的 MCP 服务器。即便网关停止运行,它仍能继续工作。 |
llama-server 子进程 | 端口范围为 18100–18200,仅限本地回环访问 | 每个加载的模型对应一个此类子进程。某个子进程崩溃仅会影响对应模型,不会影响网关。由于这些子进程仅绑定到 127.0.0.1,因此网关才是唯一的对外接口。 |
sfctl 配套工具 | 运行在代理所在机器上 | 纯 HTTP 客户端(需 Python 3.11+,无需 CUDA),同时提供 stdio 形式的 MCP 桥接功能。 |
| GGUF 模型库 | 位于 models.dir 目录下,即原位置 | 直接在原位置被索引使用,无需复制。各后端进程均可直接读取其中的模型文件。 |
请求的处理流程
在请求的第一个字节发送之前,系统会检查客户端可能犯下的所有错误。若模型标识符无效,系统会返回带有 JSON 内容的 404 错误码;这是因为客户端通常能妥善处理此类错误,却容易忽略那些隐藏在 200 状态码的 SSE 数据流中的错误信息。以下是我服务器上 GET /health 命令的输出示例(已做简化):
{"status": "ok", "boot": {"phase": "ready", "ready": true},
 "engine": {"ok": true, "tag": "b10425", "variant": "cuda", "smoke_tested": true},
"gpu_count": 4, "models_indexed": 34, "can_serve": true}can_serve才是需要轮询的字段。status仅表明进程仍在运行;而在模型库扫描完成前,can_serve的值始终为 false。GET /health?deep=true命令会对所有已加载的模型执行一次包含 8 个 token 的测试请求;若没有任何模型被加载,系统则返回no_models_loaded而非正常响应。local-model参数同样可用。local-model、default、auto以及current这些标识符最终都会映射为models.default_model,因为 LM Studio 客户端默认会使用这个字符串作为模型名称。- 模型冷启动过程不会表现为系统卡死。 在加载过程中,数据流中会每隔五秒出现一次
: loading <model id> (5s)的提示信息,随后变为: prefilling …直至首个 token 生成。这些均属于 SSE 注释行,解析器会直接忽略它们,从而防止客户端触发读取超时机制。 - 整个服务器上同一时间只能加载一个模型。 若同时计划加载两个尚未加载的模型,它们会因争抢相同的显卡资源而导致其中一个因内存不足而启动失败。
- 请求中的
ttl参数仅影响空闲计时器而已。 该参数绝无可能用于锁定或解锁某个模型。
VRAM规划器
这是大多数本地服务器都会忽略的部分。core/planner.py(0.2.0版本中共有3,188行代码)在模型开始运行前会回答一个问题:根据当前各显卡上剩余的VRAM容量,该模型能够使用的最大窗口大小、最佳的缓存质量以及合适的插槽数量分别是多少?如果没有任何配置符合条件,又该如何给出拒绝响应呢?
上下文层级机制
首次运行时,当所用显卡的显存容量达到24 GB或以上时,tune_for_hardware会将最低层级值提升至16,384。规划器绝不会提议超过模型训练时所允许窗口范围的数值,因为那样需要启用RoPE缩放机制,且会导致模型质量下降。
之所以设置第二轮遍历机制,是因为曾发生过一次糟糕的加载案例:当时系统中有79,832 MB的显存处于空闲状态,另有19,423 MB被一个闲置模型占用。以这样的资源条件来看,使用q4_0格式的缓存时,最多可容纳262,144个token(所需显存为96,004 MB);而使用f16格式时则可容纳65,536个token(所需显存为95,236 MB)。然而实际加载的却是8,192个使用f16格式的token,占用了89,860 MB显存。旧版代码只允许置换最低层级的数据,导致模型不得不付出高昂代价才获得这个最小的窗口空间。
各层级的缓存质量设置方式如下:f16/f16 → q8_0/q8_0 → q8_0 K + q4_0 V。对称式q4_0格式已不再被任何自动配置流程所采用。当使用q4_0格式的K缓存时,Qwen2.5-7B模型最终生成的token数量仅为其使用f16格式时的11.7%;而使用q8_0/q8_0组合时,测得的KL散度值仅为0.0018。
KV缓存大小取决于模型架构
大多数显存计算器采用的公式为:层数 × 注意力头数 × 每个头的维度 × 2 × 字节数 × 上下文长度。该公式对Llama模型适用,但对另外两类常见模型则完全不适用。Gemma 3与4模型中,每6个层里仅有1个层使用完整KV缓存,其余5个层均采用滑动窗口机制且头维度仅为原值的一半。Qwen3.5、3.6及3.8模型中,full_attention_interval = 4,因此仅每4个层中有一个层拥有KV缓存,其余层均为状态固定的Gated-DeltaNet层。
计算错误会带来巨大代价。修复前,调度器估算出Gemma-4 31B模型在262,144个token时所需的KV缓存空间竟高达480 GiB,因此将模型可处理的上下文长度上限设为65,536。此后数周内,校准日志显示预测的所需显存为95,615 MB,而实际用量仅为40,037 MB。修复后,在两块5090显卡上运行该模型时,其完整加载所需的显存(含权重与KV缓存)约为38 GiB,这一数值意味着可支持的上下文长度提升了4倍;所有Gemma-4模型均因此受益。对Qwen3.5模型采用相同的错误计算方式也导致了显存占用被虚增了4倍。
若您自行编写相关估算程序,请务必严格照搬llama.cpp中的滑动窗口计算公式。若仅使用1.25倍的固定乘数,则在四个层中会导致估算值比实际值低3.6倍,进而引发加载时显存不足的问题。
我在四张不同类型的显卡上进行的测试
测试平台配备了两张 RTX 5090 和两张 RTX 3090。在驱动程序版本 610.88(CUDA 13.3)下,系统显示总显存为 111.7 GiB。调度器会优先尝试只使用单张显卡:因为在没有 NVLink 的情况下跨 PCIe 拆分计算任务会更慢,且整体速度受限于最慢的那张显卡。
| 配置方式(1.5B Q4_K_M 模型,8k 上下文长度,三次测试的平均值) | 生成速度 | 提示词处理速度 |
|---|---|---|
| 仅使用一张 3090 显卡 | 352.5 词/秒 | 2,803.6 词/秒 |
两张 3090 显卡,-sm layer 模式 | 344.4 词/秒 | 2,722.5 词/秒 |
两张 3090 显卡,-sm tensor 模式 | 294.3 词/秒 | 1,182.0 词/秒 |
两张 3090 显卡,-sm row 模式 | 失败:device CUDA2 does not support split buffers | |
单张显卡的表现优于双卡配置。对于这个小型模型而言,启用 Tensor 拆分模式会使生成速度下降 17%,而提示词处理速度则降低 58%。因此该模式属于可选设置,通常只有基准测试才会选用它。-sm row 参数虽能被解析器识别,但在 CUDA 环境下会出错;StudioForge 会在启动前阻止该参数的使用。
究竟需要运行多少个并行任务才算合理,则是另一个问题。需注意:在 llama.cpp 中,--ctx-size 参数所指定的数值是所有任务共享的 KV 缓存总量,而非每个任务的单独值。--ctx-size 4096 且未设置 --parallel 时,系统会显示 total_slots: 4,即每个任务可使用 1,024 个 token。StudioForge 则根据 ctx_per_slot × parallel 的值来启动相应数量的任务。
| 并行任务数 | 单个流的速度 | 整体速度 | p50 延迟 | p95 延迟 | 实际批量值 |
|---|---|---|---|---|---|
| 1 | 302.8 词/秒 | 302.8 词/秒 | 0.41 秒 | 0.41 秒 | 1.00 |
| 2 | 225.3 词/秒 | 425.3 词/秒 | 0.46 秒 | 0.49 秒 | 1.84 |
| 4 | 134.5 词/秒 | 436.0 词/秒 | 0.83 秒 | 1.00 秒 | 3.46 |
| 8 | 83.3 词/秒 | 576.9 词/秒 | 1.57 秒 | 1.77 秒 | 6.03 |
测试所用模型为 Qwen2.5-1.5B-Instruct Q4_K_M,仅使用一张 RTX 3090 显卡。每个任务可处理 8,192 个 token,KV 缓存采用 f16 格式。共启动了八个任务,提示词长度为 512 token,每个任务生成了 192 个 token。测试时间为 2026年8月19日。三次重复测试的结果误差均在 2% 以内。
为何此处单卡环境下的速度值为 302.8,而配置表中显示同一模型在同一显卡上的速度应为 352.5?其实这是两次不同的基准测试,所用设置也各不相同。本次测试中启动了八个任务并使用了特定的提示词长度与输出长度;因此应当对比同一表格内的各行数据,而非跨表比较。
- 预估值为 8 个任务;实测结果仅为 2 个。当任务数达到 4 时,每个流的速度降至单卡情况下的 44%。调度规则会选择 1、2、4 或 8 中能使各流速度保持在单卡速度的 65% 以上且整体速度提升至少 15% 的那个数值。
- 虽然每个用户的处理速度变慢了,但整体处理量仍在上升。启用 8 个任务后,总处理量达到了单卡情况下的 1.9 倍;不过此时每个对话的处理速度仅为单卡时的 27%。若单纯以整体处理量最大化为目标,则应选择 8 个任务,但这会使所有对话的处理速度大幅降低。
- 批量处理机制确实有效。实际批量值从 1.00 升至 6.03,说明各任务间存在共享的解码步骤,而非简单的队列排队机制。
在确信其有效性之前,我还测试了另外两个参数:
- 推测性解码仅对单个流有加速效果。在一张 RTX 3090 上运行带有 MTP 头的 Qwen3.8-27B Q5_K_S 模型并输入四条不同提示词后,未启用推测性解码时的速度为 37.75 词/秒;而启用
draft-mtp模式(深度为 3)后速度提升至 50.70 词/秒,增幅达 34.3%。不过若输入完全相同的提示词,则速度提升幅度高达 751%,这其实是提示词缓存带来的效果而非推测性解码的作用。当任务数超过 4 时,auto模式会自动关闭推测性解码功能。 - 更大的微批量处理能提升显存预填充速度。对于包含 5,166 个 token 的提示词而言,使用
-ub 2048参数后处理速度比默认的 512 设置快了 18.6%,不过所需显存也增加了 210 MiB。调度器会将该缓冲区大小向上取整,且仅在任务数超过 4 时才会自动提升-ub的值。
拒绝情况及相关数值说明
每次启动时都会添加参数 --fit off 与 --n-gpu-layers 999。这一操作很有必要,因为 llama.cpp 的 b10425 版本中,--fit 参数默认设为 开启,同时还有 --n-gpu-layers auto 选项(这两项更改均来自 PR #16653,2025年12月)。这两个设置共同构成了一种“部分卸载到GPU”的机制;虽然这对普通服务器而言是个合理的默认配置,但本项目却明确拒绝采用这种方式。当实在无法满足任何配置要求时,系统会返回 HTTP 507 错误码。以下为经过精简后的实际返回信息:
HTTP 507  {"error": {"code": "insufficient_vram", "message":
 "Cannot load '…/gemma-4-31B-it-QAT-Q4_0' entirely in VRAM: needs 29.09 GiB,
  20.90 GiB usable. … Suggestions: set KV cache type to q8_0 …;
  VRAM is held by other processes: …",
 "studioforge": {
   "required_bytes": 31235974510, "available_bytes": 22438368871,
   "per_gpu_free": {"3": 22438368871},
   "max_ctx_that_fits": null,
   "notes": ["wanted up to 262144 tokens of context but not even the 128000 floor
             fits in the VRAM available right now"],
   "estimate_mb": {"weights_bytes": 16818.2, "kv_bytes": 8575.0,
                   "compute_bytes": 2438.6, …, "total": 29788.9},
   "retry_after_s": null }}}
上述例子是尝试将31B规模的模型加载到一块 RTX 3090 显卡上时发生的情况。该提示信息面向的是人类用户;而 error.studioforge 则是供程序识别用的。若某个较小的配置方案能够满足需求,max_ctx_that_fits 便会给出具体数值。retry_after_s 仅在模型正忙时才被设置,因为其他情况下重试也无济于事。
固定模型、TTL与租约机制
模型会在首次被请求时加载,并在空闲时间超过设定的TTL后卸载(models.default_ttl_s,每15秒检查一次)。
“固定模型”是一种特殊状态。被固定的模型不会受到空闲计时器的影响,也绝不会被卸载。若该模型崩溃或在启动时失败,系统会自动重新加载它,重试间隔从60秒逐步延长至900秒。不过用户仍可手动强制卸载该模型;此时它会保持卸载状态,直到有人再次加载或将其设为固定模型为止。
“租约”机制则用于将特定显卡分配给某个模型。被租用的显卡对其他模型的分配请求不可见,且该模型只能使用这些指定的显卡。若试图获取已被其他模型占用的显卡,系统会返回 409 冲突错误,而不会允许强行接管。此外,租约机制还能为服务器外的程序预留显卡资源:例如 reserve_gpus(devices=[3], reason="ComfyUI render") 这条命令就能防止图像生成程序与语言模型争夺同一块显卡。
卸载操作不会影响任何固定模型、正在处理请求的模型、仍在加载中的模型,以及已被租用的显卡。后台的重平衡机制可能会将空闲模型重新分配到更合适的位置,但每30分钟内每个模型最多只能被移动一次——因为移动操作会导致提示词缓存失效。在我进行的长时间对话测试中,该缓存成功保存了包含98,000个标记符的提示词内容中的93%。
当一切出问题时
VRAM会随着占用它的进程一同被释放。 在 Windows 系统中,子进程存在于通过 JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE 创建的匿名作业对象中;因此无论父进程如何结束,内核都会将其杀死。Linux 系统则使用 PR_SET_PDEATHSIG,不过该机制只能尽力而为,因此需要借助启动时的扫描以及 reclaim_orphan_engines 来清理那些漏网之鱼。
为何需要这种扫描机制: 2026年8月18日时,两张显卡上共有约25 GB的显存被占用,但此时“所有进程均已停止”。这些显存占用者实际上是某个编程助手启动并随后弃置不管的测试任务所产生的三个 llama-server.exe 子进程。如今,每个占用VRAM的进程都会被标记为 ours、child-of-live-process、orphan、other-instance 或 foreign;只有标记为 orphan 的进程才会被强制终止。
退出代码具有特定含义: 2 表示配置错误,且会指明出错的配置项名称。3 代表端口冲突:此时管理程序会等待现有进程释放端口而非重新启动新进程。75 则表示有重启请求:服务器会先完成清理工作后再退出(实测耗时1.0秒),随后管理程序会重新启动它,且此过程不被视为崩溃。之所以这样设计,是因为此前有一次GUI端重启操作导致两个服务器同时尝试占用1234端口,致使管理程序将其中一个运行正常的服务器标记为“已崩溃”。
当网关陷入僵死状态而非完全失效时,可借助 1235 端口上的看门狗程序来处理。该程序仅由 argparse 与标准库日志模块构成,因此即便 config.yaml 配置有误也能顺利启动。它提供了十种功能:health、get_config、set_config、restart_server、kill_model、nuke_all_models、reclaim_orphan_engines、tail_logs、gpu_status 以及 rollback_update。该程序并不会调用任何用于修复操作的代码。
控制面板
运行在 8080 端口上的控制面板与主程序在同一进程中运行,且不使用绝对 URL,因此它既可通过普通 HTTP 访问,也能在 HTTPS 代理后正常使用。在 Windows 系统中,还有一个系统托盘图标。
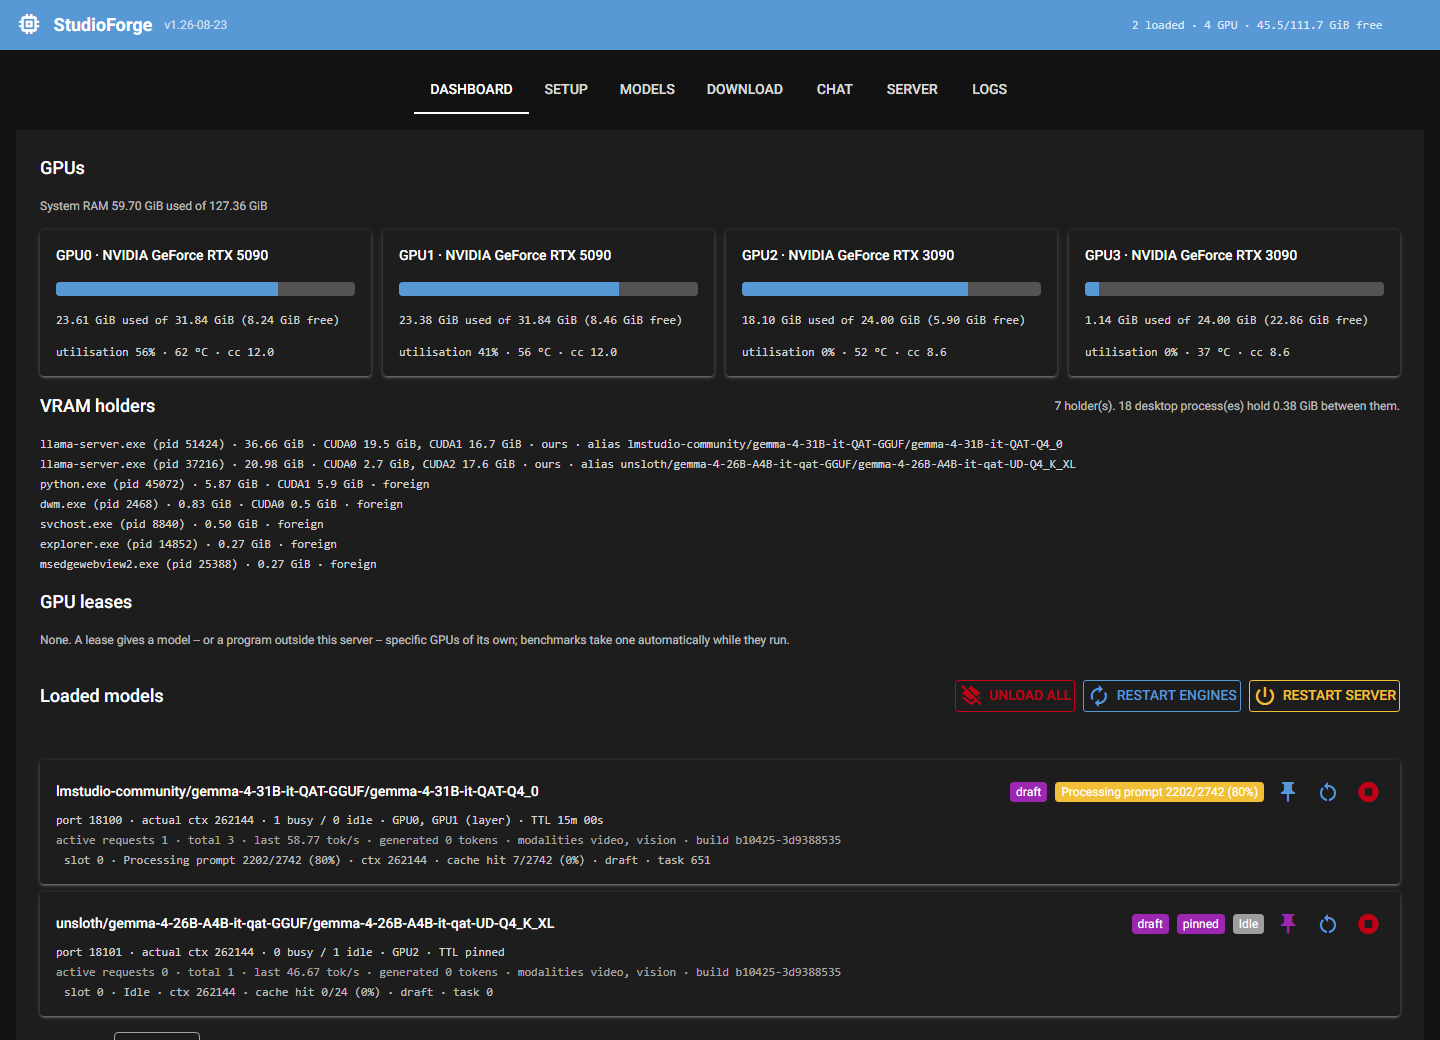
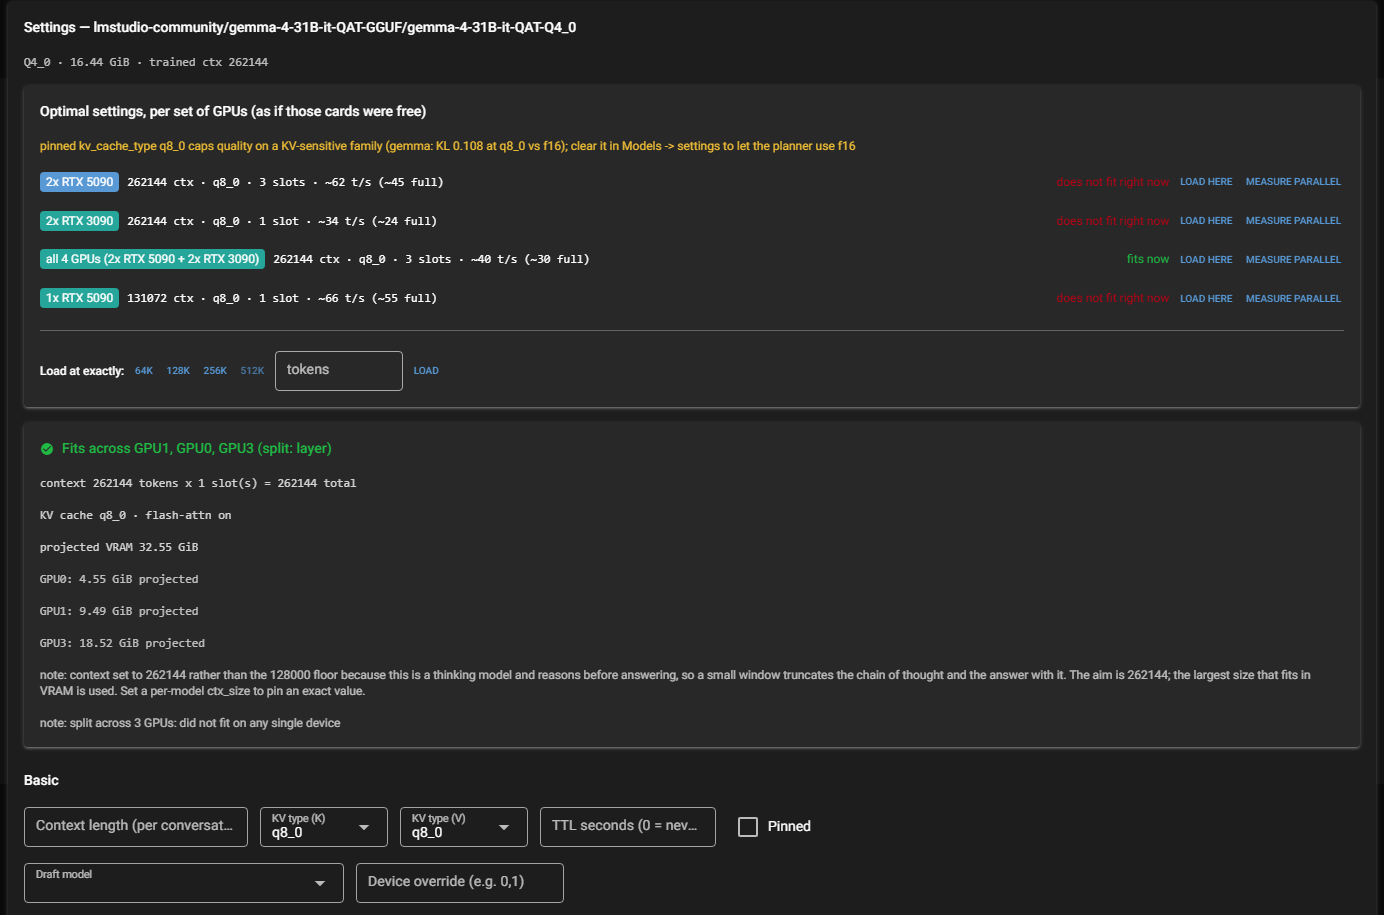
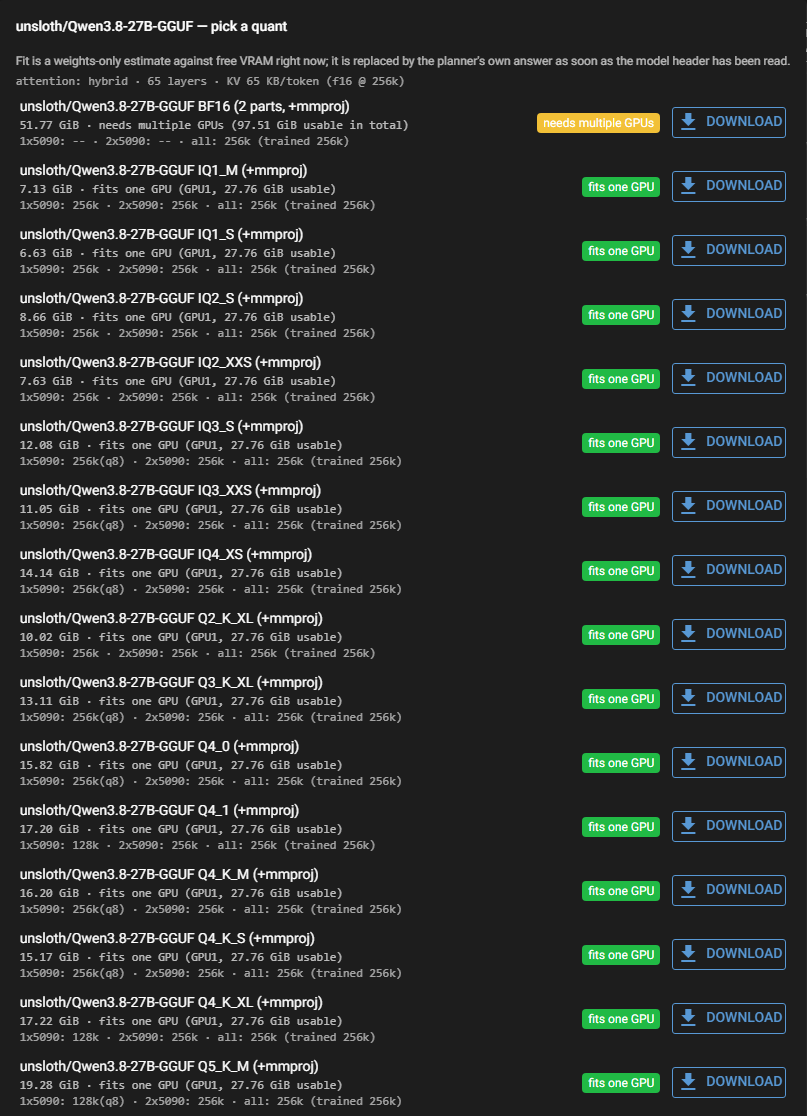
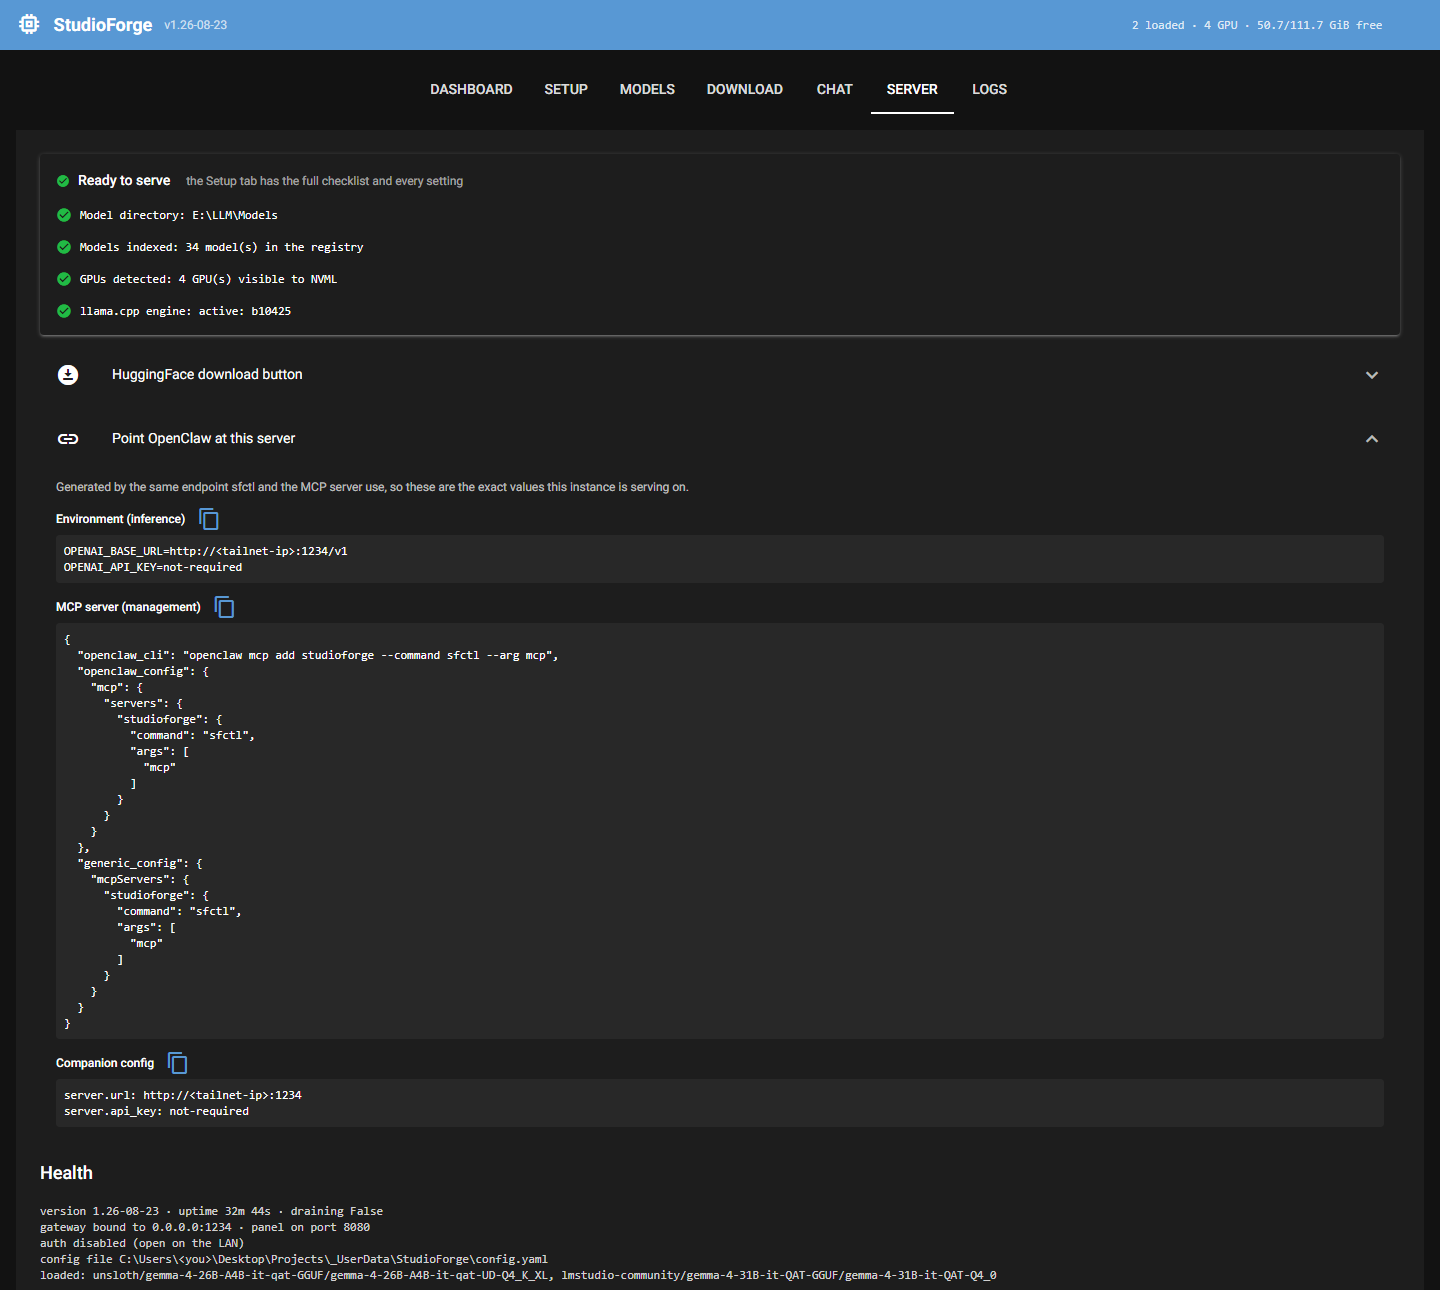
sfctl 运行的,因此配对所需的 PIN 码无需手动写入配置文件。将其用作 Harness 后端
推理与管理是两个独立的流程。任何客户端只需使用 /v1 即可,无需安装任何额外组件。唯有需要管理该设备的代理才需要使用 MCP 工具。
任何 OpenAI 客户端
server.api_key 默认值为 null,因此任何非空值都可以使用。不过大多数 OpenAI 客户端在检测到该值为空时会拒绝启动。
export OPENAI_BASE_URL=http://my-gpu-rig:1234/v1
export OPENAI_API_KEY=not-required        # any non-empty string while server.api_key is unset

curl http://my-gpu-rig:1234/v1/chat/completions -H "Content-Type: application/json" \
  -d '{"model": "<id from /v1/models>", "messages": [{"role": "user", "content": "hello"}]}'
GET /v1/models 会列出所有已下载的模型,格式类似 LM Studio;该接口还会返回每个模型的 state 状态,对于已加载的模型则还会提供 ctx_per_slot 与 max_parallel 信息。模型 ID 可以是完整的 publisher/repo/file 路径、纯文件名或 publisher/name,且不区分大小写。
在每个客户端中,基础 URL 的设置名称都不相同,这着实浪费了不少时间:Open WebUI 使用的是 OPENAI_API_BASE_URL;LibreChat 则采用一个 custom 端点,其中包含 baseURL 以及 models.fetch: true 参数;aider 使用 OPENAI_API_BASE,随后还需指定 --model openai/<id>;Continue 则需要设置 provider: openai 以及 apiBase。而 dsh 所使用的 OpenAI 配置块与其他服务器并无二致(即包含 baseURL 与 apiKeyEnv 参数);具体的 YAML 配置内容可参见 dsh 的相关说明文档。即便是不需要密钥的服务器,仍需在配置中提供某些认证信息,因为客户端始终要求提供 Bearer Token。
在另一台机器上运行 OpenClaw
代理机器会安装一个名为 sfctl 的小程序包。该程序需要 Python 3.11 才能运行,且不依赖于服务器包,因此无需安装 CUDA 和规划器。
sfctl servers add rig http://my-gpu-rig:1234 --api-key <PIN> --use
openclaw mcp add studioforge --command sfctl --arg mcp如果您手动编辑配置文件,请注意:OpenClaw的键名为 mcp.servers,该键位于 mcp 之下。扁平化的 mcpServers 结构则供 Claude Code、Cline 和 LibreChat 使用,而 OpenClaw的架构并不识别这种格式。推理相关的配置项位于 models.providers 下,其键名为 baseUrl,且其中的 rl 必须为小写形式:
// ~/.openclaw/openclaw.json
{ "mcp": { "servers": {
      "studioforge": { "command": "sfctl", "args": ["mcp"] } } },
  "models": { "providers": {
      "studioforge": {
        "baseUrl": "http://my-gpu-rig:1234/v1",
        "apiKey": "not-required",
        "api": "openai-completions",
        "models": [ { "id": "<id from /v1/models>", "name": "Rig 27B", "contextWindow": 131072 } ] } } } }
在 0.2.0 版本中,代理程序会看到 一个包含 29 个工具的合并列表:即网关提供的 19 个工具加上看门狗提供的 10 个工具。为避免命名冲突,三个看门狗工具被重命名为 recovery_*;而 restart_server 则保留原名称,因为错误信息中明确要求代理程序调用该工具。即便主服务器宕机,桥接程序仍会列出这些管理工具并附上说明,以便代理程序知晓它们的存在。以下是代理程序执行的循环流程:
list_models(limit=N):模型目录,按最新下载顺序排列。请仔细阅读推荐的那一行信息。load_model(**row["load_args"]):直接将该行数据原样传入即可。load_recommended(model_id, ctx_size=N):当您清楚自己所需的上下文大小时使用。该函数会拒绝请求,而不会强行缩小上下文大小。- 请通过 HTTP 执行推理,切勿使用 MCP。 若对尚未加载的模型调用此函数,系统会使用规划器的默认设置来加载模型,而非您所查看的那一行配置信息。
model_options(model_id):可获取各个上下文层级下的模型选项及其运行速度信息。search_models→repo_details→download_model:以此流程来获取新的模型。pin_model:用于指定必须始终能够响应的模型;reserve_gpus与release_gpus则用于预留或释放专用 GPU。server_status与connection_info:可查看当前已加载的模型、哪些进程占用了显存,以及服务器响应请求的所有地址信息。
每个客户端在连接时也会收到这条提示:
INFERENCE IS NOT HERE. This server exposes no chat/completion/generation tool
by design. To actually run a prompt, use the OpenAI-compatible HTTP API on the
gateway port (POST /v1/chat/completions, /v1/embeddings; GET /v1/models).
Naming an unloaded model in a request just-in-time loads it, so you usually do
not need load_model at all -- reach for it only to pre-warm a model or to load
one with non-default context/quantization settings.
Claude Code无法将此服务器用于自身的推理任务。 它所使用的网关协议是 Anthropic Messages、Bedrock 和 Vertex,而非 /v1/chat/completions。不过它仍能使用相关管理工具:claude mcp add studioforge -- sfctl mcp(必须使用 -- 参数)。
基准测试工具应当通过 POST /api/leases 来获取租约,等待正在忙碌的模型完成工作,然后再重新加载被挤占的资源。而我之前的脚本却执行了 pkill -f llama-server,这会直接终止所有后端进程。
代理会选择什么呢
目录中的每一行都对应一次实际的规划计算:判断某个模型当前能否适配可用的显存容量、可在哪些设备上运行、需要多少个显存槽位;同时还会判断在GPU处于空闲状态时是否也能适配(这样代理程序就能知道何时卸载模型会有帮助)。repo_details 通过 HTTP Range 请求远程读取 GGUF 文件头信息(每次仅下载 2–15 MB 的数据并缓存),而无需下载整个 20 GB 的文件;随后它会返回由该规划器计算得出的上下文适配矩阵。
| 数量 | 1× RTX 5090 | 2× RTX 5090 | 四张显卡全部使用 |
|---|---|---|---|
| BF16格式(51.8 GiB) | 权重无法容纳 | 可在q8_0格式下使用32k容量 | 256k容量 |
| Q8_0格式(27.9 GiB) | 无法使用 | 256k容量 | 256k容量 |
| Q5_K_M格式(19.3 GiB) | 可在q8_0格式下使用128k容量 | 256k容量 | 256k容量 |
| IQ2_M格式(10.5 GiB) | 256k容量 | 256k容量 | 256k容量 |
unsloth/Qwen3.8-27B-GGUF,此数据是在我的电脑上计算得出的。这些数值是指在 f16 精度下所能使用的最大缓存空间;“q8_0 精度”则仅在量化后的缓存能达到更大容量时才会出现。
量化精度对显存占用的影响其实比显卡数量更大:从 BF16 量化到 Q5_K_M后,原本“无法运行”的模型现在也能在单张显卡上以128k的批量大小运行了。若要优化模型性能,可先测试不同的部署方案,接着在效果最佳的配置上运行 benchmark_parallel,最后执行 reserve_gpus。
安装
Windows(推荐平台):
- 安装 Git、Python 3.12+、uv 以及最新版的 NVIDIA 驱动程序。
- 克隆代码库或解压下载的文件。
- 双击
launchers\Update StudioForge.bat。虽然名称如此,但这实际上是首次运行时的步骤:它会创建虚拟环境并安装、测试最新版 llama.cpp(该版本需与您的驱动程序兼容);您得到的版本号很可能比b10425更新。 - 运行
launchers\Start StudioForge.bat,或者选择launchers\StudioForge Tray.bat以启动系统托盘图标。控制面板会在http://127.0.0.1:8080处打开,在“设置”标签页下,“检测 LM Studio 模型库”功能会自动定位到您已下载的模型文件夹。
Linux 系统还需安装 cmake 以及版本与驱动程序相匹配的 CUDA 工具包(即包含 nvcc 组件的工具包)。由于上游项目并未发布适用于 Linux 的 CUDA 编译版,因此每次更新版本时都需要重新编译引擎代码。如前所述,我自己尚未完整测试过此安装流程。
git clone https://github.com/LaserLloyd/StudioForge.git && cd StudioForge
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python -e ".[dev]"
.venv/bin/studioforge serve --open # first run builds the engine对于无显示器的服务器环境,deploy/ 目录下提供了两个 systemd 用户级服务单元;这些服务必须由拥有模型库、虚拟环境及 GPU 设备访问权限的用户来运行。其中的监控单元设置了 Restart=always 参数,且不受网关服务影响,因此即便网关宕机它仍能持续运行。请执行 sudo loginctl enable-linger "$USER" 命令,以便这些服务能在用户未登录的情况下自动启动。
| 服务名称 | 默认端口 | 配置参数名 |
|---|---|---|
网关服务(/v1、/api、/mcp) | 1234 | server.port |
| 网页控制面板 | 8080 | gui.port |
| 故障恢复监控程序 | 1235 | watchdog.port |
llama-server 子进程(仅限本地回环地址) | 18100–18200 | gateway.child_port_start / _end |
配置验证机制会拒绝那些与子进程端口范围相冲突的服务端口。数据存储目录的查找优先级依次为:SF_DATA_DIR 环境变量指定的路径、--config 参数指定的文件夹,最后是 <repo>/data;具体说明请参见 docs/SETUP.md。同一时间只允许有一个实例占用某个数据目录,这是通过操作系统的独占锁机制来实现的。
安全性
规则如下:读取、推理及加载操作始终允许;修改配置则需提供凭证。 当 server.api_key 未设置时,任何试图修改配置、重启服务、更新组件、回收显存、下载内容、租赁资源或删除数据的请求,仅允许来自同一台机器的调用,或者必须附带 MCP PIN(位于 X-MCP-Pin 头中)或相应的 Bearer Token。其他任何情况都会返回 403 remote_admin_requires_credential 错误。
- PIN 仅用于保护 MCP。 它是启动时显示的配对码,并非 API 密钥。
server.api_key才是真正的凭证,默认未设置。 设置后它即可用于/v1、/api、/mcp以及监控模块的验证。- 默认情况下,所有监听端口均绑定到
0.0.0.0。 只要任一监听端口未设置密钥,设置界面中的“网络暴露”栏就会显示为琥珀色。务必先设置好密钥再将其公开。 - 跨域浏览器请求即便发往本地回环地址也不被视为本地请求。 否则任何网页都能通过
PATCH /api/config对127.0.0.1:1234进行操作。源验证会检查端口信息,且将Origin: null视为外部来源。远程浏览器无法获取该 PIN。 - 图片 URL 的获取过程受到 SSRF 防护机制的限制,该机制会阻止对回环地址、链路本地地址、私有地址、ULA 地址以及 CGNAT 网络(即
100.64/10网段,Mesh VPN 节点所在区域)的访问,随后才向经验证的地址发起请求。
有两个限制需要注意:其一,同机检查机制会信任所有发往回环地址的请求,但在反向代理背后该地址实际指向的是代理服务器本身,因此必须将代理置于 server.api_key 的保护之下;其二,系统中仅存在一个共享密钥,既无账户体系也无速率限制。建议将该密钥仅用于经过身份验证的代理环境或 Mesh VPN 网络中,切勿在公网上使用。
限制说明
- Windows是参考平台。 系统托盘功能、显存使用量监控机制以及各进程的GPU计数器均是在Windows平台上实现的。Linux平台也可运行(参见安装说明)。macOS则不受支持(无CUDA支持)。
- 仅支持NVIDIA显卡。 调度器通过NVML接口获取数据,而引擎本身也是基于CUDA构建的。
- 显存占用数值仅为估算值。 模型权重所占空间约为文件大小的2%左右;各层所需的显存量也可精确计算得出。不过实际计算缓冲区的大小是经过校准后的近似值(范围限定在0.03至0.15之间),该数值会保留在内存中,重启后重置。
- 多GPU分配是按比例进行的,并无实际测量。 系统并未对GPU间的互连带宽进行建模;当使用不同代次的显卡时,整体运行速度会以较慢的那块显卡为准。
- 速度估算值基于厂商提供的数据,而非实测结果。 在我的设备上,一个31B规模的模型实测速度为39.4 tok/s,而预估值为36.1;另一个122B规模的MoE模型实测速度为37.3 tok/s,预估值则为47.4。
- 为其他程序预留GPU资源只会限制本调度器的使用。 这并不会阻止其他程序或第三方软件占用该显存资源。
- 许可协议相关说明。 StudioForge采用MIT许可证。用于绘制Windows系统托盘图标的pystray组件则遵循LGPL-3.0协议。通常情况下该组件会作为独立包安装,此时只需保留其许可声明即可。若需将所有组件打包为单个可执行文件,则需随软件一同分发pystray的源代码或将其保留为独立模块。
- 目前尚无其他人员对代码进行过审核。 上述内容仅为我对自身代码的说明,因此在将本工具用于重要任务前,请务必自行检查源代码。
在我的电脑上,共运行了2,503项单元测试,其中17项被跳过;整个过程耗时327秒。CI系统也会在Windows与Ubuntu平台上使用模拟GPU后端来执行这些测试。另一套测试流程则是在真实的GPU上加载实际模型进行测试;该流程默认处于关闭状态,需设置相应环境变量才能启用——这也是为了避免前述“显存占用异常”问题的发生。
注意事项
- 启动前请先退出 LM Studio。 两者都需要使用 1234 端口。预检程序会指定端口持有者;
server.port则用于指定 StudioForge 所使用的端口。共享模型文件夹并无问题。 --ctx-size的值是指所有插槽的总上下文长度,而非单个插槽的长度;此外上层的--fit参数默认处于开启状态。 如果您直接运行llama-server,则需自行设置--fit off并指定每个插槽的上下文大小。- 在
--reasoning-format auto模式下,推理模型可能会返回空回复。 同样的提示词下:当设置为auto时,content字段的内容长度为 0 字符,而reasoning_content的长度则为 316 字符;设置为none时,content的长度变为 323 字符。由于reasoning_content并不在 OpenAI 的协议规范中,因此普通客户端根本看不到该内容。除非您的客户端支持读取该字段,否则请使用none模式。 - 切勿通过树状方式终止托盘进程。 在 venv 启动器环境下,监控程序与主进程同属一个进程树;若以这种方式强制重启,会导致服务器与监控程序同时停止运行。请使用托盘菜单、控制面板或
sfctl recover --restart命令来重启。 - 从其他工具中执行
pkill -f llama-server会终止所有后端服务。 建议改用获取 GPU 租约的方式来处理。 - NVML 中的
busId数值是以十六进制表示的。 例如"00000000:42:00.0"对应的总线编号即为 66;若将其当作十进制数处理,则会导致 VRAM 被错误地分配到其他显卡上,且不会出现任何错误提示。 - 在推测性解码基准测试中反复使用同一提示词实际上是在测试提示词缓存机制。 请使用不同的提示词进行测试。
/props命令在生成过程中显示的speculative.types: "none"仅为临时状态,因此应参考实际完成生成后的timings.draft_n数值。 - 视觉模型无法从提示词缓存机制中获益。 llama.cpp 会禁用多模态模型的缓存复用功能;默认情况下每张图片都会占用 1,024 个 token,因此即便窗口大小设为 8K,很快也会被占满。
获取方式
GitHub上始终提供最新版本, 其中包含测试代码、文档、启动器以及 systemd 服务单元:
github.com/LaserLloyd/StudioForge
git clone https://github.com/LaserLloyd/StudioForge.git此压缩包的版本号为 0.2.0:对应的代码为 main 分支下的提交 d7e5d26(2026年8月25日)。dist/ 目录中还包含了两个软件包的预编译包与源代码压缩包。本文所述的所有内容(29个工具、各个面板及规划器)均基于该版本。自那时起,GitHub上的 main 分支有了更新,新增了两个管理工具:plan_load 与 check_loaded_model,目前总共拥有31个工具。该压缩包的 SHA-256 值如下:
72e3b44487645e7790ba8497e029868e07ca340f67c92f1834345d4e50839f6d studioforge-2026-08.zip此压缩包仅包含受版本控制管理的文件(不含 config.yaml 以及 data/ 目录)。许可协议:MIT: 可自由使用、修改、分发或出售,但需保留版权声明且不提供任何担保。
发现了bug?我的邮箱信息可在 关于页面 找到。提交问题时,请提供 error.code、507错误相关的数值以及 logs/models/<model>.log 文件的最后20行内容。请务必隐去PIN码与任何密钥信息。如果您能贡献用于联合装箱规划的代码、采样器预设配置或是针对AMD平台的优化方案,我们也将不胜感激。
这样做到底对我有什么帮助呢?
实际上,这个项目的大部分工作都是测量分析,而非编写代码。那个规划器本质上只是些简单的算术运算而已,任何人都能写出来。直到我仔细研究了 llama.cpp 中真正的 KV 缓存布局结构,并经过实际测量发现最佳的缓存槽数量应为 2,而我最初的估算却是 8,这个规划器才真正变得可靠起来。如果你已经在 1234 上运行了 LM Studio,那么尝试这个方法只需克隆代码库、创建一个批处理文件,再把 models.dir 指向你已有的模型文件夹即可。如果最终证明该方法并不值得使用,你的原有配置也丝毫不会受到影响。
相关链接:DeepSeek Harness (dsh)(该工具能将此服务器当作普通的 OpenAI 服务提供端来调用);bench-llm / CrucibleForge(目前可支持 GPU 租赁服务的基准测试工具);我的 OpenClaw 配置说明(首次提出该问题的文章);以及 DisPatch(位于最前端的聊天应用程序)。
下载
仅限个人使用免费。如果它替你省下了一下午的时间,欢迎点旁边的咖啡按钮支持一下。