StudioForge:LM Studioに代わって登場した、GPU専用のLLMサーバーです
- カテゴリ
- AIとローカルLLM
- 公開日
- 2026年8月23日
- 更新日
- 2026年9月16日
- 著者
- Jacob Lloyd — プロジェクト完了後、AIの支援を受けて執筆
- 読了時間
- 約55分で読めます
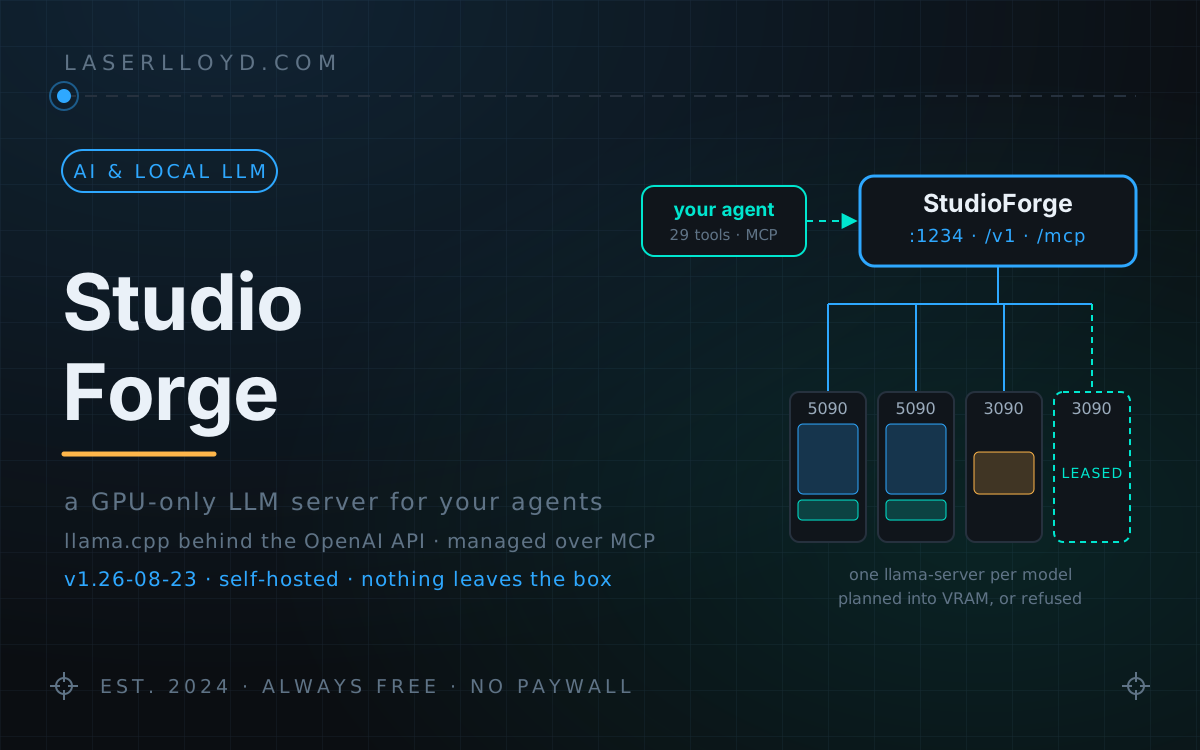
かんたんに言うと: グラフィックスカードを搭載したコンピュータ用のプログラムです。アプリケーションからAI処理の依頼があった際、どのグラフィックスカードでモデルを実行できるかを判断し、処理を開始します。使用中は準備状態を維持し、アイドル状態になればシャットダウンします。モデルは、すべての処理がグラフィックスカード上で行われるか、あるいは実行が拒否されるかのどちらかであり、決して遅いプロセッサ上で部分的にだけ実行されることはありません。NVIDIA製のグラフィックスカードが必要であり、Windows環境での動作確認が最適です。チャットアプリやコーディングアシスタント、またご自身のスクリプトからも、単にアドレスを変更するだけで利用可能です。無料かつオープンソース(MITライセンス)です。
StudioForgeは、私が自作したローカルモデルサーバーで、自分のGPUマシン上でLM Studioに代わるものとして利用しています。このサーバーは llama.cpp を管理し、ポート 1234 上でOpenAI APIとして機能します(意図的にLM Studioと同じポート番号にしています)。また、ブラウザベースの管理パネルや復旧用のサイドカーも備えており、MCP を通じて管理機能を公開しているため、別のマシン上にあるエージェントがシェル操作なしでこのサーバーを制御することも可能です。
GitHubでソースコードをご覧ください またはZIPファイルをダウンロードする
私がこれを作ったのは、LM Studioで度重なる予期せぬ挙動に悩まされたからです。例えば、未定義のパスに対して 200 というエラーコードが返されることや、実際にどのモデルが読み込まれているかを確認する手段がないこと、さらにクライアント設定上は8,192トークンまでしか想定していなかったのに推論用モデルがそれを超えてしまう事象などです。最も問題だったのは、本来なら分割して利用可能なはずのモデルが拒否されてしまった点です。LM Studioのドキュメントには「自動的にGPUへの割り当て量を減らし、残りをシステムRAMに配置する」と記載されていますが、実際にはシステムRAM上で処理されるため速度が落ちるにもかかわらず成功と報告されるのです。
dshに関する解説記事をお読みいただければ、「Local GPU rig」という項目がまさにこのサーバーであることが分かります。また、私が作った ローカルエージェントスタック、DisPatch、MailForge、InfoForge といったプログラムもすべてこのサーバーからモデルを呼び出しています。
要約
- 概要: GPU専用のOpenAI互換サーバーで、llama.cppの
llama-serverを基盤としています。バージョンは 0.2.0 で、llama.cppのビルド番号b10425(CUDA 13.3)上で検証済みです。ゲートウェイは1234、管理パネルは8080、監視用ポートは1235となっており、読み込まれた各モデルごとに18100–18200番台のプロセスが生成されます。 - 機能: 初回利用時にモデルを読み込み、その時点で空きVRAM量に応じてコンテキスト長やKVキャッシュの種類、GPU配置、使用するスロット数などを自動選択します。不要なモデルはアイドル状態にし、必要なモデルは常にメモリ上に保持し続けます。また、要望があれば1つのモデルに対してGPUカード全体を割り当てることも可能です。バージョン0.2.0では 29種類のMCPツール(管理用19種、復旧用10種)を提供しています。
- しないこと: CPU側にデータを流出させません。モデルがVRAM容量内に収まらない場合は、単純に利用不可として処理します。Hugging Faceからのモデル取得、GitHub上のエンジンや更新情報の確認、任意で有効化可能なリリースチェック、そしてユーザーの指定した画像URLへのアクセス以外には外部通信を行いません。
- 必要条件: 580シリーズ以降のドライバーがインストールされたNVIDIA製GPU、Python 3.12以上、uv、そしてGGUF形式のモデルファイルが必要です。これまでローカルでモデルを動かした経験がない方は、こちらの手順から始めてください。
- 制限事項: NVIDIA製品のみ対応しています。Windowsが標準プラットフォームです。LinuxもCI環境でテスト済みですが、私自身はLinux向けのエンジンソースコードを完全にビルドしたことはありません。ライセンスはMITで、LGPLライブラリが1つ存在しますがこれも 制限事項 の範囲内で扱われます。
なお、StudioForgeは以下ではありません:
- モデルやエンジンそのものではない。 実際の計算処理はllama.cppが行い、StudioForgeはどのプロセスがどのフラグを使ってどのGPUカード上で動作するかを決定します。
- チャットアプリではない。 チャットタブは実際のリクエスト経路が正常に機能していることを確認するためだけに用意されています。
- CPU専用サーバーでもない。 コードベース全体において
--n-gpu-layersの値は常に999となっています。 - 別種のAPIでもない。 OllamaやKoboldCpp用のエンドポイントは存在しません。提供されるのはOpenAI互換インターフェース、LM Studio風の
/api/v0ミラー、そして/apiを通じた管理用REST APIのみです。
比較の仕方
| LM Studio 0.4.21 | StudioForge 0.2.0 | ||
|---|---|---|---|
| エンジン | 独自のllama.cppビルドおよびApple向けのMLXを使用 | アップストリームのllama-serverを利用。特定のビルド(b10425、CUDA 13.3)を用い、使用前に動作確認済み | |
| 未定義パスへの応答 | 200を返すがエラー内容も含まれる。ログには「Returning 200 anyway」と記載 | 404を返し、JSON形式のレスポンスが常に返される | |
| エラー表現 | クライアント側で正規表現を用いて解析するテキスト形式 | 安定したerror.code値があり、診断情報はerror.studioforge内に記載される | |
| 設定読み込み | 2つの読み込みパスのうち1つではcontext_lengthが無視され、repetition_penaltyも黙って無視される | 1つの読み込みパスのみで、すべての設定値が適用され、実際に使用される値も返される | |
| VRAM不足時の挙動 | 「自動的にGPUオフロードサイズを縮小し、残りはシステムRAMを使う」と説明されている | 507 insufficient_vramというエラーが返され、必要なバイト数や利用可能なVRAM量、各GPUの空き容量、収容可能な最大コンテキスト長、対処法などが示される | |
| マルチGPU対応 | 優先度設定や均等分割、0.4.15以降ではテンソル並列化も可能 | 各モデルのコンテキストサイズやKVキャッシュの種類、配置スロット数を自動的に計算するプランナーが存在する | |
| アイドル状態でのTTL | 60分間。その後は最大1つのJIT読み込み済みモデルのみ保持される | 初期設定では1,800秒(30分)。筆者の環境では900秒(15分)となっており、15秒ごとにクリーンアップが行われる。収容可能な数だけモデルを保持できる | |
| リモート管理機能 | /api/v1経由での読み込み・アンロード・ダウンロードが可能。LM Linkもプレビュー段階で利用可 | /apiによるRESTインターフェースやsfctl CLI、29種類のMCPツールがあり、LAN内または自前のVPN経由でも管理可能 | |
| MCP対応 | ホスト側のみ(MCPサーバーを利用するだけ) | MCP サーバーとして自身の管理に使われ、監視用にも別途1つ存在する | |
| ソースコード | 非公開。個人利用および社内業務利用は無料 | オープンソースで、MITライセンスが適用される |
LM Studioに関する情報は、2026年8月23日にその変更履歴、ドキュメントおよびバグ追跡システムを確認したものです(バージョン0.4.21、2026年8月12日リリース)。2行目の内容は公開されているバグトラッカーにも記載されています。3行目および4行目は筆者が0.3.x版のAPIを利用する際に対処が必要だった事項です。0.4.21では再検証していませんので、単なる履歴情報としてご理解ください。
LM Studioは洗練されたGUIやApple Silicon向けのMLXサポート、Anthropic互換エンドポイント、モバイル用アプリ、頻繁な更新といった点で優れたデスクトップアプリです。しかし実際の違いは「デフォルトの挙動」にあります。LM Studioはとにかくモデルを動作させようとしますが、StudioForgeはそうではなく、なぜ動作しないのかを明確に伝えます。エージェントが読み込むモデルを決定する際にはこの点が重要です。というのも、下流側の処理では速度や正常性を測定しなければ、高速に動作しているか不具合があるかを判断できないからです。
| サーバー・エンジン・ライセンス | ホットスワップ/アイドルTTL | マルチGPU配置 | CPUへのフォールバックを拒否 | リモート管理/MCP |
|---|---|---|---|---|
| StudioForge 0.2.0 llama.cpp、特定ビルド使用・MITライセンス | ✅ JIT対応・1,800秒のTTL、15秒ごとにクリーンアップ | モデルごとに配置計画が可能。異なるGPUカード間でも配置可。ピン留めやリース機能も備える | ✅ -ngl 999および--fit offにより拒否可能。507エラーには数値情報も含まれる | ✅ RESTインターフェースおよび29種類のMCPツールを提供 |
| LM Studio 0.4.21 独自のllama.cppおよびMLX使用・非公開ソース | ✅ JIT対応・60分間のTTL。その後は最大1モデルのみ保持される | 優先度設定や均等分割、0.4.15以降ではテンソル並列化も可能 | ❌ オフロードサイズを縮小し、残りをRAMに保存する仕様 | RESTインターフェースのみ。MCPはホスト側としてのみ対応 |
| Ollama 0.32.15 llama.cpp/GGML使用、Apple向けにはMLXも利用・MITライセンス | ✅ keep_aliveにより5分間維持。各GPUにつき3モデルまで常駐可能 | 自動的に複数のGPUカードに分散配置される | ❌ CPUへのフォールバックが発生し、ollama psではCPU使用率も表示される | 豊富な/api/*エンドポイントを備えるが、MCPサーバーは存在しない |
| llama-serverルーター(b105xx、2026年8月版) llama.cppベース・MITライセンス | ✅ モデルごとに子プロセスが生成され、--sleep-idle-secondsにより制御可能。数に基づくLRU機能も備える | -sm、-ts、-devを手動で指定する必要がある | ❌ --fit onを有効にすると計画が縮小されてしまう | /models/load|unloadエンドポイントが存在する |
| llama-swap v251 他のプロセスを起動するプロキシ・MITライセンス | ✅ 製品全体でTTL制御が可能。モデルまたはグループごとにttl設定も可 | ❌ cmdで指定された内容に従うだけ | n/a(プロキシのみのため) | /uiおよび上位ルーターとの連携が可能 |
| vLLM 0.27.1 独自のPagedAttention実装・Apache-2.0ライセンス | ❌ プロセスごとに1モデルのみ扱える制限あり | テンソル並列化、パイプライン並列化、エキスパート並列化が可能 | 部分的(レイヤー単位でのオフロード経路なし) | LoRAのみ対応で「ローカル開発用」という位置付け |
| KoboldCpp 1.119 llama.cppのフォーク版で画像・音声対応・AGPL-3.0ライセンス | ✅ --adminおよび--routermodeにより制御可能 | --tensor_splitを手動で指定する必要がある | ❌ CPUへのフォールバックが発生する | /api/admin/*エンドポイントがあり、MCPクライアントとしてのみ機能 |
| TextGen(旧oobabooga)4.9 ExLlamaV3やTRT-LLMなど5種類のローダーを備える・AGPL-3.0ライセンス | ✅ 再起動なしで切り替え可能。TTLは不明 | --tensor-splitを手動で指定する必要がある | ❌ CPUへのフォールバックが発生する | /v1/internal/model/*エンドポイントがあり、MCPクライアントとして機能 |
| TabbyAPI(ローリング版) ExLlamaV3のみ対応でGGUF非対応・AGPL-3.0ライセンス | ✅ 管理者機能およびインライン読み込みが可能。TTLは不明 | gpu_split_autoがデフォルトで有効 | ✅ ExLlamaにはCPU経路が存在しないため実質的に拒否される | 管理者用キーにより/v1/model/loadが利用可能 |
| Jan 0.8.4 llama.cppルーター機能を備える・Apache-2.0ライセンス | ✅ ルーター経由で制御可能。TTLは不明 | llama.cppからの設定を引き継ぐ | ❌ CPUへのフォールバックが発生する | /v1/orchestrationsエンドポイントがあり、MCPクライアントとして機能 |
| LocalAI 4.9.0 60種類以上のバックエンドがコンテナイメージとして利用可能・MITライセンス | ✅ 必要に応じて読み込みが可能。WATCHDOG_IDLE_TIMEOUTも設定可 | 「自動的にGPUモデルサイズを調整する」機能がある | ❌ 「GPUは不要」という説明があるものの実際には使用される | RESTインターフェースおよびUIがあり、MCPクライアントとしてのみ機能 |
| GPUStack 2.2.3 vLLM、SGLang、MindIE、VoxBoxをサポート・Apache-2.0ライセンス | 部分的(クラスター展開時のみ) | 自動的にSpread/Binpack処理が行われ、複数ノードにも対応 | 不明 | クラスター全体を管理するAPIが完備されている |
2026年8月23日に主要な情報源から確認した内容です。疑問符は「不明」を意味し、「不可」ではありません。GPUStackのワーカーはLinux専用であり、vLLMにはネイティブなWindowsサポートがありません。
- JIT読み込みやアイドルTTL自体は目新しい機能ではありません。 LM Studio、Ollama、llama-swap、LocalAIも同様の機能を備えています。特にllama-swapが提供するグループ単位での
swap、exclusive、persistentフラグは非常に便利なポリシー制御機能です。 - 珍しい機能は3つあります。 まずCPUへのフォールバックを拒否する点(これに該当するのはTabbyAPIのみで、ExLlamaにはCPU経路が存在しないためです)。次に利用可能なGPUカードの特性に基づいてコンテキストサイズやスロット数を自動計算するプランナー。最後にMCPツールとして管理機能を公開している点で、他には類似例が見当たりません。
- 最も近い競合はllama.cpp自体のルーターです。 複数のモデルをプロセス単位で分離して実行でき、無料で利用可能かつ既にバイナリ内に含まれています。ただしメモリベースのクリーンアップ機能がなく(数に基づく制御のみ)、ピン留めやリース機能、数値情報を伴う拒否応答も備えていません。
LM Studioとの互換性は設計上の制約条件でした。StudioForgeでは、モデル一覧を表示する/v1/modelsエンドポイント、JIT読み込み機能、アイドルTTL設定、リクエスト単位でのttl制御、ライブラリ共有用のpublisher/repo/フォルダ構成(両プログラムで同一ライブラリを共有できるように)、/api/v0/modelsミラー機能、さらにはlmstudio://open_from_hf形式のディープリンクも実装しています。クライアント側からの切り替えはホスト名を変更するだけで済みます。ただし両プログラムが同時にポート1234を占有できないため、LM Studioを終了させるかserver.portの値を変更する必要があります。
どこで何が動作するか
既にOpenAI形式のエンドポイントと通信可能なアプリケーションには、ベースとなるURLとモデルIDが必要です。例えば、SillyTavern(チャット機能→カスタム設定)、Open WebUI、LibreChatといったチャットフロントエンド;Continue、Cline、aider、dshといったコーディングアシスタント;あらゆる言語用のopenai SDK;そしてエンドポイントを手入力できる自動化ツールなどです。インストール作業が必要なのはGPUホストのみです。
| 構成要素 | 配置場所 | 用途 |
|---|---|---|
| ゲートウェイ | GPUホスト上で1つのプロセスとして動作し、1234番ポートを使用 | /v1、/mcp(19種類のツール)、/apiを提供します。レジストリ、プランナー、スーパーバイザーの役割も担います。 |
| コントロールパネル | 同一プロセス内でuvicornが別途起動し、8080番ポートを使用 | ダッシュボード、設定画面、モデル管理、ダウンロード機能、チャットインターフェース、サーバー情報、ログ表示などが利用できます。 |
| ウォッチドッグ | 完全に別個のプロセスとして動作し、1235番ポートを使用 | 独自のMCPサーバーと10種類の復旧ツールを備えています。ゲートウェイが停止しても継続的に稼働します。 |
llama-server子プロセス群 | 18100–18200番ポートで、ループバック通信のみ利用 | 読み込まれた各モデルごとに1つずつ起動します。いずれかの子プロセスがクラッシュしてもゲートウェイには影響しません。子プロセスは127.0.0.1にのみバインドするため、公開用エンドポイントはゲートウェイのみとなります。 |
sfctlコンパニオン | エージェントが動作するマシン側 | 純粋なHTTPクライアント(Python 3.11以上、CUDA不要)およびstdio経由のMCPブリッジ機能を提供します。 |
| GGUFライブラリ | models.dir配下に既存の状態で配置済み | そのままインデックス化されるため、ファイルのコピーは一切不要です。 |
リクエストの流れについて
クライアント側で起こり得るすべての誤りは、最初のバイトが送信される前にチェックされます。不正なモデルIDが指定された場合には、JSON形式の本文を含む実際の 404 エラーが返されます。これはクライアント側でこの種のエラー処理が適切に行われるためであり、200 ステータスコードのSSEストリーム内に埋め込まれたエラーフレームを誤って扱う可能性があるからです。私の環境で GET /health を実行した結果(要約)は以下の通りです。
{"status": "ok", "boot": {"phase": "ready", "ready": true},
 "engine": {"ok": true, "tag": "b10425", "variant": "cuda", "smoke_tested": true},
"gpu_count": 4, "models_indexed": 34, "can_serve": true}can_serveが確認すべきフィールドです。statusは単にプロセスが稼働中であることを示すだけで、can_serveはライブラリのスキャン中は常に false となります。GET /health?deep=trueを実行すると各読み込まれたモデルに対して実際に8トークンの補完処理が行われ、何も読み込まれていない場合にはエラーではなくno_models_loadedという値が返されます。local-modelも利用可能です。local-model、default、auto、currentはすべてmodels.default_modelにマッピングされます。これはLM Studioのクライアントがこの文字列をそのまま使用するためです。- 未読み込み状態でもフリーズしているように見えません。 開かれたストリーム上には5秒ごとに
: loading <model id> (5s)というメッセージが表示され、その後: prefilling …へと移行します。これらはSSEのコメント行であり、パーサー側では無視されるため、クライアント側の読み取りタイムアウトが発生することはありません。 - マシン全体で一度に1つのモデルのみ読み込まれます。 同時に2つの未読み込みモデルを読み込もうとした際には同じGPUリソースを争い、その結果一方がメモリ不足で停止してしまった例もあります。
- リクエストの
ttlはアイドルタイマーのみに影響します。 この値を設定したからといってモデルをピン留めしたり解除したりすることはできません。
VRAMプランナー
これは、ほとんどのローカルサーバーが省略してしまう部分です。core/planner.py(バージョン0.2.0では3,188行)は、モデルが実行される前に一つの問いに答えます。すなわち、現在各GPUカードに空きがあるVRAM量を踏まえて、このモデルが利用できる最大のウィンドウサイズ、最適なキャッシュ品質、そして適切なスロット数は何か、ということです。もしどれにも合致しない場合には、どのような拒否メッセージを返すべきかも決定します。
コンテキスト・ラダー
初回実行時には、tune_for_hardwareにより、最も小さなGPUでも24 GiB以上のメモリを備えている場合は最下位の段が16,384まで引き上げられます。プランナーはモデルが訓練された長さを超えるウィンドウサイズを決して提案しません。なぜなら、それにはRoPEスケーリングが必要であり、品質の低下を招くからです。
第2パスの存在は、ある不適切な読み込み事例に起因します。当時は79,832 MBの空きメモリがあり、さらに待機中の別モデルが19,423 MBを使用していました。この状況下では、q4_0キャッシュを用いた場合262,144トークン分で96,004 MB、f16形式であれば65,536トークン分で95,236 MBと収まったはずです。しかし実際に読み込まれたのはf16形式の8,192トークン分で、89,860 MBを使用したケースでした。旧版のコードでは最下位の段のみが排除対象となっていたため、モデルは排除処理のコストも支払いながら最小限のウィンドウサイズしか得られませんでした。
各段においてキャッシュ品質も選択可能です:f16/f16 → q8_0/q8_0 → q8_0 K + q4_0 Vとなります。対称性を持つq4_0形式は自動処理の経路からは一切除外されています。q4_0のKキャッシュを用いた場合、Qwen2.5-7Bはf16版と比べてわずか11.7%のトークンしか再現できませんでした。一方でq8_0/q8_0の組み合わせではKLダイバージェンスが0.0018という値を示しました。
KVキャッシュのサイズはアーキテクチャによって異なります
ほとんどのVRAM計算ツールでは、KVキャッシュ量を「レイヤー数 × ヘッド数 × ヘッド次元 × 2 × バイト数 × コンテキスト長」として算出します。これはLlamaには適切ですが、他の2つの人気モデル群には全く合いません。Gemma 3および4では、全層に対して5層分のスライディングウィンドウレイヤーが混在しており、ヘッド次元も半分になっています。またQwen3.5、3.6、3.8ではfull_attention_interval = 4と定義されているため、4層ごとにのみKVキャッシュが存在し、残りのレイヤーは固定状態を持つGated-DeltaNetレイヤーとなります。
この計算を誤ると非常に高いコストがかかります。修正前、プランナーはGemma-4 31Bモデルにおいて262,144トークン時点でKVキャッシュだけで480 GiBもの消費量になると見積もり、モデルの利用上限を65,536トークンに設定していました。数週間にわたり、実際の使用量は40,037 MBであったにもかかわらず、校正ログには95,615 MBもの予測値が記録されていました。修正後は、262,144トークン時点での重み情報とKVキャッシュを合わせた総消費量が約38 GiBと正しく予測・測定されるようになりました。これによりウィンドウサイズは4倍に拡大し、すべてのGemma-4モデルが恩恵を受けています。Qwen3.5においても同様に、全レイヤーにKVキャッシュを割り当てるという誤りがあり、結果として4倍もの過剰な消費量が見積もられていました。
独自の推定プログラムを作成される場合は、llama.cppにおけるスライディングウィンドウ用の計算式をそのまま使用してください。単純に1.25倍という乗数を用いた場合、4つのスロット時点で実際の値より3.6倍も低く見積もられ、結局ロード時にメモリ不足に陥ることになります。
4種類のGPUを用いて測定した内容
使用したシステムはRTX 5090が2枚、RTX 3090が2枚で構成されており、ドライバー610.88(CUDA 13.3)下では合計で111.7 GiBのメモリが利用可能です。プランナーはまず1枚のGPUだけを使用してみるのですが、NVLinkなしでPCIe経由で処理を分割すると速度が低下し、最も遅いGPUの速度に引きずられてしまうためです。
| 配置方法(1.5B Q4_K_M、コンテキスト長8k、3回の平均値) | 生成速度 | プロンプト処理速度 |
|---|---|---|
| 3090を1枚使用 | 352.5 tok/s | 2,803.6 tok/s |
3090を2枚使用、-sm layer | 344.4 tok/s | 2,722.5 tok/s |
3090を2枚使用、-sm tensor | 294.3 tok/s | 1,182.0 tok/s |
3090を2枚使用、-sm row | エラー発生:device CUDA2 does not support split buffers | |
1枚のGPUを使った方が性能が良かったのです。この小規模なモデルにおいて、テンソル分割処理により生成速度が17%、プロンプト処理速度は58%も低下しました。そのためテンソルモードは明示的に指定する必要があり、ベンチマーク用途に限って使用されるべきです。-sm rowはパーサー側では受け付けられるもののCUDA上でエラーとなるため、StudioForgeでは実行前にこれをブロックしています。
いくつの並列スロットを利用するのが最適かは別問題です。まず、llama.cppにおける--ctx-sizeは各スロットごとのコンテキスト長ではなく、すべてのスロットで共有される合計KVバッファ量を表します。--ctx-size 4096かつ--parallelを指定しない場合、total_slots: 4と表示され、これは1スロットあたり1,024トークンということになります。StudioForgeではctx_per_slot × parallelの値をもとに処理を開始します。
| 同時実行数 | 各ストリームあたり | 合計速度 | p50 | p95 | 実現バッチサイズ |
|---|---|---|---|---|---|
| 1 | 302.8 tok/s | 302.8 tok/s | 0.41秒 | 0.41秒 | 1.00 |
| 2 | 225.3 tok/s | 425.3 tok/s | 0.46秒 | 0.49秒 | 1.84 |
| 4 | 134.5 tok/s | 436.0 tok/s | 0.83秒 | 1.00秒 | 3.46 |
| 8 | 83.3 tok/s | 576.9 tok/s | 1.57秒 | 1.77秒 | 6.03 |
Qwen2.5-1.5B-Instruct Q4_K_M、RTX 3090を1枚使用、各スロットあたり8,192トークン、f16形式のKVデータ。8つのスロットで処理を行い、プロンプト長は512トークン、生成されたトークン数は各192トークン。2026年8月19日実施。3回試行した結果、誤差は2%以内で再現されました。
同じモデルを同じGPUで動作させているにもかかわらず、なぜ単独使用時の数値が302.8となっているのでしょうか?実はこれらは設定が異なる別々のベンチマーク結果です。今回の測定では8つのKVスロットを利用しており、独自のプロンプト長および出力長を用いています。したがって、1つの表内で比較するべきであり、2つの表間で比較すべきではありません。
- 推定値では8スロットが推奨されたが、実測では2スロットが最適だった。 4スロット使用時には各ストリームの速度が単独使用時の44%まで低下します。採用ルールとしては、各ストリームの速度が単独時の65%以上を維持しつつ、全体の合計速度も15%増加させるような1、2、4、8の中から最大値を選びます。
- 全体的な処理量は増加する一方で個々のユーザーの速度は低下する。 8スロット使用時には1スロット時の1.9倍のトークンが処理されますが、各対話の速度は単独時の27%にまで落ち込みます。もし合計処理量だけを最大化するルールを用いれば8スロットが選ばれ、すべてのチャット速度が3倍遅くなってしまいます。
- バッチ処理は実際に行われている。 実現バッチサイズが1.00から6.03へと増加していることから、単なるキュー処理ではなく複数のデコード処理が共有されていることが分かります。
信頼できる機能として採用する前に私が測定した2つのフラグについて説明します:
- 投機的デコードは単一ストリームのみで効果がある。 RTX 30901枚上でQwen3.8-27B Q5_K_SモデルにMTPヘッドを追加し、4種類のプロンプトを用いて測定したところ、なしの場合は37.75 tok/sでしたが、
draft-mtpを深さ3で指定すると50.70 tok/s(+34.3%)まで向上しました。同じプロンプトを繰り返した場合には751%もの上昇が見られましたが、これは投機的デコードの効果ではなくプロンプトキャッシュによるものでした。4スロット以上ではauto設定により投機的デコードは自動的に無効化されます。 - より大きなマイクロバッチを用いればVRAMを犠牲にしてもプリフィル速度が向上する。 5,166トークン分のプロンプトにおいて、
-ub 2048を指定するとデフォルトの512より18.6%高速になり、210 MiB分多くのVRAMが消費されました。プランナーはこのバッファサイズを切り上げて計算し、-ub値を自動的に引き上げますが、その適用は4スロット以上の場合に限られます。
拒否処理とその数値について
どの起動時にも --fit off および --n-gpu-layers 999 が指定されます。これは重要な点です。なぜなら、llama.cppのビルド b10425 では --fit がデフォルトで on となっており、さらに --n-gpu-layers auto も設定されているからです(両方とも PR #16653、2025年12月による変更)。これら二つが組み合わさることで、実質的にGPUオフロードが部分的に無効化される仕組みとなります。これは一般的なサーバー環境においては適切なデフォルト設定ですが、本プロジェクトではこれを拒否しています。どの設定でも収まらない場合には、HTTP 507 エラーが返されます。実際のエラーメッセージを抜粋すると以下の通りです。
HTTP 507  {"error": {"code": "insufficient_vram", "message":
 "Cannot load '…/gemma-4-31B-it-QAT-Q4_0' entirely in VRAM: needs 29.09 GiB,
  20.90 GiB usable. … Suggestions: set KV cache type to q8_0 …;
  VRAM is held by other processes: …",
 "studioforge": {
   "required_bytes": 31235974510, "available_bytes": 22438368871,
   "per_gpu_free": {"3": 22438368871},
   "max_ctx_that_fits": null,
   "notes": ["wanted up to 262144 tokens of context but not even the 128000 floor
             fits in the VRAM available right now"],
   "estimate_mb": {"weights_bytes": 16818.2, "kv_bytes": 8575.0,
                   "compute_bytes": 2438.6, …, "total": 29788.9},
   "retry_after_s": null }}}
これは、31Bモデルを1枚のRTX 3090上に読み込もうとした際の例です。このメッセージは人間向けであり、error.studioforge はプログラム用のエラー情報となります。より小さなウィンドウサイズなら収まる場合には、max_ctx_that_fits という値でそのサイズが示されます。retry_after_s は、モデルがビジー状態であることが原因の場合にのみ設定されます。そうでなければ再試行しても意味がないからです。
ピン、TTL、およびリース
モデルは最初のリクエスト時に読み込まれ、アイドル状態が続くとそのTTL時間が経過した後にアンロードされます(models.default_ttl_s。15秒ごとに更新されます)。
「ピン」とは望ましい状態を指します。 ピンが設定されたモデルにはアイドルタイマーが存在せず、決して削除されることはありません。万が一クラッシュしたり起動に失敗した場合でも、再調整処理によって再読み込みされます。その際の待機時間は60秒から900秒までランダムになります。ただし、明示的にアンロードを行えばその状態が維持され、再度誰かが読み込みまたはピンを設定するまでそのままです。
「リース」とは特定のモデルにカードを割り当てる仕組みです。 リースされたカードは他のどのモデルからも見えず、所有者は必ずそのカード上で動作することになります。すでにリースされているカードを要求した場合には 409 コンフリクト が返され、他のモデルがそれを奪うことはありません。また、サーバー外のプログラム用にもカードをリースできます。例えば reserve_gpus(devices=[3], reason="ComfyUI render") と記述することで、画像生成処理と言語モデルが同じカードを奪い合うのを防ぐことができます。
削除処理は ピンされているモデル、現在リクエストに応答中のモデル、まだ読み込み中のモデル、またはリースされたカードには一切影響しません。バックグラウンドで動作する再配置処理によってアイドル状態のモデルがより適切な場所へ移動されることもありますが、1モデルあたり30分に1回までしか行われません。というのも、移動させるとプロンプトキャッシュが失われてしまうからです。私の場合、長い会話においてこのキャッシュが9万8000トークンものプロンプトのうち93%を保持してくれました。
不具合が発生した際の対処法
VRAMは、それを使用しているプロセスと共に解放されます。 Windowsでは、子プロセスたちは JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE を用いて作成された匿名のジョブオブジェクト内で動作するため、親プロセスがどう終了してもカーネルがそれらを強制終了します。Linuxでは PR_SET_PDEATHSIG が使用されていますが、これはあくまで努力義務に過ぎません。そのため起動時の一括処理および reclaim_orphan_engines によって、見逃されたプロセスも回収される仕組みとなっています。
なぜこのような処理が存在するか: 2026年8月18日時点で、2枚のGPU上で約25 GiB分のVRAMが使用されていましたが、実際には「すべての処理が停止」した状態でした。その原因は、あるコーディングエージェントがテスト用に起動させたまま放置していた llama-server.exe の子プロセス3つだったのです。現在では、VRAMを使用しているプロセスはすべて ours、child-of-live-process、orphan、other-instance、foreign のいずれかに分類されており、実際に強制終了されるのは orphan のみです。
終了コードには意味があります。 2 は設定ファイル上のキー名に関するエラーを示します。3 はポートの競合を意味し、この場合トレイは新たなプロセスを起動せず、既存のプロセスが解放されるのを待ちます。75 は再起動が要求されたことを示します。このときサーバーはデータを適切に処理した上で終了し(計測値は1.0秒)、トレイはクラッシュとしてカウントせずに再起動を行います。こうした区別が設けられたのは、かつてGUIからの再起動時に2つのサーバーがポート1234を争い合い、結果として正常稼働中のサーバーの隣でトレイが「クラッシュ」と表示され続ける事態が発生したためです。
ゲートウェイが完全に停止していないものの動作不能な状態になった場合は、1235 番ポート上で稼働するウォッチドッグを利用してください。これは argparse および標準ライブラリのログ機能のみを用いて構築された独立したプロセスであり、config.yaml が破損していても起動可能です。提供される機能は health、get_config、set_config、restart_server、kill_model、nuke_all_models、reclaim_orphan_engines、tail_logs、gpu_status、rollback_update の10種類です。このウォッチドッグは、修復対象となるコード自体をインポートしません。
コントロールパネル
8080番ポート上で動作するパネルは同じプロセス内で実行され、絶対URLも使用しないため、通常のHTTP環境やHTTPSプロキシの背後でも問題なく機能します。Windows版ではトレイアイコンも用意されています。
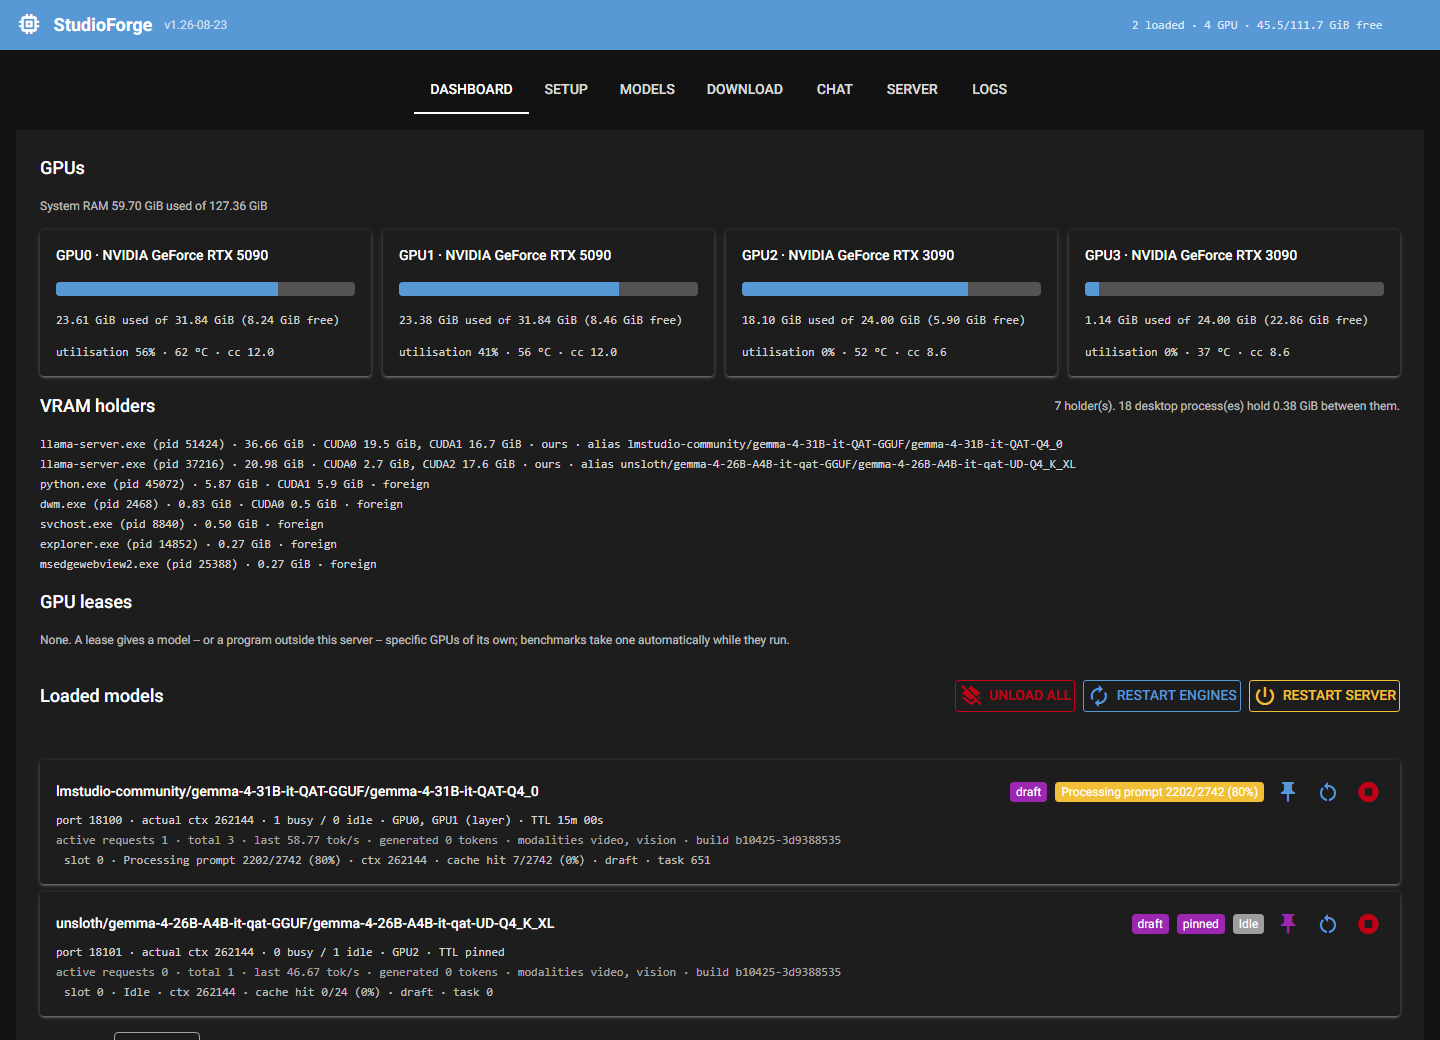
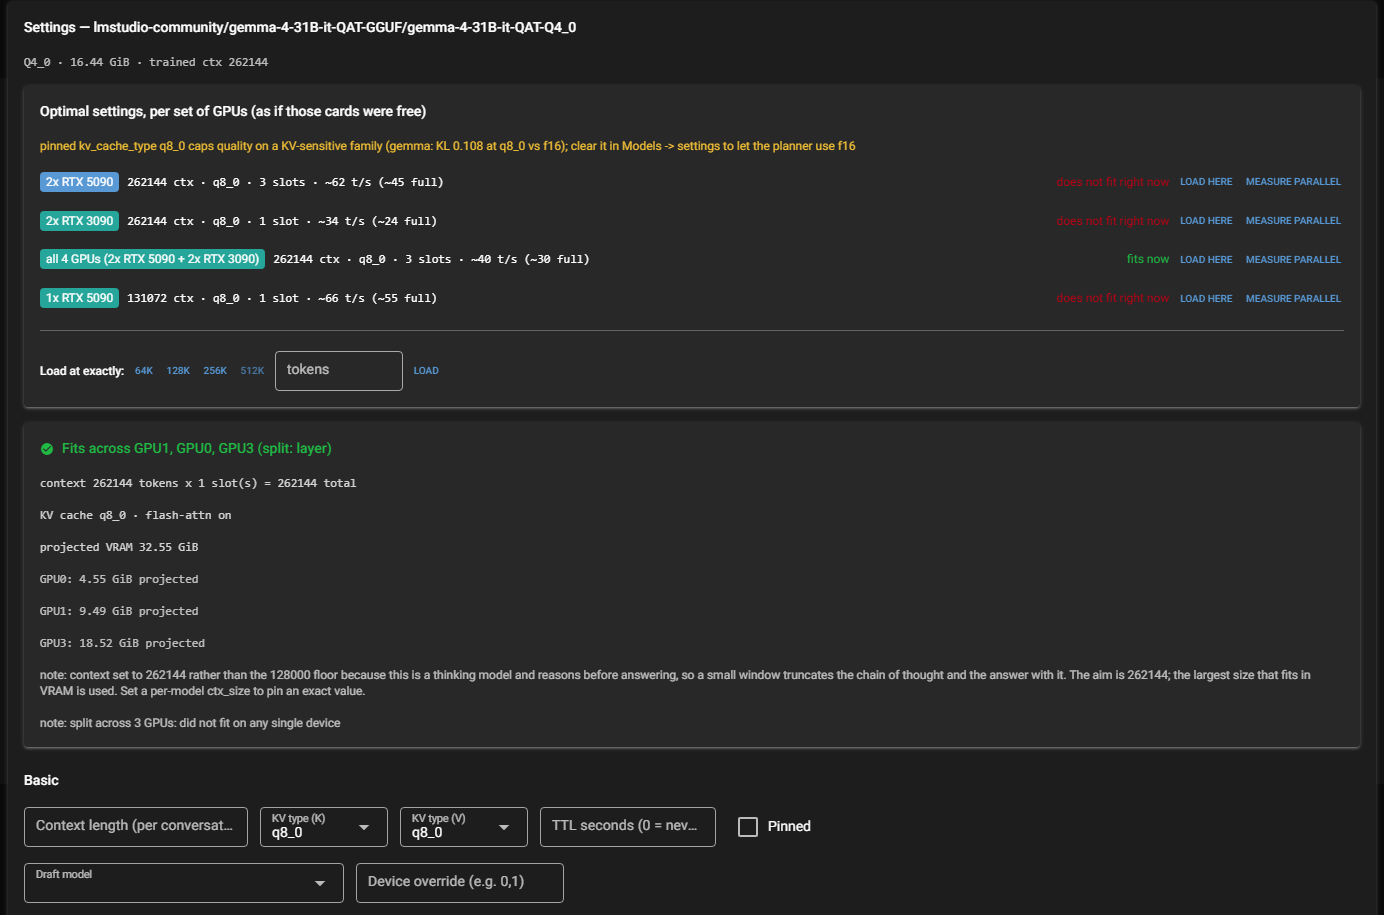
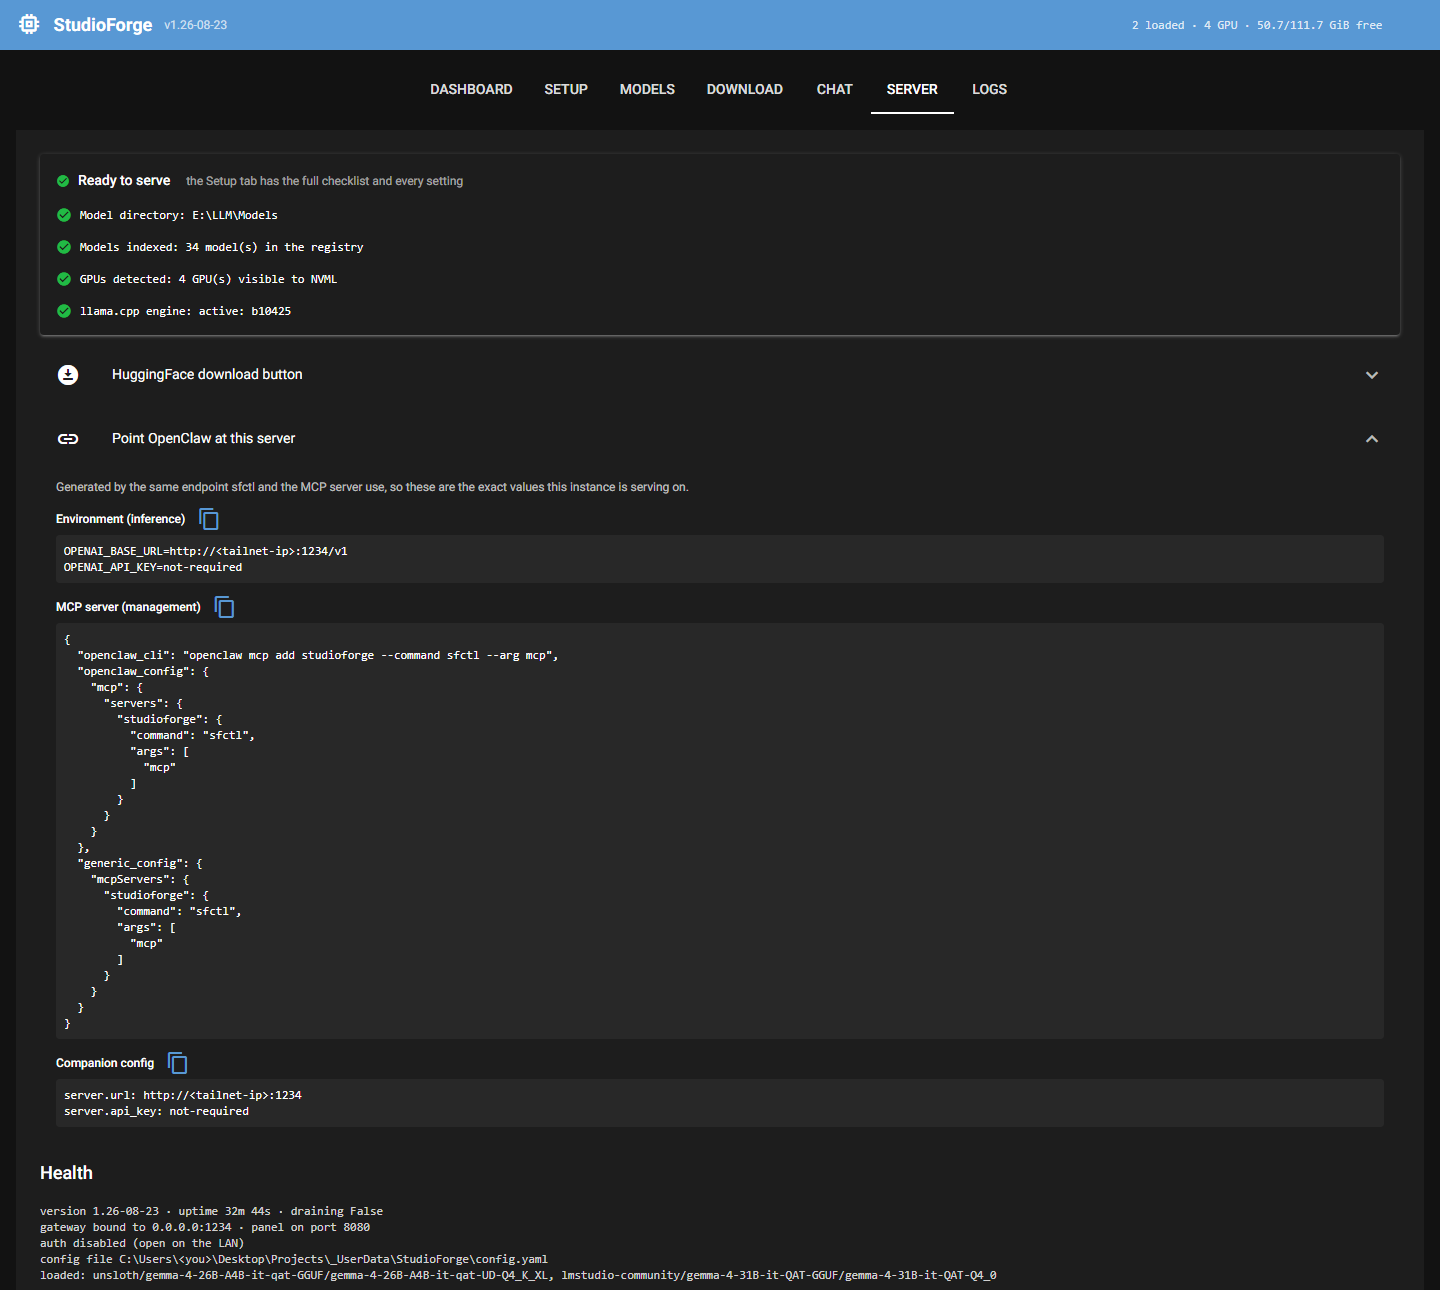
sfctlを実行するため、ペアリング用のPINコードを設定ファイルに記載する必要は全くありません。ハーネスバックエンドとしての利用方法
推論処理と管理処理は別々のパスを通ります。どんなクライアントでも、何もインストールせずに /v1 を利用できます。ただし、サーバーを管理すべきエージェントのみが MCP ツールを必要とします。
どんな OpenAI クライアントでも
server.api_key はデフォルトで null となっていますので、空でない任意のキーが利用可能です。ほとんどの OpenAI クライアントは空のキーでは起動できません。
export OPENAI_BASE_URL=http://my-gpu-rig:1234/v1
export OPENAI_API_KEY=not-required        # any non-empty string while server.api_key is unset

curl http://my-gpu-rig:1234/v1/chat/completions -H "Content-Type: application/json" \
  -d '{"model": "<id from /v1/models>", "messages": [{"role": "user", "content": "hello"}]}'
GET /v1/models を実行すると、ダウンロード済みのすべてのモデルが LM Studio 風に一覧表示され、さらに state、そしてロード済みのモデルについては ctx_per_slot および max_parallel も返されます。モデルIDは完全な publisher/repo/file、単なるファイル名、または publisher/name のいずれかで、大文字小文字を区別せずに一致します。
各クライアントにおいてベースURLの設定項目名が異なっており、これが最も時間を浪費させる要因です。Open WebUI では OPENAI_API_BASE_URL、LibreChat では custom エンドポイントにて baseURL および models.fetch: true を使用します。aider では OPENAI_API_BASE の後 --model openai/<id> と指定します。Continue では provider: openai に加えて apiBase を設定します。dsh でも他のサーバーと同様に OpenAI プロバイダーの設定ブロック(baseURL、apiKeyEnv)を使用します。正確な YAML 記述は dsh の説明文にあります。キー不要のサーバーでも、クライアントがビーアートークンを必須とするため、何らかの認証情報が必要です。
別マシン上の OpenClaw
エージェントが動作するマシンには小さなパッケージ sfctl をインストールします。Python 3.11 が必要ですが、サーバーパッケージには依存せず、CUDAやプランナーも不要です。
sfctl servers add rig http://my-gpu-rig:1234 --api-key <PIN> --use
openclaw mcp add studioforge --command sfctl --arg mcp手動で設定ファイルを編集する際は、OpenClaw 用のキーが mcp.servers であり、mcp 配下に配置される点にご留意ください。平文形式の mcpServers マップは Claude Code、Cline、LibreChat用で、OpenClaw のスキーマでは認識されません。推論関連の設定は models.providers 配下にあり、キー名は小文字の rl を含む baseUrl となります:
// ~/.openclaw/openclaw.json
{ "mcp": { "servers": {
      "studioforge": { "command": "sfctl", "args": ["mcp"] } } },
  "models": { "providers": {
      "studioforge": {
        "baseUrl": "http://my-gpu-rig:1234/v1",
        "apiKey": "not-required",
        "api": "openai-completions",
        "models": [ { "id": "<id from /v1/models>", "name": "Rig 27B", "contextWindow": 131072 } ] } } } }
0.2.0 版ではエージェントが 合計29個のツールを一つのリストとして見ることができます。これはゲートウェイ側の19個とウォッチドッグ側の10個を合わせた数です。衝突を避けるため3つのウォッチドッグツールは recovery_* という名前に変更されていますが、restart_server はエラーメッセージから呼び出しが求められるため元の名前のままです。メインサーバーがダウンしていても、ブリッジ側では管理用ツールが備考付きで表示されるので、エージェントはそれらが存在することを把握できます。エージェントが実行する処理の流れは以下の通りです:
list_models(limit=N):最新ダウンロード順のカタログ。推奨モデル行を参照してください。load_model(**row["load_args"]):その行の内容をそのまま渡します。load_recommended(model_id, ctx_size=N)は必要なコンテキストサイズが分かっている場合に使用します。小さくすることはできず拒否されます。- MCPではなく HTTP経由で推論を実行します。未ロードのモデル名を指定すると、読み取った行の設定ではなくプランナーのデフォルト値でロードされます。
model_options(model_id)は各コンテキストレベルごとの速度情報を返します。search_models→repo_details→download_modelで新しいモデルを入手できます。pin_modelは常に応答させる必要があるモデル用、reserve_gpus/release_gpusは専用のGPUカードを確保・解放するためのものです。server_statusおよびconnection_info:現在ロードされているモデル、どのデバイスがVRAMを使用しているか、応答可能なすべてのアドレスなどが分かります。
どのクライアントにも接続時には次の注意書きも表示されます:
INFERENCE IS NOT HERE. This server exposes no chat/completion/generation tool
by design. To actually run a prompt, use the OpenAI-compatible HTTP API on the
gateway port (POST /v1/chat/completions, /v1/embeddings; GET /v1/models).
Naming an unloaded model in a request just-in-time loads it, so you usually do
not need load_model at all -- reach for it only to pre-warm a model or to load
one with non-default context/quantization settings.
Claude Code は自身の推論処理にこのサーバーを利用できません。同ツールのゲートウェイプロトコルは Anthropic Messages、Bedrock、Vertex であり、/v1/chat/completions には対応していません。ただし管理用ツールは利用可能です:claude mcp add studioforge -- sfctl mcp(この際 -- が必須となります)。
ベンチマークツールは POST /api/leases 経由でリースを取得し、使用中のモデルを待機させた後、置き換えられたモデルを再ロードすべきです。私の古いスクリプトでは代わりに pkill -f llama-server を実行しており、これはすべてのバックエンドを停止させてしまいます。
エージェントが参照する情報
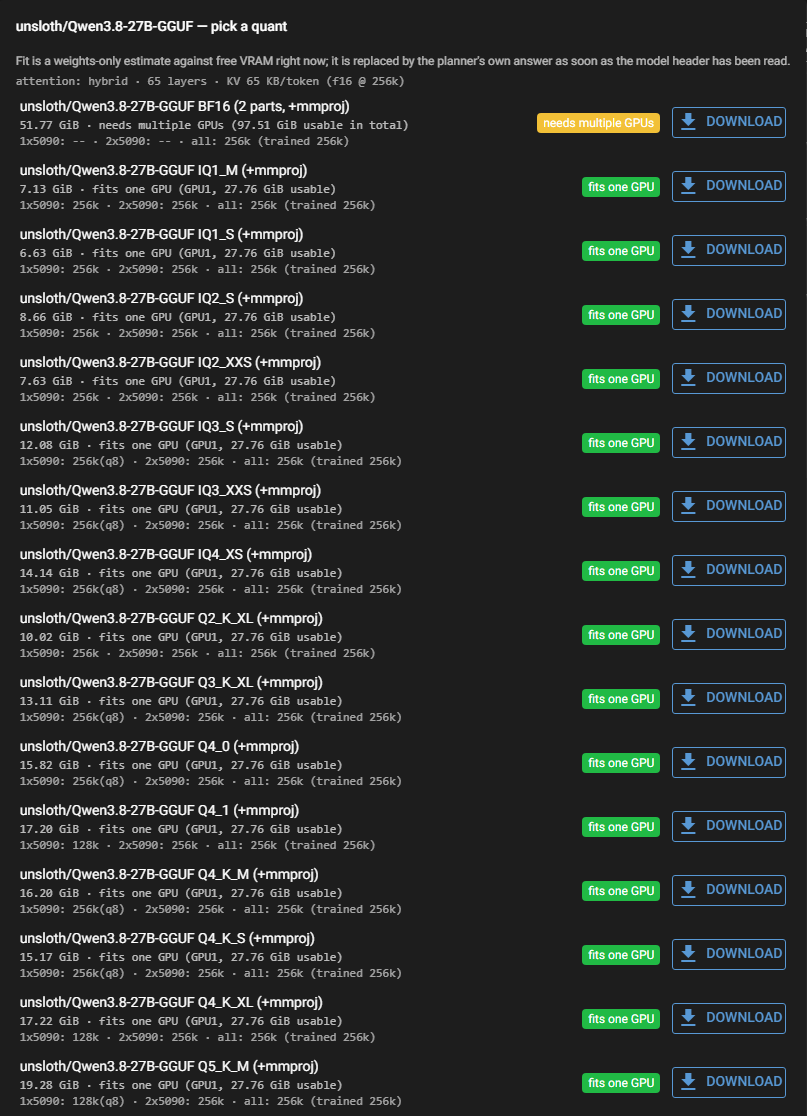
カタログの各行は実際にプランナーを呼び出した結果です。現在空きVRAMに収まるか、どのデバイスで利用可能か、何スロット分必要か、GPUがアイドル状態なら収まるかどうかも示されており、エージェントはアンロードが有効なタイミングを判断できます。repo_details では20GBものデータをダウンロードせずに、HTTPの Range リクエストを用いて GGUF ヘッダー情報を遠隔から取得(2~15MB程度でキャッシュされます)し、同じプランナーによるコンテキスト適合性のマトリックスも返します:
| 量子化形式 | RTX 5090×1枚 | RTX 5090×2枚 | 4枚すべて使用時 |
|---|---|---|---|
| BF16(51.8 GiB) | 重みが収まらない | q8_0で32k | 256k |
| Q8_0(27.9 GiB) | 収まらない | 256k | 256k |
| Q5_K_M(19.3 GiB) | q8_0で128k | 256k | 256k |
| IQ2_M(10.5 GiB) | 256k | 256k | 256k |
unsloth/Qwen3.8-27B-GGUF を私の環境で計算した数値です。f16キャッシュにおける最大ウィンドウ幅を示しており、「q8_0で」という表記は量子化キャッシュがより広い範囲に対応できる場合のみに現れます。
カード数よりも量子化形式がウィンドウサイズを決定します。例えば BF16 から Q5_K_M へ変更すると、1枚のカードでも128kの幅が確保でき「収まらない」状態から脱出できます。モデルの調整や配置ベンチマークを行う際は、まず benchmark_parallel を実行して最適な結果を得た後、reserve_gpus を利用してください。
インストール方法
Windows(推奨プラットフォーム):
- Git、Python 3.12以降、uv、そして最新のNVIDIAドライバーをインストールします。
- リポジトリをクローンするか、ダウンロードしたファイルを解凍します。
launchers\Update StudioForge.batをダブルクリックします。名前とは裏腹に、これが初回実行時の手順です。この処理により仮想環境が作成され、ご使用のドライバーに対応する最新版の llama.cpp がインストール・テストされ、固定されます(おそらくb10425より新しいバージョンが得られるでしょう)。launchers\Start StudioForge.batを実行するか、トレイアイコン用にlaunchers\StudioForge Tray.batを実行します。パネルはhttp://127.0.0.1:8080で開き、設定タブにおいて Detect LM Studio library 機能が既存のモデルフォルダーを検出します。
Linux でも cmake およびご使用のドライバーと互換性のある nvcc が含まれる CUDAツールキットが必要です。というのも、公式側からはLinux向けのCUDAビルドが公開されておらず、エンジンはバージョンごとに一度だけコンパイルされる仕組みだからです。前述の通り、私自身はこのビルド手順を最後まで試したことはありません。
git clone https://github.com/LaserLloyd/StudioForge.git && cd StudioForge
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python -e ".[dev]"
.venv/bin/studioforge serve --open # first run builds the engineヘッドレス環境用として、deploy/ ディレクトリには2つの systemd ユーザーユニットが用意されています。サーバーはモデルライブラリや仮想環境、GPUデバイスを所有するユーザー権限で実行されなければならないためです。監視用ユニットでは Restart=always が設定されており、ゲートウェイとは連動しないため、ゲートウェイがダウンしても継続して稼働します。sudo loginctl enable-linger "$USER" を実行すれば、ログインなしでもこれらのユニットが起動するようになります。
| サービス | デフォルトポート | 設定キー |
|---|---|---|
ゲートウェイ(/v1、/api、/mcp) | 1234 | server.port |
| Web制御パネル | 8080 | gui.port |
| 復旧監視ユニット | 1235 | watchdog.port |
llama-server の子プロセス(ループバック専用) | 18100–18200 | gateway.child_port_start / _end |
設定検証の際、子プロセス用ポート範囲と重複するサービスポートは拒否されます。データディレクトリはまず SF_DATA_DIR が参照され、次に --config ファイルがあるフォルダー、最後に <repo>/data が用いられます。詳細は docs/SETUP.md に記載されています。1つのインスタンスは排他的なOSロックによって1つのデータディレクトリのみを所有します。
セキュリティ
ルールは次の通りです:読み取り、推論、およびロード処理は常に許可されるが、設定変更には認証情報が必要である。 server.api_key が未設定の状態では、設定変更や再起動、エンジンの更新、VRAMの回収、ダウンロード、リース処理、削除を行うリクエストは、同一マシンからのもの、または X-MCP-Pin ヘッダーに記載されたMCP PINやBearerトークンを使用した場合のみ受け付けられます。それ以外の場合は 403 remote_admin_requires_credential エラーが返されます。
- MCP PINはMCPの保護のみに使用されます。これは起動時のバナーに記載されるペアリングコードであり、APIキーではありません。
server.api_keyが実際の認証情報であり、初期状態では未設定です。この値を設定すると/v1、/api、/mcpおよびウォッチドッグ機能のすべてが保護されます。- 3つのリスナーはデフォルトで
0.0.0.0にバインドされます。いずれかのリスナーが認証なしで公開されている場合、設定画面の「ネットワーク公開」欄がオレンジ色になります。公開する前に必ず認証キーを設定してください。 - クロスオリジンのブラウザリクエストは、ループバック上であってもローカルリクエストとは見なされません。そうでなければ、任意のウェブページが
127.0.0.1:1234に対してPATCH /api/configを実行できてしまいます。オリジンチェックではポートも考慮され、Origin: nullは外部からのリクエストとみなされます。リモートのブラウザからはMCP PINが見えないようになっています。 - 画像URLの取得処理にはSSRF対策が施されています。この対策によりループバック、リンクローカルアドレス、プライベートアドレス、ULA、CGNAT(
100.64/10範囲内でメッシュVPNのピアが存在します)からの接続がブロックされ、検証済みのアドレスのみに接続します。
制限事項が2つあります。1つ目は、同一マシン判定ではループバック上のすべてを信頼するため、リバースプロキシの背後にある場合はそのプロキシ自体が「同一マシン」とみなされてしまう点です。したがって、プロキシ側で server.api_key による認証を行う必要があります。2つ目は、共有キーのみが存在し、アカウントもレート制限もないという点です。このキーは認証付きプロキシの背後やメッシュVPN内のループバック上でのみ使用し、決して公開インターネット上では利用すべきではありません。
制限事項
- Windowsが参照プラットフォームです。 トレイ機能やジョブ単位のVRAM制御、プロセスごとのGPUカウンターなどはすべてWindows向けに実装されています。LinuxでもCI環境で動作します(インストールをご覧ください)。macOSはサポート外です(CUDAが利用できないため)。
- NVIDIA専用です。 プランナーはNVMLから情報を読み取り、エンジン部分はCUDAベースで構築されています。
- VRAMの数値は推定値です。 重みデータのサイズはファイルサイズの2%以内に収まり、KVデータは各レイヤーの配置情報から正確に算出されます。ただし計算用バッファのサイズは調整済みの割合として設定されており(0.03~0.15の範囲で制限)、メモリ上に保持され、再起動するとリセットされます。
- 複数GPU間での負荷分散は比例して行われるだけで、実測値ではありません。 相互接続帯域幅もモデル化されておらず、異なる世代のGPUが混在する場合は最も遅いGPUの速度に合わせて動作します。
- 速度の見積もりはベンダー提供の数値を基にしており、実測値ではありません。 私の環境では、31B規模のモデルで実際の処理速度は39.4トークン/秒でしたが、推定値は36.1トークン/秒でした。122B規模のMoEモデルでは実測37.3に対し推定値は47.4でした。
- 他のプログラム用にGPUを予約しても、私のプランナーだけが制限を受けます。 その他のプログラムや別のアプリケーションがメモリを使用することは何ら妨げられません。
- ライセンスに関する注意点です。 StudioForge自体はMITライセンスです。pystrayはWindowsのトレイアイコンを描画するためのライブラリで、LGPL-3.0ライセンスが適用されます。通常通り個別パッケージとしてインストールすれば、ライセンス表示を残しておくだけで問題ありません。すべてを単一の実行ファイルにまとめる場合は、pystrayのソースコードも同梱するか、別モジュールとして配布してください。
- 他者による監査は行われていません。 上記の内容はすべて私自身が書いたコードに関する説明です。重要なデータを扱う際には必ずソースコードをご確認ください。
私のマシンでは2,503件の単体テストが成功し、17件がスキップされました。所要時間は327秒でした。CI環境ではWindowsおよびUbuntu上で偽のGPUバックエンドを用いて同様のテストが実施されています。もう一つのテストスイートでは実際のGPUにモデルを読み込んで検証しますが、前述の問題のためデフォルトでは無効になっており、環境変数の設定が必要です。
注意点
- 起動前にLM Studioを終了させてください。 両方ともポート1234を使用しようとします。プリフライト処理でホルダー名が設定され、
server.portによってStudioForgeが起動します。モデルフォルダーの共有は問題ありません。 --ctx-sizeで指定する値は各スロットごとの値ではなく、すべてのスロットを合わせた合計値です。また、上位側の--fitはデフォルトで有効になっています。llama-serverを直接実行する場合は、--fit offを指定し、各スロットごとのコンテキストサイズを自分で設定してください。--reasoning-format autoの設定下では、推論用モデルが空の返答を返すことがあります。 同じプロンプトを使用した場合、auto設定時はcontentが0文字でreasoning_contentが316文字となります。一方none設定時はcontentが323文字になります。reasoning_contentはOpenAIの仕様には含まれていないため、標準的なクライアントでは何も表示されません。そのフィールドを読み取るクライアントをお使いでない限りnoneをご利用ください。- トレイプロセスを強制的に終了させないでください。 venvランチャーを使用している場合、ウォッチドッグも同じプロセスツリー内に存在します。そのような方法で再起動を行うと、サーバーおよびウォッチドッグの両方が停止してしまうことがあります。トレイメニューやパネル、あるいは
sfctl recover --restartをご利用ください。 - 他のツールから
pkill -f llama-serverを実行するとバックエンドが停止してしまいます。 その代わりにGPUリース機能をご利用ください。 - NVMLにおける
busIdのバス番号は16進数です。"00000000:42:00.0"という値はバス66を表します。この値を10進数として解釈すると、エラーなしに誤ったGPUカードに対してVRAMが割り当てられてしまいます。 - 推測デコーディングのベンチマークでは、同じプロンプトを繰り返すとプロンプトキャッシュの測定になってしまいます。 異なるプロンプトを使用してください。
/propsではドラフト中にspeculative.types: "none"と表示されますが、実際の完了処理時にはtimings.draft_nの値を参照する必要があります。 - ビジョンモデルではプロンプトキャッシュの利点が得られません。 llama.cppではマルチモーダルモデルに対してキャッシュの再利用が無効化されており、デフォルトで各画像につき1,024トークン分のリソースが割り当てられるため、8kのウィンドウサイズでもすぐに上限に達してしまいます。
ダウンロード方法
GitHubには常に最新バージョンが公開されており、テストコードやドキュメント、ランチャー、さらには systemd 用の設定ファイルも含まれています:
github.com/LaserLloyd/StudioForge
git clone https://github.com/LaserLloyd/StudioForge.git配布されているZIPファイルのバージョンは 0.2.0 です。これは main ブランチの d7e5d26 コミット(2026年8月25日)に対応しており、dist/ ディレクトリには両パッケージ用の事前ビルド済みファイルも含まれています。本記事で紹介している29種類のツールや各パネル、プランナーなどはすべてこのバージョンに関する内容です。なお、GitHub上の main ブランチはその後も更新され、plan_load および check_loaded_model という2つの管理用ツールが追加され、合計で31種類となっています。ZIPファイルのSHA-256ハッシュ値は以下の通りです:
72e3b44487645e7790ba8497e029868e07ca340f67c92f1834345d4e50839f6d studioforge-2026-08.zipこのZIPファイルには追跡対象のファイルのみが含まれており(config.yaml や data/ は含まれません)。ライセンス:MIT ですので、自由に利用・改変・配布・販売していただいて構いませんが、著作権表示は残してくださるようお願いします。保証は一切ありません。
不具合を発見されましたか?連絡先は Aboutページ に記載しております。問題の特定には error.code、507エラーから得られる数値、そして logs/models/<model>.log の最後の20行程度が役立ちます。ただしPINコードや各種キー情報は伏せてお願いします。共同で開発できるようなバインパッキングプランナーやサンプラープリセット機能、あるいはAMD向けの実用的なパス実装などに関するプルリクエストも大歓迎です。
このプロジェクトが私に残したもの
実際には、このプロジェクトの大部分はコーディングではなく測定作業でした。プランナー自体は誰でも書けるような単純な算術処理に過ぎません。ただし、llama.cppにおける実際のKVレイアウトを確認し、私の推定値が8だったところを実測すると2が最適なスロット数であることが判明した後で初めて信頼できるものとなりました。すでに1234上でLM Studioをご利用中の方であれば、この設定を試すにはクローン作成とバッチファイル1つを用意し、models.dirを既存のフォルダー先に指定するだけです。もし半日以内に効果が得られなければ、これまでの設定は一切変更されません。
関連記事:DeepSeek Harness (dsh)(このサーバーを通常のOpenAIプロバイダーとして呼び出すためのハーネス)、bench-llm / CrucibleForge(現在はGPU利用も可能となったベンチマークツール)、私のOpenClaw設定(この問題を指摘した記事)、そしてDisPatch(その前面で動作するチャットアプリ)です。
ダウンロード
個人利用は無料です。役に立ったら、コーヒーをおごってもらえると嬉しいです。