一台のミニPC上で動作するAIエージェントの小規模なオフィス:私のOpenClawスタック
- カテゴリ
- AIとローカルLLM
- 公開日
- 2026年7月11日
- 更新日
- 2026年9月16日
- 著者
- Jacob Lloyd — プロジェクト完了後、AIの支援を受けて執筆
- 読了時間
- 約23分で読めます

かんたんに言うと: 私の家にある1台の小さなコンピューター上で動作する6つのAIアシスタントを紹介します。それぞれが独自の役割を持っています。私と会話するリード役、重い仕事を担うワーカー、レビュアー、そしていくつかのペルソナエージェントもいます。その中には家族用の電話として使えるほど安全なものもあります。ここでは、作業がどのように引き継がれていくか、設定がどのようにして作業が欠落したことを検知するか、そして何が請求額を決定する要因となるかが示されています。
私の自宅にあるミニPC上で6つのAIエージェントが動作しています。そのうち1つは私と対話し、どのエージェントが何をするかを決定します。もう1つは重い処理用のワーカーで、各タスクごとに新しく起動されます。また別のエージェントは完了した作業を確認します。残りはさまざまな役割を持つペルソナエージェントたちで、さらに家族がスマートフォンから操作できる安全用のエージェントも存在します。リード役のエージェントは定額制のクラウドプラン上で動作し、個人的な処理はローカルに配置されたモデルを利用するため、毎月の費用は私がどれだけの量の処理を依頼するかによって決まります。この記事では、これら各要素がどのように連携しているか、それらをつなぐ設定内容、実際に始めから終わりまで処理が行われる流れ、そして完了した作業が確実に私の手元に届くための監視機構について説明します。
要約
- 概要: 私が自作したチャットアプリの背後で動作する自己ホスティング型のAIエージェントゲートウェイ、OpenClaw。ここでは6つのエージェントがそれぞれ独自の役割やモデルのフォールバック設定、ツール利用権限を持っています。
- 構成: タスクを振り分けるリード役のエージェント、4種類のモデルを用意したステートレスなワーカー、別のモデルで動作するレビュアーエージェント、そして私のネットワーク内にあるGPUマシン上で提供されるローカルモデル群。
- 費用: 月によって大きく変動します。実際の費用の内訳は私のAIエージェントが実際にいくらかかるかという記事で詳しく説明しています。本記事ではその費用の決定要因について述べます。
- 必要環境: 32GBのRAMを備えたLinuxマシン(私の場合はCHUWI AuBoxミニPC)と、systemdの設定に慣れるための少しの忍耐が必要です。実際のGPUを備えた第2のマシンは任意で、あればローカル処理の能力が向上します。
最終的に得られるもの
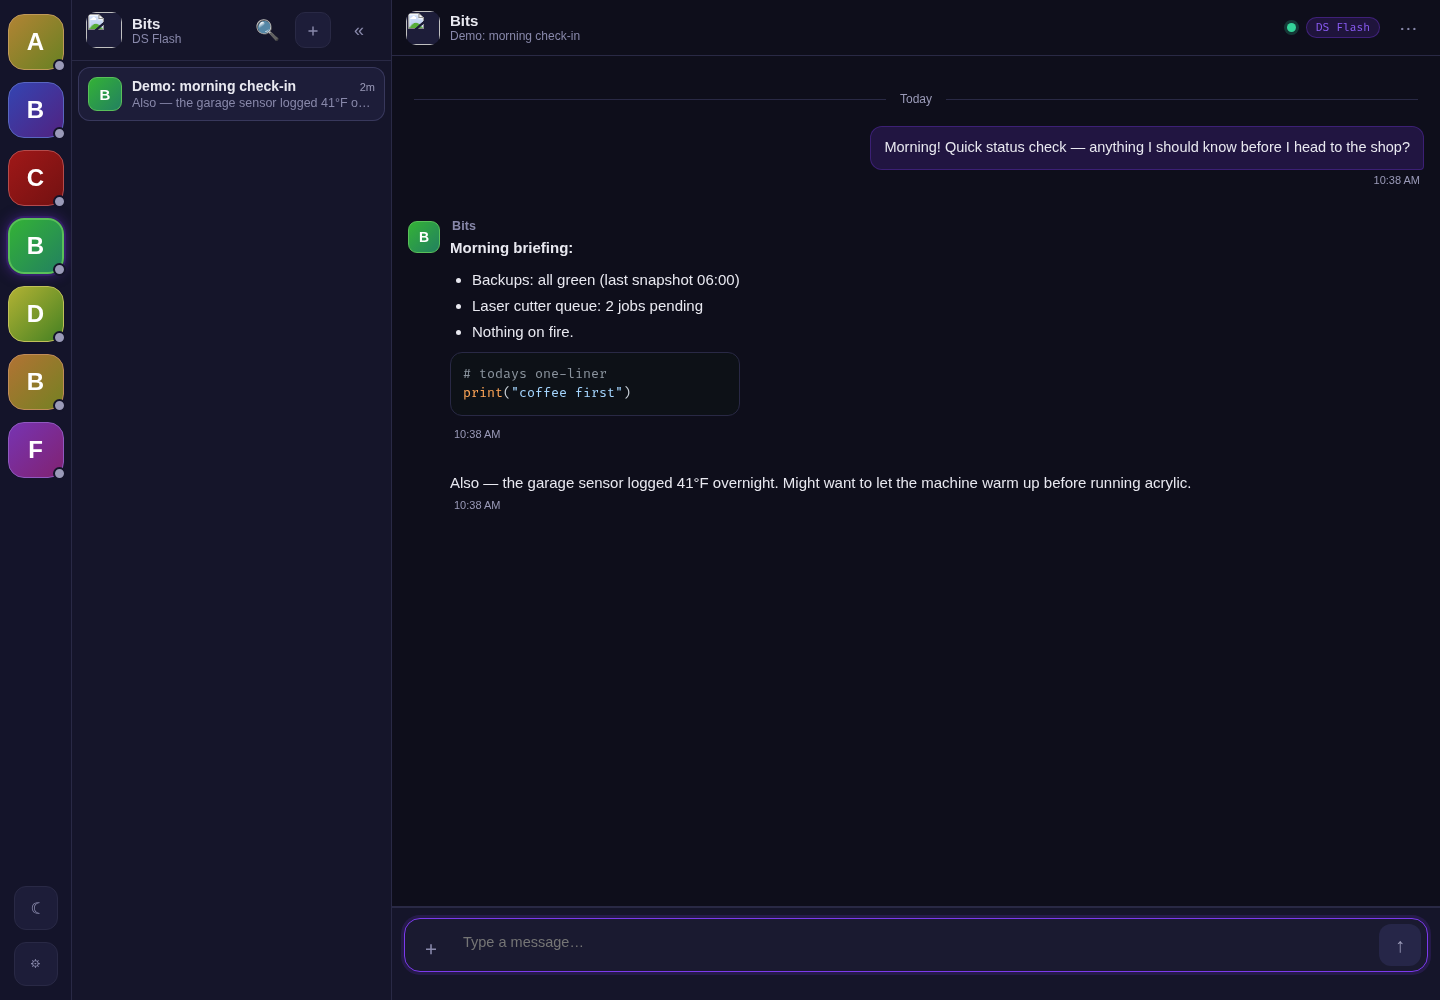
家全体で共通して使えるチャットのURLが一つだけあります。リードエージェントに何かを依頼すると、そのエージェントが直接答えたり、他の作業者に仕事を割り当てたりします。そして結果も同じスレッド内に返ってきます。家族用のデバイスでは安全なエージェントのみが表示されます。画像生成処理はGPUボックス上で行われ、メールの下書きは人間が送信するまで待機状態になります。チャットフロントエンドには DisPatch を使用しています。ここに掲載されている画像は、2026年7月に公開されたその説明書に記載されていたサンドボックス版のデモデータです。
そのマシンについて
ゲートウェイ、チャットアプリ、そして各種スクリプトは、すべてこの小さなマシン上で動作しています:
- CHUWI AuBox Ai365:AMD Ryzen AI 9 365プロセッサ、10コア、Radeon 880M統合GPUを搭載。
- 利用可能なDDR5メモリは30GBですが、これはOSやその他すべての処理で共有されるため、実質的にVRAMは存在しません。
- Bluefin:不変性を持つFedora Atomicベースのシステムです。AMD製マシンなので、GPU関連の処理にはROCmが使われ、CUDAは使用されません。
このマシンは、同目的で利用されている2台目のマシンです。最初に使っていたのは128GBメモリを備えたROG Flow Z13で、7月に電源系の不具合が発生するまで、120B規模のミックスド・オブ・エキスパーツ型モデルをローカルで実行していました。今回導入されたマシンはメモリ容量がその4分の1しかないため、大規模なモデル類は私のネットワーク内にある実際にGPUを搭載した別のPCへ移されました。そちらでは私が作成したOpenAI互換のサーバーであるStudioForgeが稼働しています。画像生成処理も同様にそちらへ移行しました。以前はこのマシン上でローカルのComfyUIが動作していましたが、現在はそうではありません。今ではこのミニPC上では一切のモデルが実行されていません。かつてはLM Studioを使って7B規模のビジョンモデルや埋め込みモデルも動作させていましたが、2026年9月16日にそれらを削除し、現在はGPU搭載PCがこれらの役割を担っています。
メンバー紹介
このチームは2026年9月6日に再編成されました。以前は役割が重複するエージェントが12名ほどいましたが、現在は6名となっています。私が守ったルールは「各種決定事項ごとにエージェントを1名ずつ配置し、そのエージェントにはその仕事に必要なツールのみを与える」というものです。
| 役割 | 担当業務 | 使用モデル(フォールバック含む) | 利用可能なツール |
|---|---|---|---|
| リード | 私と対話し、簡単な質問に答え、迅速なシェルコマンドの実行や重い処理用のワーカーの起動を行う | 定額制プランで利用可能なMiniMax M3(DeepSeek pro、次いでflash) | ファイル操作、シェル、ウェブ検索、他エージェントの起動機能。ブラウザは使用不可。 |
| ワーカー | ステートレスな存在。各ジョブごとに新規セッションが作成され、処理後には消滅する。自身で何かを起動することはできない | デフォルトではMiniMax M3(DeepSeek flash、次いでpro)。以下の4種類のバリエーションあり | ファイル操作、シェル、ウェブ検索、GPUボックス上のモデルや画像処理ツール、メール作成機能など。 |
| レビュアー | 完了した作業をチェックし、外部に送信される内容を管理する | Kimi K3(DeepSeek pro) | ファイル操作、シェル、ブラウザ、セッション履歴の閲覧機能。 |
| コンパニオン | 長時間にわたる対話用のペルソナエージェント。画像はモデル呼び出しではなく固定スクリプトから生成される | GPUボックス上で動作する27B規模のモデル(MiniMax M3) | ファイル操作、シェル、ウェブ検索。 |
| コーチ | 個人指導用のペルソナエージェント | GPUボックス上で動作する同じ27B規模のモデル(MiniMax M3) | ファイル操作、シェル、ウェブ検索、画像読み取り機能。 |
| セーフエージェント | 子供用端末からのみアクセス可能なエージェント | 高速なMiniMaxモデル(DeepSeek flash、次いでpro) | 読み取り機能およびウェブ検索のみ。シェルや画像処理ツールは使用不可。自身のフォルダ外のファイルにはアクセスできない。 |
ワーカーには4種類のバリエーションがあり、これらはリードがジョブを起動する際に選択するモデルの別名となります:
- fast:DeepSeek flash。参照検索や通常の編集作業用。
- think:MiniMax M3。実際の作業におけるデフォルトモデル。
- local:GPUボックス上で動作する27B規模のモデル。クラウドAPIを利用せずに行う個人用や大量処理用のジョブ向け。
- deep:別プロバイダー経由で利用可能なMiniMax M3。100万トークンまで対応し、多数のファイルを扱う長時間作業に適している。
4名ものワーカーを用意する代わりに1名のワーカーに4種類のバリエーションを持たせることで、さまざまなミスが減少しました。以前は各ワーカーがそれぞれ長期間継続するセッションや独自のルールを保持していましたが、現在ではルールは一箇所に集約され、各ジョブはクリーンな状態から開始されるようになりました。再編成後、専門的な指導用のエージェントもいくつか追加し、外部のコーディングエージェント2名とも連携させましたが、日常的な業務は上記6名でこなされています。
設定ファイルの見た目
上記の内容はすべて ~/.openclaw/openclaw.json に記載されています。これは私が使用しているエージェント設定の簡略版で、各IDはそれぞれの役割名に置き換えられています。キーや値も OpenClaw 2026.9.4で実際に使われているものです。
{
  "agents": {
    "defaults": {
      "models": {
        "deepseek/deepseek-v4-flash": { "alias": "worker-fast" },
        "minimax/MiniMax-M3":         { "alias": "worker-think" }
      },
      "subagents": { "maxSpawnDepth": 2, "maxConcurrent": 8 }
    },
    "entries": {
      "lead": {
        "model": {
          "primary": "minimax/MiniMax-M3",
          "fallbacks": ["deepseek/deepseek-v4-pro", "deepseek/deepseek-v4-flash"]
        },
        "subagents": { "allowAgents": ["worker", "reviewer"] },
        "tools": {
          "profile": "minimal",
          "alsoAllow": ["sessions_spawn", "read", "write", "edit", "exec", "web_fetch"],
          "deny": ["browser"]
        }
      },
      "worker": {
        "model": {
          "primary": "minimax/MiniMax-M3",
          "fallbacks": ["deepseek/deepseek-v4-flash", "deepseek/deepseek-v4-pro"]
        },
        "subagents": { "allowAgents": [] }
      },
      "safe": {
        "tools": {
          "allow": ["read", "web_fetch", "brave_search"],
          "deny": ["exec", "process"],
          "fs": { "workspaceOnly": true }
        }
      }
    }
  },
  "tools": {
    "agentToAgent": { "enabled": true, "allow": ["lead", "worker", "reviewer", "safe"] }
  }
}
その中でも主に機能を担っているのは以下の3つです:
fallbacksは順序付きのリストです。プライマリゲートウェイがダウンしたりレート制限にかかったりした場合、次のゲートウェイが試されるため、クラウド障害が発生しても応答が全くなくなることはありません。ただし応答速度は遅くなります。"profile": "minimal"およびalsoAllowは厳格な許可リストとなります。エージェントには最小限の機能と、指定されたツールのみが与えられます。denyの設定はこれらよりも優先されるため、拒否されたツールが誤って許可されることはありません。"allowAgents": []をワーカー側に設定すると、そのワーカーは子エージェントを生成できなくなります。つまり、1つのジョブが複数のタスクに分割されることが防がれます。
注意点として:リーダーから生成されたワーカーは、リーダー自身が持っているツールしか利用できません。私が再構築したゲートウェイ版では、生成されたワーカーには7つのツールしかなく、シェル機能も使えませんでした。これはリーダー側に exec 権限が与えられていなかったためです。もしワーカーの機能が不自然に制限されているように見える場合は、そのツール一覧を親エージェントのものと比較してみてください。
実際の作業の割り当て方
チャットでの応答は比較的簡単なケースです。より有用なやり方としては、大きな作業を依頼し、その処理を誰が行うかをリードエージェントに決定させることです。
リードエージェントは小さな作業を自身で行うことが許可されています。かつてはシェルコマンドの実行が一切禁止されていましたが、そうすると朝のサマリーの投稿といった簡単な作業すらできなくなるため、現在では再びシェルアクセスが認められています。基本的なルールとしては、短いコマンド程度なら問題ありませんが、それ以上の処理は必ずワーカーに任せることになっています。
実際の例
2026年9月15日に私はリードエージェントに対し、プログラミング用エージェントのウェブUIへアクセスするためのデスクトップショートカットが機能しなくなったと伝えました。実際には、そのサービスが再起動するたびに新しいアクセストークンが発行されるようになっており、ショートカットは単なるURLを指していたため401エラーが発生していました。リードエージェント自身はこの問題を修正しませんでした。代わりに作業内容の説明書を作成し、ワーカーを起動させたのです。以下がその説明書の概要です(短縮版):
Task:        Update the web-UI app shortcut so it survives the per-restart token rotation.
Context:     The UI serves only with a rotating ?token= query; the launcher
             points at the bare URL and gets 401.
Sources:     the .desktop file; the tool's --help; its source, for any flag
             or env var that gives a stable token, before reaching for a wrapper.
Constraints: No service restart, no config edits. Write surface: one .desktop
             entry and at most one wrapper script (~30 lines).
             Do NOT bake a static token into any file.
Output:      Result / Evidence / Files / Failed / Next.
Stop rules:  Two failures of the same tool = stop and report.
そのワーカーは該当ツールのヘルプやソースコードを調査した結果、安定したトークン値を取得する方法が存在しないことを確認しました。つまり、トークンは各プロセスごとにランダムに生成され、環境変数から読み取ることもできないのです。そこでワーカーは20行ほどのラッパープログラムを作成し、サービスの起動時のログから現在のトークン値を抽出してそのURLへアクセスするようにしました。また、そのログが存在しない場合には通常のURLへフォールバックする仕組みも加えました。最終的にショートカットはこのラッパープログラムを指すようになりました。この作業には125秒と46回のツール呼び出しが必要でした。ワーカーが用いたモデルは定額制プランに属するものでしたので、フォールバック処理が発生しなければ料金には一切影響しませんでした。
この説明書の中で特に重要な要素が3つあります。まず「書き込み対象」が明示されているため、ワーカーが勝手に設定ファイルを変更することが防げます。次に、単純な解決策である「固定値のトークン使用」も明確に排除されています。最後に「停止条件」により、ワーカーが失敗したコマンドを無限ループで実行する事態も防がれています。
完了した作業が確実に届くようにする
何も起こらず静かに終了してしまうジョブは、そもそも始まらなかったジョブよりも悪い状態です。なぜなら、自分で確認しない限り気づかないからです。私はこのチェック機能を二度にわたって実装しました。
バージョン1:パスユニットと5分間のタイマー(2026年6月~9月)
この仕組みは、最初の拙劣な試みを置き換えたものです。当初はcronジョブを用いて5分ごとにLLMを起動させ、トラッカーファイルを読み取らせていました。しかしこれでは各タイミングでモデルが起動され、本来検知すべきタイムアウトエラーさえ引き起こしてしまう状態でした。イベント駆動型の今回の方式では、監視すべきディスパッチが存在しない限りコストは一切発生しません。パスユニット部分が再利用可能なコードです:
# ~/.config/systemd/user/dispatch-watch.path
[Path]
PathModified=%h/agents/dispatch-tracker.md
Unit=dispatch-watch.service

[Install]
WantedBy=default.target

# ~/.config/systemd/user/dispatch-watch.service
[Service]
Type=oneshot
ExecStart=%h/bin/dispatch-arm.sh
そしてこれが起動用スクリプトの中核部分で、簡略化した形です。小さなPythonヘルパーに未完了のディスパッチのキーを尋ね、新しく得られた各キーごとに一時的なタイマーを設定しています:
for key in $(dispatch-watchdog --list-open); do
  grep -qx "$key" "$ARMED" && continue     # one follow-up per dispatch, ever
  systemd-run --user --on-active=5min \
    --unit="dispatch-followup-$key" \
    dispatch-watchdog --check "$key" && echo "$key" >> "$ARMED"
done
チェック処理で未完了のディスパッチが見つかると、トリアージ用のプロンプト付きでワーカーエージェントが起動されます。そのワーカーはセッション一覧を確認し、「DONE」「STILL-RUNNING」「FIXED」「ERROR」というコードワードのいずれかを返します。Pythonヘルパーはその状態をトラッカーファイルに記録するため、複数のエージェントが同じファイルを同時に編集することもありません。フリーズしたジョブも一度再ディスパッチされ、私にも通知が届きました。
バージョン2:実行フォルダーと常時稼働型のスキャナー(2026年9月6日以降)
バージョン1には盲点がありました。リード役が記録したジョブしか把握できず、かつワーカーが終了した際にもリード役が常に監視を続けていると仮定していました。しかし実際にはそうでない場合もあります。ワーカーは自身を生成したセッションが終了した後でも処理を完了させることができ、その場合ゲートウェイは完了通知を約30分間繰り返し送信したのちに諦めてしまいます。作業自体は完了しているにもかかわらず誰もそれを知ることがなかったのです。
現在では各ワーカーの最終処理として、自身の実行フォルダー内にreport.mdおよび小さなmeta.jsonという2つのファイルを作成します。絶えず稼働しているタイマーがこれらのフォルダーを巡回し、通常のパスユニットでは見逃してしまう事象も処理します(パスやフラグは適宜調整されます):
# runs-deliver.timer
[Timer]
OnBootSec=2min
OnUnitActiveSec=45s
AccuracySec=5s

# runs-deliver.service
[Service]
Type=oneshot
ExecStart=%h/bin/runs-deliver --once --root %h/agents/runs
Nice=10
IOSchedulingClass=idle
TimeoutStartSec=40
{
"id": "run-20260915-125334",
"kind": "spawn",
"status": "done",
"created": "2026-09-15T12:53:34Z",
"finished": "2026-09-15T12:55:31Z",
"delivered": true
}正常に終了した実行記録には個別のチャットメッセージは送られません。日次サマリーでその件数が報告されるからです。失敗した実行記録にはスレッド内に1行だけ記載されます。開始から3時間以上経過して終了した実行記録は「回復済み」として報告されます。上記の例では、通常のゲートウェイ経路を通じてリード役にも通知が届き、スキャナーもワーカーの終了から13秒後にその処理が完了したと判断しました。
どちらのバージョンから得られる教訓はこうです。ワーカーには必ずファイルを残させ、その対話内容に無関係な何かがそのファイルを読み取る仕組みを用意すべきだということです。
費用を決定する要因
各月や各プロバイダーごとに金額が変動するため、私は米ドルでの費用の記録を費用に関する記事のページにまとめています。最終的な請求額を決めるのは、どのような利用形態がなされているかです。
- 定額制のメインモデル。主に会話や作業を行うモデルはサブスクリプション制となっています。頻繁に利用しても請求額は増えず、ただプランの上限に達するだけです。
- 従量課金制のフォールバックモデル。これら背後で動作するDeepSeekモデルはトークン単位で課金されます。メインのプロバイダーに問題が生じた日には、自動的にこの従量課金制モデルへと負荷が移行します。
- ローカルモデルは電力費用のみ。補助的な役割を果たすローカル版のモデルやメモリ検索機能(ローカルの埋め込みモデル)は有料APIを一切利用しないため、常時バックグラウンドで実行される処理も無料です。
- 長時間のセッションが最も費用がかさむ。各発言ごとにこれまでの会話内容が再送信されます。請求額が急増した際には、まずコンテキストの制限や長いセッションの短縮化を行うことで対処します。
破ってはならないルール
エージェントを生成したりツールを実行したりできるゲートウェイには、たとえモデルが不適切な挙動を示しても守られるべき制限が必要です:
- カメラ、画面録画、SMS、連絡先、カレンダー、リマインダーの各コマンドはゲートウェイの禁止リストに含まれており、エージェントはこれらを一切呼び出せません。
- 安全なエージェントには、読み取り用ツールやウェブ検索用ツールのみが明示的に許可されており、その上でシェルや画像処理用ツールも禁止されています。
- プラグインは厳格に定められた11種類のみが許可されています:モデルプロバイダー5つ、ウェブ検索機能、ヘッドレスブラウザ、メモリ関連プラグイン2つ、メールブリッジ、そして外部のコーディングエージェント用ブリッジです。他のものは、インストール済みであっても一切読み込まれません。
- サイトのデプロイやメール送信など何らかの情報を公開する処理は、デフォルトでドライランのみとなり、実際の実行には私の明示的な承認が必要です。メール下書きも、エージェントによって決して送信されることはありません。
注意点/落とし穴
実際に私が遭遇した問題を、起きた順番に沿って紹介します:
- ローカルで動作する推論モデルでは
reasoning: trueを明示的に設定する必要があります。 私が使っているモデルは、回答の前に別途推論用のストリームを送信します。このフラグが設定されていないと、ゲートウェイ側では応答がないと判断して、約6分半後にリクエストを強制終了させてしまいます。 - すべてのタイムアウト値はデフォルトでクラウド環境用の値になります。 性能の低いハードウェア上で大規模なモデルを動かすと、単に計算中であるにもかかわらず応答がないように見えます。私のプロバイダー設定ではリクエストタイムアウトは20分、エージェント処理のタイムアウトは1時間となっています。これらの値を引き上げる前は、ローカルで長時間実行されるジョブが途中で強制終了されていました。
- LM StudioのAppImageは、メモリ不足時に
/tmpのFUSEマウントが再構成されるとSIGBUSエラーでクラッシュしました(このPCでは当時まだLM Studioを動かしていました)。これは純粋なバスエラーであり、OOMキラーとは無関係でした。AppImageを展開して通常の systemd サービスとして実行することで問題が解消されました。 - メッセージ送信用の許可リストは大文字小文字を区別しますが、ゲートウェイ側ではエージェントIDを小文字に変換します。 すべてのIDを小文字に統一しないと、エラーもログも一切出ずにクロスエージェント間の送信が失敗してしまいました。
- かつてはクロスエージェントメッセージングには2つの設定が必要でした:機能フラグとセッション可視性の設定です。2026年半ば頃のゲートウェイではそうでしたが、新しいバージョンではデフォルトで可視性が「公開」になるため、デバッグする際にはご自身のバージョンを確認してください。
- シェルのリダイレクト設定によって、ウォッチドッグのエラーメッセージが消えてしまいました。 起動用スクリプトでは
exec 9>"$LOCK" 2>/dev/nullという記述でロックファイルを開いていました。コマンドが指定されていない場合、execによってその後のすべてのリダイレクトがシェル全体に適用されるため、「arm化に失敗した」といったエラー出力も全て消えてしまいました。ロックファイル作成時のみリダイレクトを適用し、その後はexec 9>>"$LOCK"とするように修正しました。 - すべてのエスカレーション処理で同一セッションを再利用していたため、データが肥大化してしまいました。 バージョン1ではすべての処理を同じワーカーセッション内で行っていました。その結果、データサイズが5.75 MBまで増大し、処理が滞るようになりました。現在では各エスカレーションごとに別々のセッションキーを使用しています。
- あるエージェントが自身の不適切な設定を再び読み込んでしまったことがあります。 アイデンティティ整合化処理の際に古いワークスペースファイルが再挿入され、ゲートウェイがクラッシュループ状態になってしまいました。設定ファイルだけでなく、元となるソースファイルも修正する必要があります。
- プラグイン許可リストに何かを記載した場合は、それが絶対条件となります。 プラグインIDが許可リスト内に存在しない限り
enabled: trueの設定は無効となりますが、その旨を示すメッセージは一切出ません。この仕様は モデルマネージャーの説明ページにも記載されています。
関連記事:同じPCでこのウェブサイトをどう管理しているか、OpenClaw上で動作するMiniMax M3コーディングエージェント、そしてモデル選定に用いているベンチマークもご覧ください。