Huit agents IA, un seul boîtier AMD : ma stack d'agents locaux (OpenClaw)
- Catégorie
- IA et LLM locaux
- Publié
- 11 juillet 2026
- Mis à jour
- 26 août 2026
- Par
- Jacob Lloyd — rédigé avec l'aide de l'IA, une fois le projet terminé
- Temps de lecture
- 12 min de lecture

En clair : Une visite guidée des huit assistants IA qui tournent sur un seul petit ordinateur chez moi, chacun avec son propre nom et son propre rôle — des questions de la famille aux brouillons d'e-mails. La majorité du travail ne coûte rien car il tourne en local, et les conversations privées ne quittent jamais la maison. Un aperçu de ce à quoi peut ressembler une installation d'IA domestique sans frais mensuels.
Il y a en ce moment huit agents IA nommés qui vivent sur un mini PC chez moi. Ils ont des rôles, une hiérarchie, et un chat de groupe que toute ma famille peut ouvrir depuis un téléphone. Les faire tous tourner coûte environ 24 $ par mois — l'API pas chère de DeepSeek assure la réflexion du quotidien, et les tâches qui ne doivent pas sortir de la maison tournent sur des modèles locaux gratuits.
tl;dr
- Ce que c'est : OpenClaw, une passerelle d'agents IA auto-hébergée, qui fait tourner 8 agents nommés — chacun avec son rôle, son routage de modèle et ses permissions d'outils — derrière une appli de chat que j'ai construite.
- Ce que ça coûte : environ 24 $/mois d'API DeepSeek pour le travail quotidien ; 0 $ pour les modèles locaux qui couvrent la vision et le travail privé.
- Ce qu'il vous faut : une machine Linux avec 32 Go de RAM (la mienne est un mini PC CHUWI AuBox), et de la patience pour systemd. Une seconde machine avec de vrais GPU est facultative et change ce que le palier local peut faire.
- Ce que vous obtenez : une seule URL de chat pour toute la maison, des agents qui se passent le travail et relancent ceux qui se taisent, de la génération d'images à la demande, et des brouillons d'e-mails que rien n'envoie sans moi.
Ce qu'on obtient
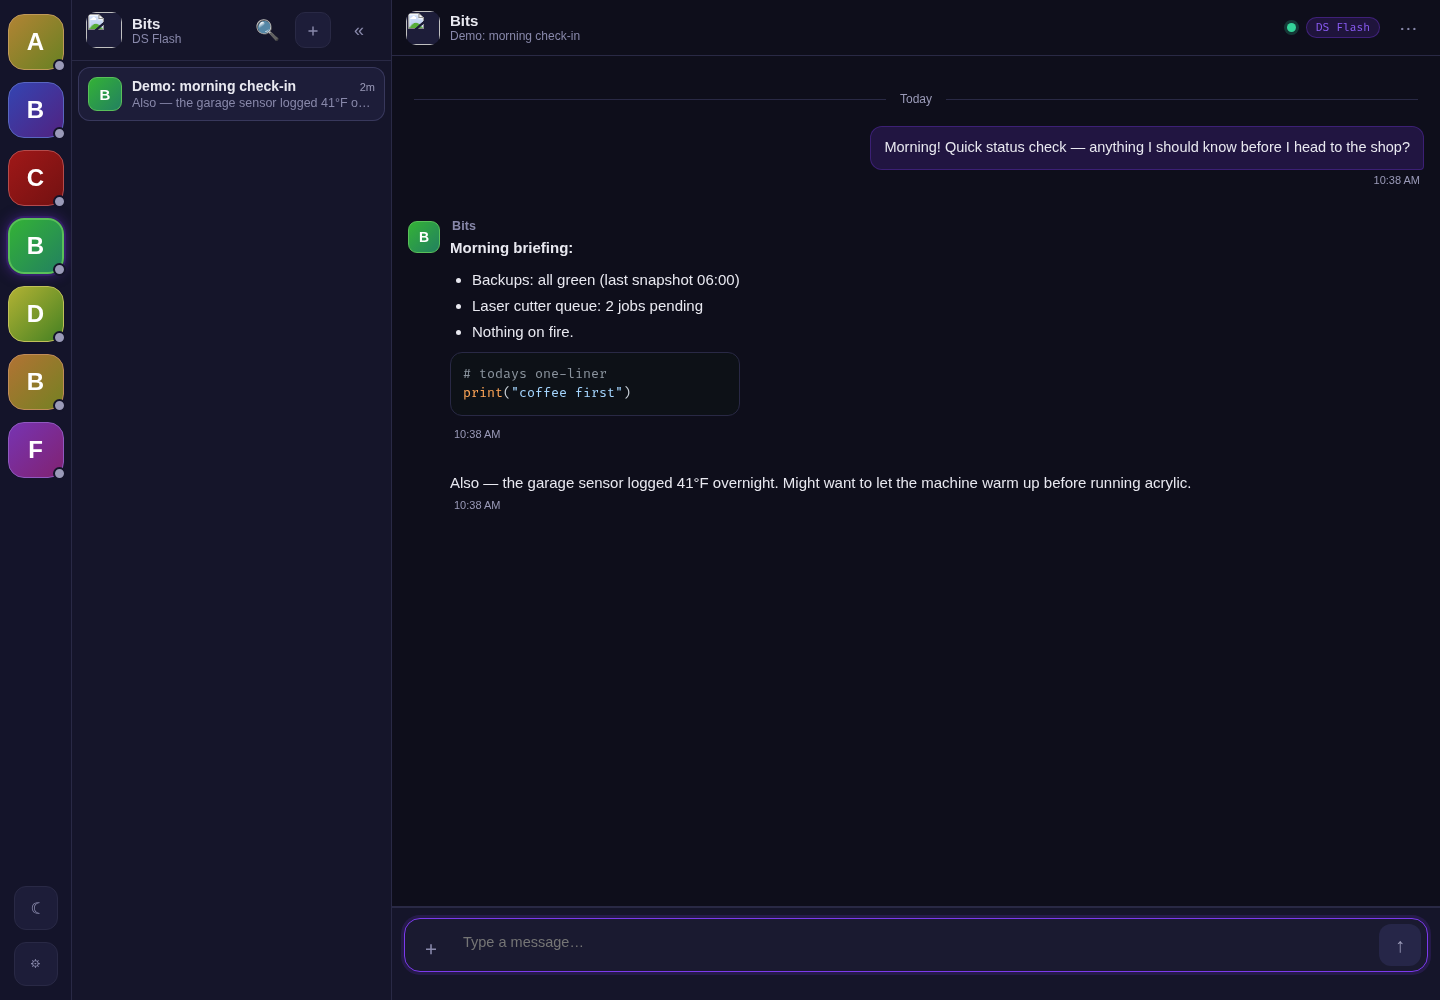
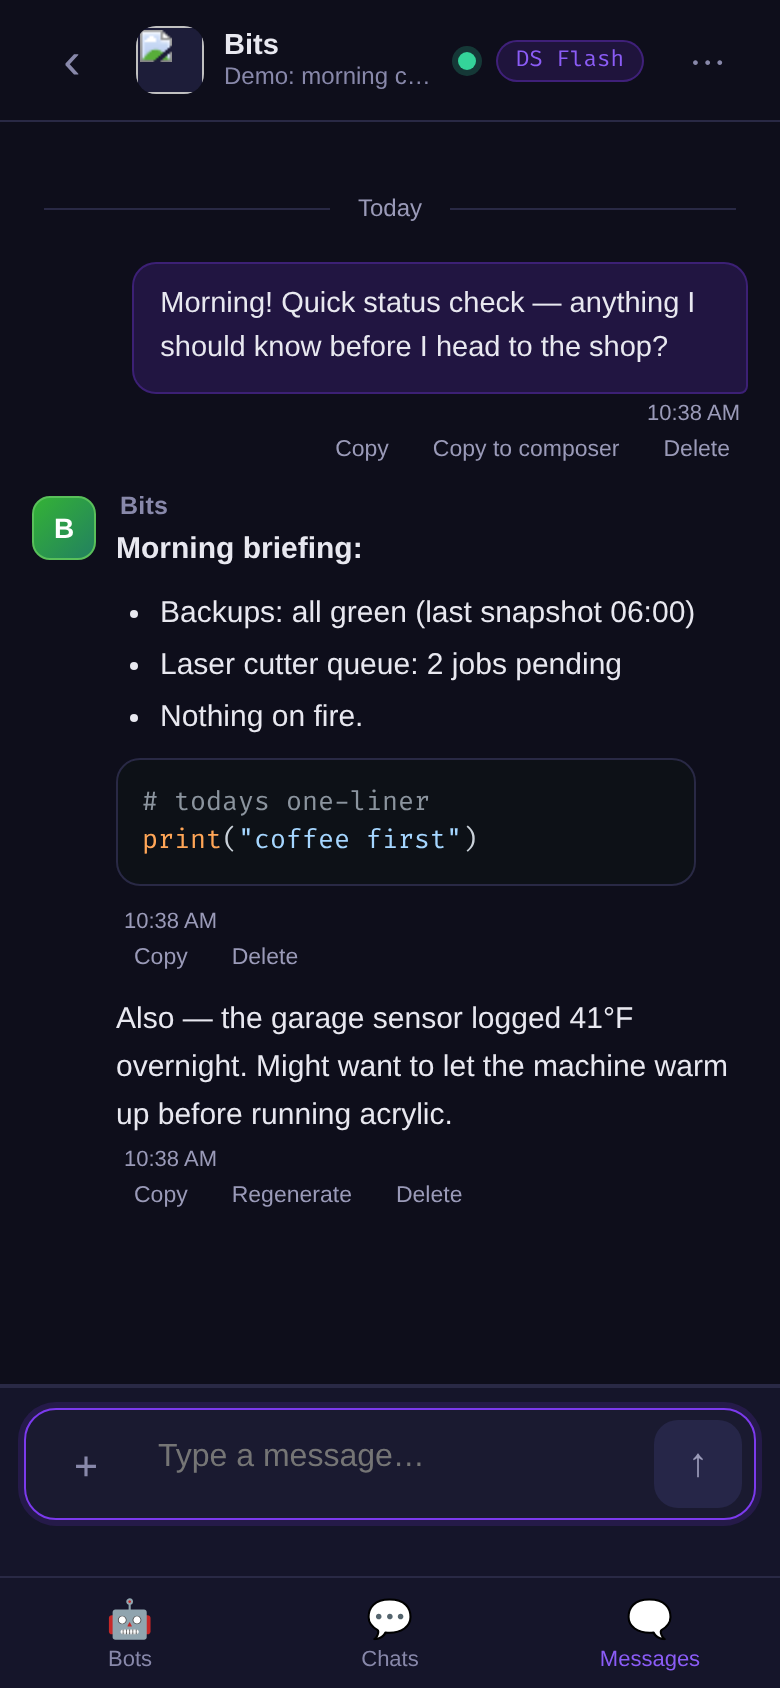
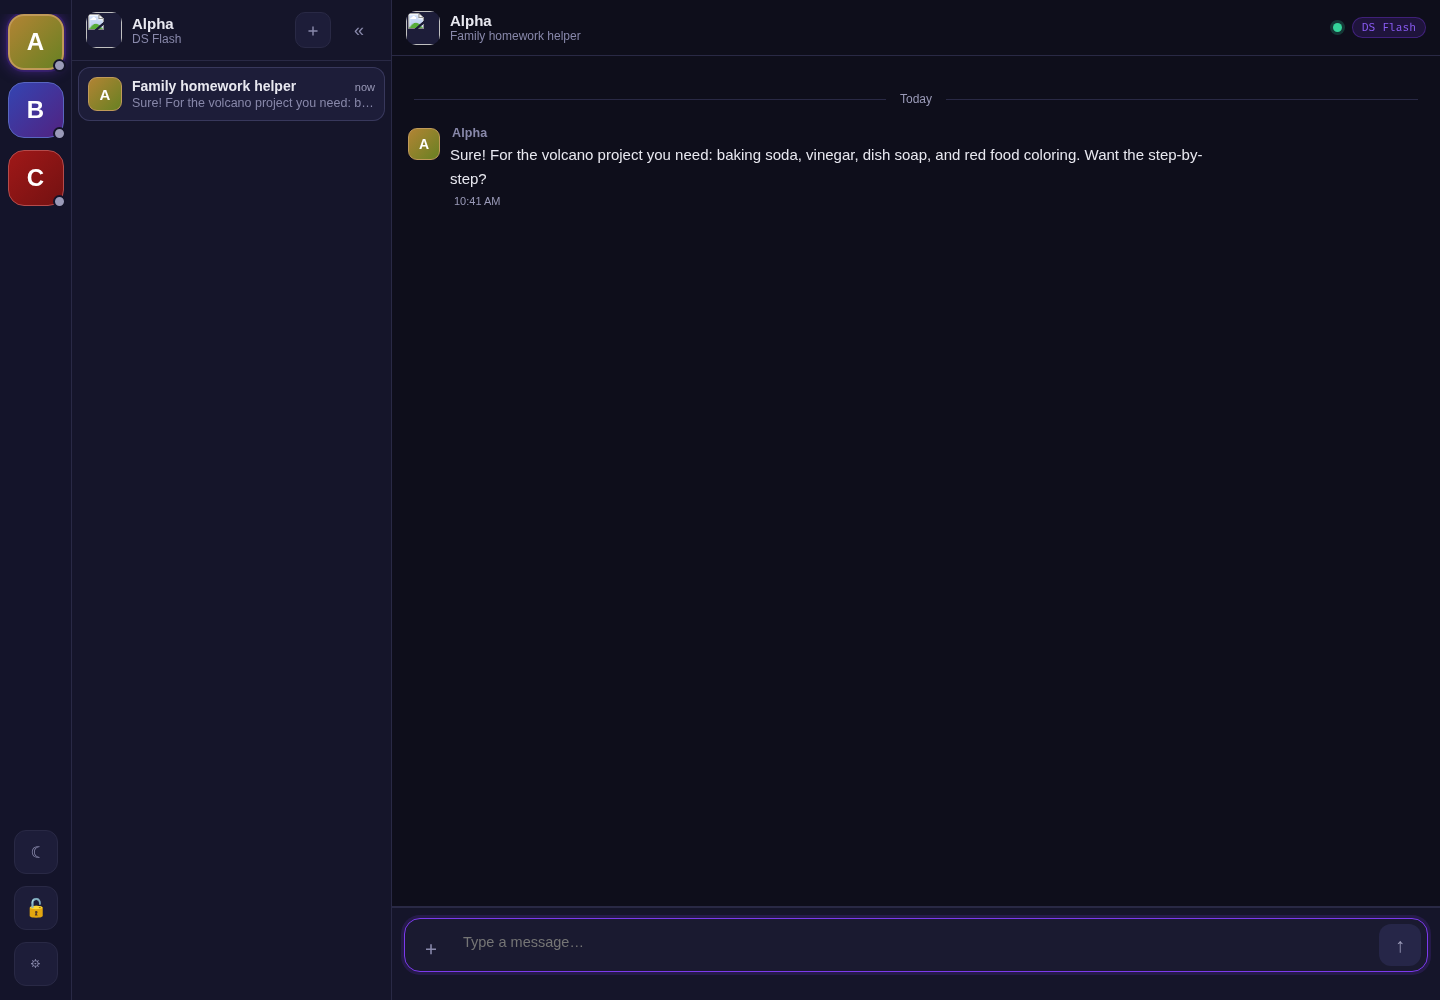
Le quotidien d'abord. Voici DisPatch, l'appli de chat que j'ai construite devant la passerelle — les captures sont des données de démo en bac à sable tirées de cet article, mes vrais fils de discussion restent les miens.
| Quoi | Le chiffre |
|---|---|
| Agents nommés | 8 (Bits, Flash, Brains, Hermes, Doxy, Charley, Alpha, Beta) |
| Modèles cloud dans la table de routage | 2 (DeepSeek flash et pro) |
| Entrées de modèles locaux | une poignée sur le boîtier principal, le reste servi depuis un boîtier GPU sur mon réseau |
| Plus gros modèle local | un MoE à 122 milliards de paramètres sur le boîtier GPU ; le mini PC lui-même plafonne vers 7B |
| Facture cloud mensuelle mesurée | environ 24 $ (DeepSeek, le principal poste) |
| Port de la passerelle | 18789 |
| Port du chat | 8765, sur le réseau domestique |
| Sauvegarde nocturne | 02:17 |
| Battement de cœur de la passerelle | toutes les 2 heures |
| Fenêtre du chien de garde | 5 minutes, puis un travailleur silencieux se fait relancer |
Le boîtier
La passerelle et tout ce qui tourne autour fonctionnent sur une seule petite machine. Pas de rack, pas de location de GPU cloud, pas de deuxième hypothèque.
- CHUWI AuBox Ai365 — AMD Ryzen AI 9 365 (« Strix Point »), 10 cœurs, GPU intégré Radeon 880M
- 30 Go de DDR5 utilisable, partagée entre l'OS et tout le reste — pas de réserve de VRAM digne de ce nom
- 1 To de NVMe, avec Bluefin (immuable, basé sur Fedora Atomic)
- ROCm, pas CUDA, pour ce qui tourne en local — il se comporte un peu différemment de ce que supposent les tutoriels, mais ça marche
C'est le deuxième boîtier à occuper ce poste. Le premier était un ROG Flow Z13 de 128 Go avec 64 Go réservés en VRAM, qui faisait tourner localement un modèle mixture-of-experts de 120 milliards de paramètres jusqu'à ce qu'il développe une panne d'alimentation en juillet. Les anciens articles ici décrivent cette machine ; c'est ce qui l'a remplacée, et il a un quart de la mémoire.
Ce qui a rendu ça surmontable, c'est l'autre moitié de l'installation : un second PC sur mon réseau avec de vrais GPU dedans, qui sert les gros modèles via StudioForge, un serveur compatible OpenAI que j'ai écrit exactement pour ça. Le palier 120B y a déménagé plutôt que de disparaître, et la génération d'images l'a suivi. Le mini PC garde un petit modèle et le modèle d'embedding pour le travail privé ; tout ce qui est plus gros passe par le réseau.
La distribution
Plutôt qu'un seul onglet de chat qui parle à un seul modèle, j'ai un petit bureau. Chacun a un rôle et un modèle adapté — le cloud DeepSeek pas cher pour l'essentiel du travail, des modèles locaux gratuits là où la confidentialité ou la vision comptent. (Les modèles locaux étaient le plan de départ ; en pratique, leurs temps de chargement et leur plafond plus bas en ont fait le palier de secours, pas celui par défaut.)
| Agent | Rôle | Modèle principal | Tourne sur |
|---|---|---|---|
| Bits | Accueil. Me parle, n'exécute elle-même aucun outil, délègue tout | DeepSeek (cloud, palier pro) | cloud |
| Flash | Tâches rapides — résumés, recherches, modifications de routine. Zéro personnalité, outil pur | DeepSeek (cloud, palier flash) | cloud |
| Brains | Réflexion de fond — architecture, débogage, relecture de code | DeepSeek (cloud, palier pro) | cloud |
| Hermes | Déploiements et codage, relié via un runtime d'agent séparé. Dry-run par défaut ; les vrais déploiements ont besoin de mon feu vert explicite | DeepSeek (cloud, palier pro) | cloud |
| Doxy | Travail de fond en masse. Aucun compteur d'API sur un modèle local, donc ça tourne toute la nuit gratuitement | un modèle dense de 27B (local) | le boîtier GPU |
| Charley | Vision — regarde vraiment les captures d'écran, les diagrammes, les fenêtres d'erreur | Gemma-4, compatible vision (local) | le boîtier GPU |
| Alpha / Beta | Bots d'« accueil » sûrs pour les appareils de la famille, outils en lecture seule uniquement | flash (cloud) / Gemma-4 26B (local) | cloud / le boîtier GPU |
Chaque agent a des modèles de secours — si le principal est occupé ou en panne, il bascule discrètement sur un modèle de repli, cloud ou local. Beta et Charley sont strictement limités aux outils en lecture seule : chercher des infos, faire des images, jamais toucher aux fichiers ni exécuter de commandes. Exactement ce qu'on veut d'un bot qu'un enfant de dix ans peut ouvrir. La messagerie entre agents est activée, verrouillée par une liste blanche de qui peut parler à qui.
Les pièces
Rien de tout ça n'est un seul programme. Ce sont huit petits services, chacun avec une seule tâche, tous supervisés par systemd plutôt que par un script nounou.
| Service | Ce qu'il fait | Où |
|---|---|---|
openclaw-gateway.service | La passerelle OpenClaw — le cerveau de la stack | port 18789, loopback uniquement, auth par jeton |
local-chat.service | DisPatch, le frontend de chat | port 8765, LAN |
lm-studio.service | Serveur de modèles locaux (un AppImage extrait) qui sert les modèles du boîtier, plus le modèle d'embedding | port 1234, local |
| le boîtier GPU | Les gros modèles via StudioForge, et la génération d'images — les deux à travers le réseau, ni l'un ni l'autre sur cette machine. Le ComfyUI local habitait ici et n'y habite plus ; il n'y a pas assez de mémoire pour lui et un modèle de langage en même temps. | un second PC, via Tailscale |
mailforge.service | MailForge — tri des e-mails — rédige des réponses, n'en envoie jamais | — |
hermes-gateway.service | Une passerelle séparée qui relie l'agent de déploiement/codage | — |
openclaw-backup.timer | Sauvegarde nocturne | se déclenche à 02:17 |
dispatch-tracker-watch.path | Le déclencheur du chien de garde (détails plus bas) | — |
Chaque unité se redémarre toute seule en cas d'échec, réglée pour qu'un crash coûte quelques secondes d'indisponibilité, pas un appel à 2 heures du matin. L'unité LM Studio vérifie l'état de sa propre API avant de se déclarer prête. La config de la passerelle se recharge à chaud, donc la plupart des changements de routage ne demandent aucun redémarrage. La mise à jour automatique est désactivée exprès — une mise à jour a cassé la stack exactement une fois, et depuis, les montées de version se font sur mon calendrier. Pour vérifier tout le zoo :
systemctl --user status openclaw-gateway local-chat lm-studio
journalctl --user -u openclaw-gateway -f
Comment un message de chat se déplace réellement
Le trajet est celui qu'on devine : navigateur → DisPatch → passerelle → le modèle de l'agent, local ou cloud, et retour par le même chemin. Deux détails comptent : si le modèle principal est occupé ou en panne, un modèle de secours répond à sa place, et la livraison retour vers le navigateur est confirmée par des chemins redondants, donc une connexion coupée ne perd pas le message.
Faire du vrai travail
Les réponses de chat, c'est le cas facile. Le schéma utile, c'est de demander quelque chose de gros et de laisser le roster décider qui s'en occupe.
Le gros du travail — longs refactorings, modifications en masse, tout ce qui est ennuyeux — part chez Doxy sur le modèle local gratuit, qui va broyer pendant une heure pour le prix de l'électricité. Le travail d'images en masse part vers le même boîtier GPU.
Se surveiller soi-même
Un travail délégué qui meurt en silence est pire qu'un travail jamais commencé — on ne le découvre qu'en allant vérifier. D'où un chien de garde, la seule pièce de cette stack dont je suis vraiment fier.
Ça a remplacé une idée franchement mauvaise : un cron LLM perpétuel toutes les cinq minutes. Il spammait le modèle et provoquait lui-même ses propres dépassements de délai — le chien de garde créait exactement le problème qu'il était censé attraper. La version pilotée par événements ne s'arme que quand il y a un envoi à surveiller, puis s'efface dans tous les cas.
Ce que ça coûte
L'économie, c'est tout l'intérêt de séparer le roster. Tarifs cloud, par million de jetons :
| Modèle | Entrée | Sortie |
|---|---|---|
| DeepSeek palier flash (Flash, Alpha) | 0,14 $ / M jetons | 0,28 $ / M jetons |
| DeepSeek palier pro (Bits, Brains, Hermes) | 0,435 $ / M jetons | 0,87 $ / M jetons |
| Modèles locaux — Doxy, Charley et Beta, tous sur le boîtier GPU | 0 $ | 0 $ |
Même le palier « cher » représente des fractions de centime par requête typique. La vraie économie tient à l'endroit où se trouve le volume : les tâches répétitives de plusieurs milliers de jetons partent vers le modèle local gratuit ; le compteur cloud ne tourne que pour les jugements qui comptent. La recherche en mémoire tourne elle aussi sur un modèle d'embedding local, donc les recherches constantes en arrière-plan ne touchent jamais non plus une API payante.
Les règles qu'il ne franchira pas
Une passerelle capable de lancer des agents et d'exécuter des outils a besoin de garde-fous qui ne dépendent pas de la bonne volonté du modèle.
- L'accès à la caméra, l'enregistrement d'écran, les SMS et les commandes contacts/calendrier sont refusés d'office au niveau de la passerelle — pas « l'agent ne devrait pas », vraiment bloqué.
- Beta et Charley n'ont que des outils en lecture seule. Pas d'écriture de fichiers, pas de shell, peu importe la gentillesse de la demande.
- Les plugins suivent une liste blanche stricte de sept éléments : deux fournisseurs de modèles locaux, DeepSeek, la recherche web Brave, un navigateur headless, la mémoire agent-à-agent, et le pont de déploiement. Rien d'autre ne se charge, installé ou non.
- Hermes — le seul agent qui peut toucher la production — fait du dry-run par défaut. Un vrai déploiement a besoin de mon feu vert explicite, et les déploiements de mon site professionnel sont derrière le même verrou.
Pièges à éviter
La liste honnête — ce qui a vraiment cassé, dans l'ordre où ça m'a mordu :
- Les modèles locaux ont besoin de
reasoning: trueexplicite. Les miens émettent un flux de raisonnement séparé avant la vraie réponse ; avec le drapeau mal réglé, la passerelle prenait ça pour un blocage et tuait la requête vers 6,5 minutes. Le modèle n'était pas coincé — il réfléchissait à voix haute sur un canal que la passerelle ne connaissait pas. - Tous les délais par défaut sont calibrés pour la vitesse du cloud. Un 120B sur un iGPU est lent, pas cassé. J'ai relevé les délais de fournisseur, de tour et d'abandon à environ 20, 30 et 35 minutes ; avant ça, les longues tâches se faisaient tuer en plein raisonnement pour le crime d'être locales.
- L'AppImage de LM Studio plantait avec un SIGBUS chaque fois que son point de montage FUSE
/tmpétait recyclé sous pression mémoire — une vraie erreur de bus, pas un kill OOM. Extraire l'AppImage et le faire tourner comme un simple service systemd a réglé le problème. - La liste blanche de messagerie est sensible à la casse, mais la passerelle met les ID d'agents en minuscules en interne. Les envois entre agents échouaient jusqu'à ce que j'ajoute des doublons en minuscules de chaque nom. Aucune erreur, aucune ligne de log — juste rien qui n'arrivait.
- La messagerie entre agents a besoin de deux interrupteurs séparés — le drapeau de fonctionnalité et le réglage de visibilité de session. Activez l'un sans l'autre, et le réglage par défaut bloque silencieusement chaque envoi.
- Un chien de garde LLM planifié est une panne auto-infligée — l'histoire du cron toutes les cinq minutes ci-dessus. Le pilotage par événements a largement battu le planifié.
- Un agent a un jour ressuscité sa propre mauvaise config. Une passe de réconciliation d'identité a réinjecté un fichier d'espace de travail périmé et a fait boucler la passerelle en crash-loop. Une config qu'un agent peut toucher est une config qui peut vous mordre en retour.
- Une liste blanche de plugins non vide est absolue. Marquer une entrée
enabled: truene sert à rien si son ID n'est pas aussi dans la liste blanche. C'est la liste blanche qui gagne, en silence.
À voir aussi : StudioForge, le boîtier GPU qui sert les gros modèles, le benchmark que j'utilise pour décider quel modèle fait quel travail, DeepSeek Harness, un autre agent de codage qui vit sur le même boîtier, et ce que tout cela coûte vraiment.