Acht KI-Agenten, eine AMD-Kiste: Mein lokaler Agenten-Stack (OpenClaw)
- Kategorie
- KI & lokale LLMs
- Veröffentlicht
- 11 Juli 2026
- Aktualisiert
- 26 August 2026
- Von
- Jacob Lloyd — mit KI-Unterstützung geschrieben, im Nachhinein
- Lesezeit
- 9 Min. Lesezeit

Kurz gesagt: Eine Führung durch die acht KI-Helfer, die auf einem kleinen Computer bei mir zu Hause laufen, jeder mit eigenem Namen und eigener Aufgabe — von Familienfragen beantworten bis E-Mail-Entwürfe schreiben. Der Großteil der Arbeit kostet nichts, weil er lokal läuft, und private Unterhaltungen verlassen nie das Haus. Es zeigt, wie ein KI-Setup fürs Zuhause aussehen kann, ganz ohne monatliche Gebühren.
Auf einem Mini-PC bei mir zu Hause leben gerade acht KI-Agenten mit Namen. Sie haben Aufgaben, eine Hackordnung und einen Gruppenchat, den meine ganze Familie vom Handy aus öffnen kann. Der Betrieb aller acht kostet etwa 24 $ im Monat — DeepSeeks günstige API übernimmt das tägliche Denken, und die Jobs, die das Haus nicht verlassen sollen, laufen auf kostenlosen lokalen Modellen.
tl;dr
- Was es ist: OpenClaw, ein selbstgehostetes KI-Agenten-Gateway mit 8 namentlichen Agenten — jeder mit eigener Aufgabe, eigenem Modell-Routing und eigenen Tool-Berechtigungen — hinter einer selbstgebauten Chat-App.
- Was es kostet: etwa 24 $/Monat DeepSeek-API für die Alltagsarbeit; 0 $ für die lokalen Modelle, die Vision und private Jobs abdecken.
- Was du brauchst: eine Linux-Kiste mit 32 GB RAM (meine ist ein CHUWI AuBox Mini-PC) und Geduld für systemd. Eine zweite Maschine mit echten GPUs ist optional und verändert, was die lokale Stufe leisten kann.
- Was am Ende dabei rauskommt: eine Chat-URL fürs ganze Haus, Agenten, die sich gegenseitig Arbeit zuschieben und stillgewordenen Kollegen hinterherjagen, Bildgenerierung auf Abruf, und E-Mail-Entwürfe, die ohne mich nichts verschicken.
Was am Ende dabei rauskommt
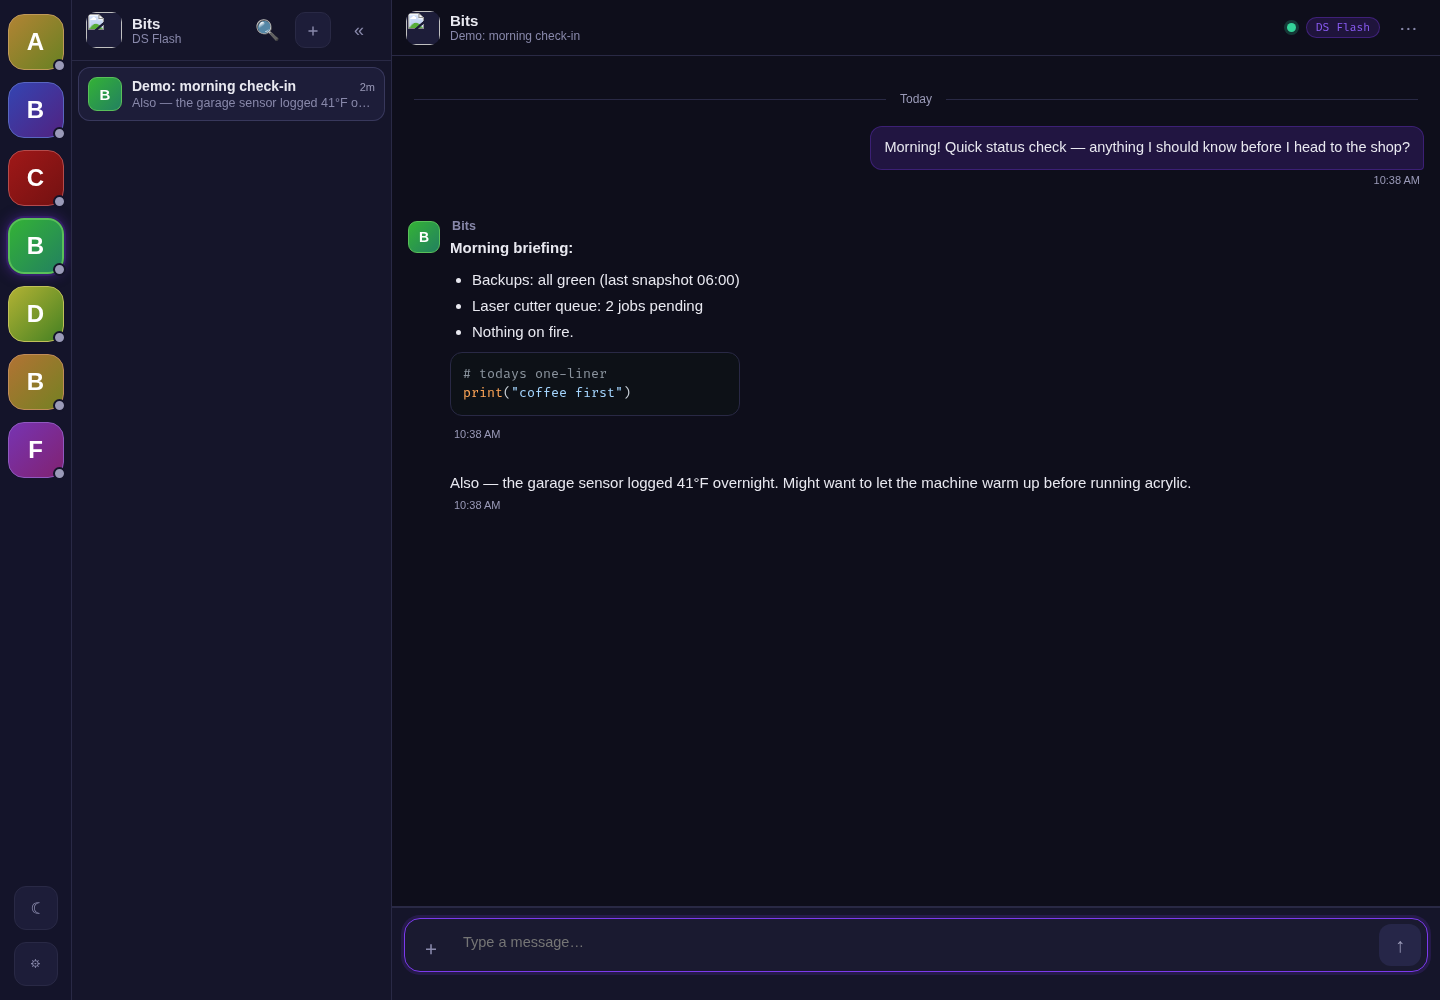
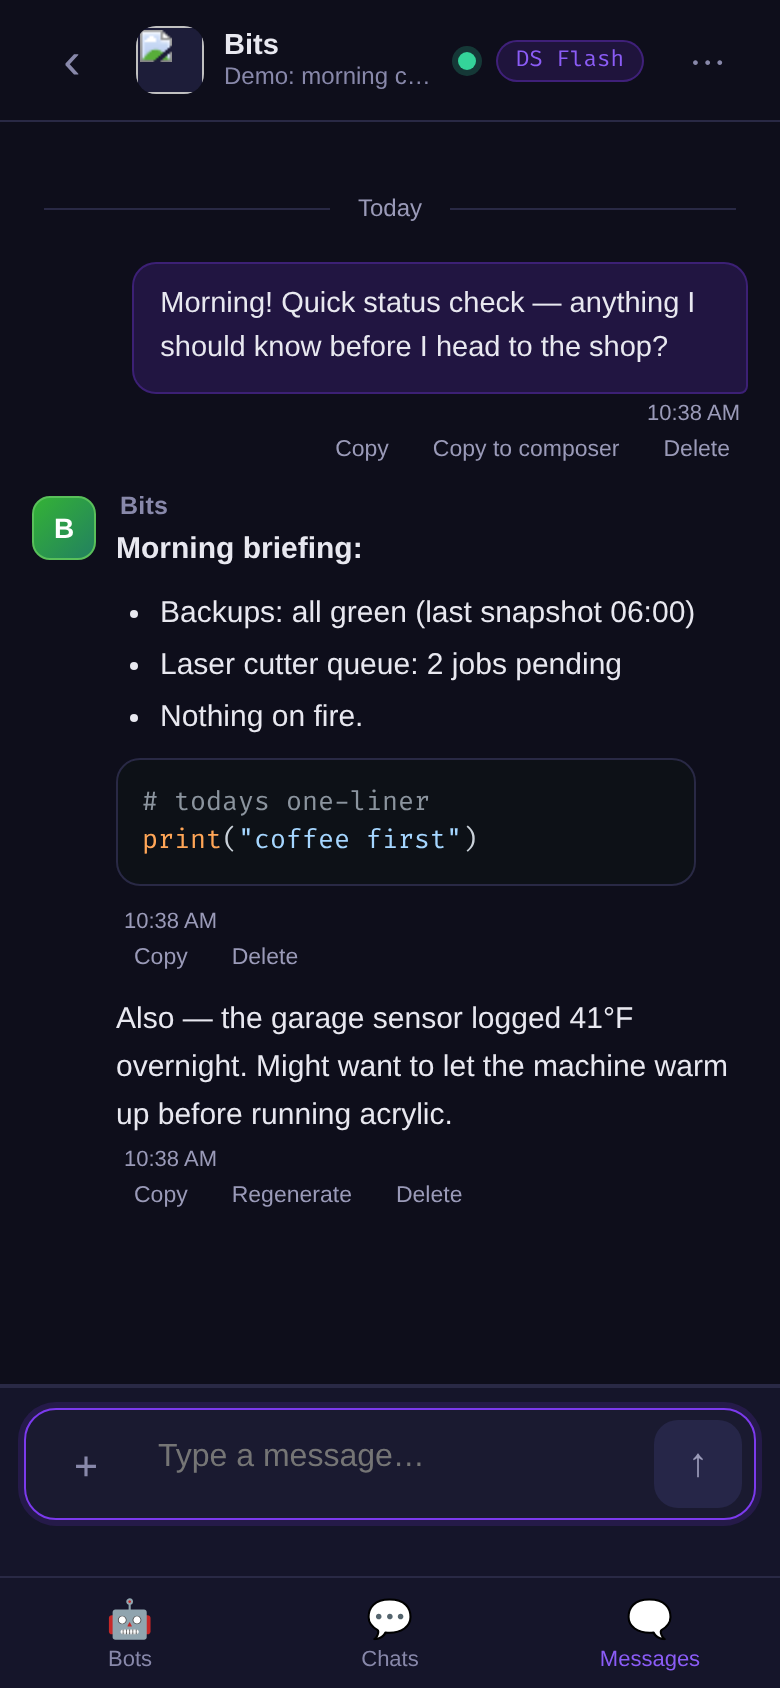
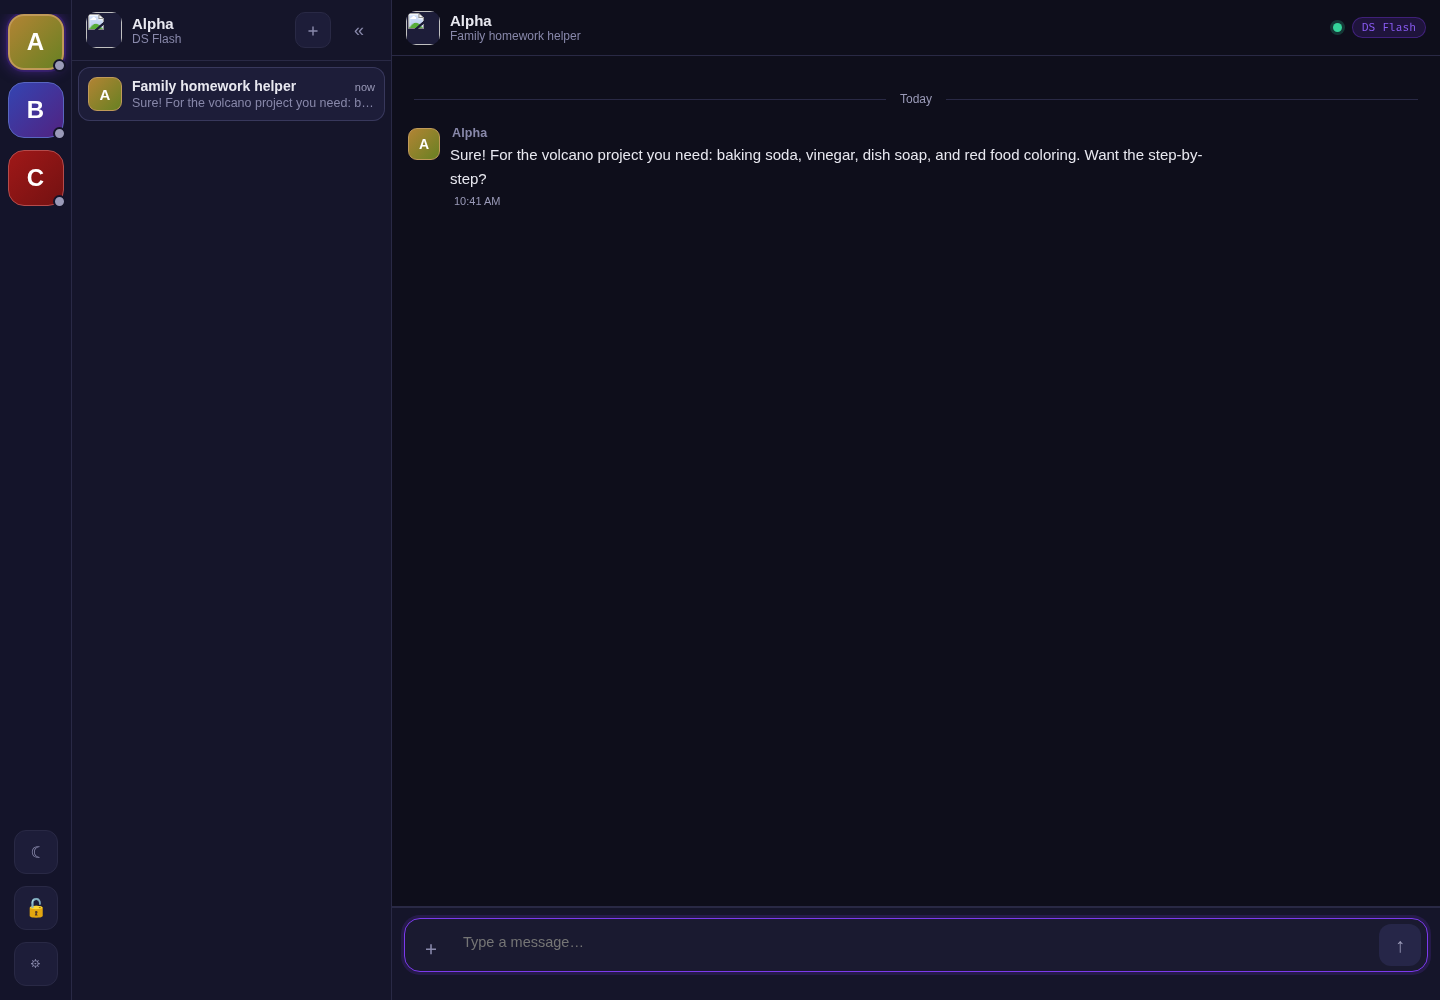
Erst das Tagesgeschäft. Das ist DisPatch, die Chat-App, die ich gebaut habe, um dem Gateway ein Gesicht zu geben — die Screenshots sind Sandbox-Demodaten aus diesem Write-up, meine echten Threads bleiben meine eigenen.
| Was | Die Zahl |
|---|---|
| Namentliche Agenten | 8 (Bits, Flash, Brains, Hermes, Doxy, Charley, Alpha, Beta) |
| Cloud-Modelle in der Routing-Tabelle | 2 (DeepSeek Flash und Pro) |
| Lokale Modell-Einträge | eine Handvoll auf der Hauptkiste, der Rest von einer GPU-Kiste in meinem Netzwerk bedient |
| Größtes lokales Modell | ein 122B-MoE auf der GPU-Kiste; der Mini-PC selbst kommt auf höchstens rund 7B |
| Gemessene monatliche Cloud-Rechnung | etwa 24 $ (DeepSeek, der Haupttreiber) |
| Gateway-Port | 18789 |
| Chat-Port | 8765, im Heimnetzwerk |
| Nächtliches Backup | 02:17 Uhr |
| Gateway-Heartbeat | alle 2 Stunden |
| Watchdog-Fenster | 5 Minuten, dann wird ein stumm gewordener Worker gejagt |
Die Kiste
Das Gateway und alles drumherum laufen auf einer kleinen Maschine. Kein Rack, keine gemietete Cloud-GPU, keine zweite Hypothek.
- CHUWI AuBox Ai365 — AMD Ryzen AI 9 365 ("Strix Point"), 10 Kerne, integrierte Radeon-880M-GPU
- 30 GB nutzbares DDR5, geteilt zwischen dem OS und allem anderen — keine nennenswerte VRAM-Abzweigung
- 1 TB NVMe, läuft unter Bluefin (unveränderlich, auf Fedora Atomic basierend)
- ROCm, nicht CUDA, für das, was lokal läuft — es verhält sich stellenweise etwas anders, als die Tutorials annehmen, funktioniert aber
Das ist die zweite Kiste, die diesen Job übernimmt. Die erste war ein 128-GB-ROG Flow Z13 mit 64 GB als VRAM abgezweigt, der lokal ein 120B-Mixture-of-Experts-Modell ausführte, bis er im Juli einen Stromfehler entwickelte. Ältere Beiträge hier beschreiben diese Maschine; das hier ist der Ersatz, und er hat ein Viertel des Speichers.
Was das überlebbar machte, ist die andere Hälfte des Setups: ein zweiter PC in meinem Netzwerk mit echten GPUs darin, der die großen Modelle über StudioForge bedient, einen OpenAI-kompatiblen Server, den ich genau dafür geschrieben habe. Die 120B-Stufe ist dorthin umgezogen statt zu verschwinden, und die Bildgenerierung ging mit. Der Mini-PC behält ein kleines Modell und das Embedding-Modell für private Arbeit; alles Größere geht übers Netzwerk.
Die Besetzung
Statt eines Chat-Tabs, das mit einem Modell spricht, habe ich ein kleines Büro. Jeder hat eine Aufgabe und ein passendes Modell — günstige DeepSeek-Cloud für den Großteil der Arbeit, kostenlose lokale Modelle dort, wo Privatsphäre oder Vision wichtig sind. (Die lokalen Modelle waren der ursprüngliche Plan; in der Praxis machten ihre Ladezeiten und die niedrigere Obergrenze sie zur Fallback-Stufe, nicht zum Standard.)
| Agent | Aufgabe | Primärmodell | Läuft auf |
|---|---|---|---|
| Bits | Empfang. Spricht mit mir, macht selbst null Tool-Arbeit, verteilt alles weiter | DeepSeek (Cloud, Pro-Stufe) | Cloud |
| Flash | Schnelle Jobs — Zusammenfassungen, Nachschlagen, Routine-Edits. Null Persönlichkeit, reines Werkzeug | DeepSeek (Cloud, Flash-Stufe) | Cloud |
| Brains | Hartes Denken — Architektur, Debugging, Code-Review | DeepSeek (Cloud, Pro-Stufe) | Cloud |
| Hermes | Deploys und Coding, über eine separate Agenten-Runtime eingebunden. Standardmäßig Dry-Run; echte Deploys brauchen mein ausdrückliches Go | DeepSeek (Cloud, Pro-Stufe) | Cloud |
| Doxy | Grobe Fließbandarbeit. Kein API-Zähler bei einem lokalen Modell, läuft also die ganze Nacht kostenlos | ein 27B-Dense-Modell (lokal) | die GPU-Kiste |
| Charley | Vision — schaut sich tatsächlich Screenshots, Diagramme, Fehlerdialoge an | Gemma-4, vision-fähig (lokal) | die GPU-Kiste |
| Alpha / Beta | Sichere "Empfangs"-Bots für Familiengeräte, nur schreibgeschützte Tools | Flash (Cloud) / Gemma-4 26B (lokal) | Cloud / die GPU-Kiste |
Jeder Agent hat Fallback-Modelle — ist der Primärmodell beschäftigt oder down, fällt er still auf ein Backup zurück, Cloud oder lokal. Beta und Charley sind hart auf schreibgeschützte Tools beschränkt: nachschlagen, Bilder erzeugen, aber nie Dateien anfassen oder Befehle ausführen. Genau das, was man in einem Bot will, den ein Zehnjähriger öffnen darf. Agent-zu-Agent-Messaging ist aktiv, abgesichert durch eine Allowlist, wer mit wem sprechen darf.
Die Teile
Keins davon ist ein einzelnes Programm. Es sind acht kleine Dienste, jeder mit einer Aufgabe, alle von systemd überwacht statt von einem Babysitter-Skript.
| Dienst | Was er tut | Wo |
|---|---|---|
openclaw-gateway.service | Das OpenClaw-Gateway — das Gehirn des Stacks | Port 18789, nur Loopback, Token-Auth |
local-chat.service | DisPatch, das Chat-Frontend | Port 8765, LAN |
lm-studio.service | Lokaler Modellserver (ein entpacktes AppImage), bedient die Modelle auf der Kiste plus das Embedding-Modell | Port 1234, lokal |
| die GPU-Kiste | Große Modelle über StudioForge und Bildgenerierung — beides übers Netzwerk, beides nicht auf dieser Maschine. Lokales ComfyUI lief früher hier und tut es nicht mehr; der Speicher reicht nicht für Bildgenerierung und ein Sprachmodell gleichzeitig. | ein zweiter PC, über Tailscale |
mailforge.service | MailForge — E-Mail-Triage — entwirft Antworten, verschickt nie eine | — |
hermes-gateway.service | Ein separates Gateway, das den Deploy-/Coding-Agenten einbindet | — |
openclaw-backup.timer | Nächtliches Backup | läuft um 02:17 Uhr |
dispatch-tracker-watch.path | Der Watchdog-Auslöser (mehr dazu weiter unten) | — |
Jede Unit startet sich bei einem Fehler selbst neu, so abgestimmt, dass ein Absturz Sekunden Ausfallzeit bedeutet, nicht einen Anruf um 2 Uhr nachts. Die LM-Studio-Unit prüft die eigene API per Health-Check, bevor sie sich selbst für bereit erklärt. Die Konfiguration des Gateways lädt sich im laufenden Betrieb neu, die meisten Routing-Änderungen brauchen also keinen Neustart. Auto-Update ist absichtlich aus — ein Update hat den Stack genau einmal zerlegt, seitdem passieren Versionssprünge nach meinem Zeitplan. Den ganzen Zoo checken:
systemctl --user status openclaw-gateway local-chat lm-studio
journalctl --user -u openclaw-gateway -f
Wie eine Chat-Nachricht sich tatsächlich bewegt
Der Weg ist genau das, was man erwarten würde: Browser → DisPatch → Gateway → das Modell des Agenten, lokal oder Cloud, und auf demselben Weg zurück. Zwei Details zählen: Ist das Primärmodell beschäftigt oder down, antwortet stattdessen ein Fallback, und die Zustellung zurück zum Browser wird über redundante Pfade bestätigt, sodass eine abgebrochene Verbindung keine Nachricht verliert.
Echte Arbeit erledigen
Chat-Antworten sind der einfache Fall. Das nützliche Muster ist, um etwas Großes zu bitten und das Roster selbst klären zu lassen, wer es macht.
Die Schwerarbeit — lange Refactorings, Stapel-Edits, alles Langweilige — geht an Doxy auf dem kostenlosen lokalen Modell, das für den Preis von Strom eine Stunde lang durchackert. Batch-Bildarbeit geht an dieselbe GPU-Kiste.
Sich selbst im Auge behalten
Dispatchte Arbeit, die still stirbt, ist schlimmer als Arbeit, die nie begonnen hat — man merkt es erst, wenn man nachschaut. Deshalb gibt es einen Watchdog, das einzige Stück dieses Stacks, auf das ich wirklich stolz bin.
Das hat eine wirklich schlechte Idee ersetzt: einen dauerhaften Alle-fünf-Minuten-LLM-Cronjob. Er hat das Modell zugespamt und dabei genau die eigenen Request-Timeouts verursacht — der Watchdog hat das exakte Problem erschaffen, das er eigentlich fangen sollte. Die ereignisgesteuerte Version schaltet sich nur scharf, wenn es einen Dispatch zu überwachen gibt, und löscht sich dann so oder so wieder selbst.
Was es kostet
Die Wirtschaftlichkeit ist der ganze Sinn der Roster-Aufteilung. Cloud-Preise pro Million Tokens:
| Modell | Eingabe | Ausgabe |
|---|---|---|
| DeepSeek Flash-Stufe (Flash, Alpha) | 0,14 $ / M Tokens | 0,28 $ / M Tokens |
| DeepSeek Pro-Stufe (Bits, Brains, Hermes) | 0,435 $ / M Tokens | 0,87 $ / M Tokens |
| Lokale Modelle — Doxy, Charley und Beta, alle auf der GPU-Kiste | 0 $ | 0 $ |
Selbst die "teure" Stufe kostet Bruchteile eines Cents pro typischer Anfrage. Die eigentliche Ersparnis liegt darin, wo das Volumen liegt: sich wiederholende Jobs mit Tausenden Tokens gehen ans kostenlose lokale Modell, der Cloud-Zähler dreht sich nur bei Ermessensentscheidungen. Auch die Gedächtnissuche läuft auf einem lokalen Embedding-Modell, sodass die ständigen Hintergrund-Nachschläge ebenfalls nie eine kostenpflichtige API berühren.
Die Regeln, die es nicht bricht
Ein Gateway, das Agenten starten und Tools ausführen kann, braucht Leitplanken, die nicht davon abhängen, dass sich das Modell brav verhält.
- Kamerazugriff, Bildschirmaufnahme, SMS und Kontakte-/Kalenderbefehle sind auf Gateway-Ebene komplett verweigert — nicht "der Agent sollte nicht", sondern tatsächlich blockiert.
- Beta und Charley bekommen schreibgeschützte Tools. Keine Dateischreibvorgänge, keine Shell, egal wie freundlich man fragt.
- Plugins sind eine strikte Allowlist von sieben: zwei lokale Modell-Provider, DeepSeek, Brave-Websuche, ein Headless-Browser, Agent-zu-Agent-Speicher und die Deploy-Brücke. Nichts anderes lädt, ob installiert oder nicht.
- Hermes — der einzige Agent, der Produktion anfassen kann — macht standardmäßig Dry-Runs. Ein echter Deploy braucht mein ausdrückliches Go, und die Deploys meiner eigenen Business-Website sitzen hinter demselben Gate.
Stolperfallen
Die ehrliche Liste — Dinge, die tatsächlich kaputtgegangen sind, in der Reihenfolge, in der sie mich erwischt haben:
- Lokale Modelle brauchen explizit gesetztes
reasoning: true. Meine geben einen separaten Reasoning-Stream aus, bevor die eigentliche Antwort kommt; mit dem falschen Flag las das Gateway das als Stillstand und tötete die Anfrage nach etwa 6,5 Minuten. Das Modell hing nicht — es dachte laut auf einem Kanal, von dem das Gateway nichts wusste. - Jeder Timeout ist standardmäßig auf Cloud-Geschwindigkeit ausgelegt. Ein 120B auf einer iGPU ist langsam, nicht kaputt. Ich habe Provider-, Turn- und Abort-Timeouts auf etwa 20, 30 und 35 Minuten angehoben; davor wurden lange Jobs mitten im Gedanken getötet, nur weil sie lokal liefen.
- Das AppImage von LM Studio ist mit SIGBUS abgestürzt, immer wenn sein
/tmp-FUSE-Mount unter Speicherdruck neu zugewiesen wurde — ein echter Bus-Error, kein OOM-Kill. Das AppImage zu entpacken und als normalen systemd-Dienst laufen zu lassen, hat das Problem beendet. - Die Messaging-Allowlist unterscheidet Groß-/Kleinschreibung, das Gateway macht Agent-IDs intern aber klein. Agent-zu-Agent-Sendungen scheiterten, bis ich Kleinschreibungs-Duplikate jedes Namens hinzugefügt habe. Keine Fehlermeldung, keine Log-Zeile — einfach nichts zugestellt.
- Agent-zu-Agent-Messaging braucht zwei separate Schalter — das Feature-Flag und die Sitzungssichtbarkeits-Einstellung. Nur einen aktivieren, ohne den anderen, und der Standard blockiert still jede Sendung.
- Ein geplanter LLM-Watchdog ist ein selbstverschuldeter Ausfall — die Alle-fünf-Minuten-Cron-Geschichte von oben. Ereignisgesteuert schlägt geplant, mit Leichtigkeit.
- Ein Agent hat einmal seine eigene kaputte Konfiguration wiederbelebt. Ein Identity-Reconcile-Durchgang hat eine veraltete Workspace-Datei erneut eingespielt und das Gateway in eine Absturzschleife geschickt. Konfiguration, die ein Agent anfassen kann, ist Konfiguration, die zurückbeißen kann.
- Eine nicht-leere Plugin-Allowlist ist absolut. Einen Eintrag mit
enabled: truezu markieren, bewirkt nichts, wenn seine ID nicht auch in der Allowlist steht. Die Allowlist gewinnt, still und leise.
Verwandt: StudioForge, die GPU-Kiste, die die großen Modelle bedient, der Benchmark, mit dem ich entscheide, welches Modell welchen Job bekommt, DeepSeek Harness, ein weiterer Coding-Agent auf derselben Kiste, und was das alles tatsächlich kostet.