Ocho agentes de IA, una caja AMD: mi pila local de agentes (OpenClaw)
- Categoría
- IA y LLM Local
- Publicado
- 11 julio 2026
- Actualizado
- 26 agosto 2026
- Por
- Jacob Lloyd — escrito con ayuda de IA, después del proyecto
- Tiempo de lectura
- 12 min de lectura

En palabras simples: Un recorrido por los ocho ayudantes de IA que corren en una computadora pequeña de mi casa, cada uno con su propio nombre y trabajo — desde responder preguntas familiares hasta redactar correos. La mayor parte del trabajo no cuesta nada porque corre localmente, y las conversaciones privadas nunca salen de la casa. Muestra cómo puede verse una configuración de IA doméstica sin cuotas mensuales.
Ahora mismo hay ocho agentes de IA con nombre propio viviendo en una mini PC de mi casa. Tienen trabajos, un orden jerárquico y un chat grupal que toda mi familia puede abrir desde el teléfono. Correrlos a todos cuesta unos $24 al mes — la API barata de DeepSeek se encarga del pensamiento del día a día, y los trabajos que no deberían salir de la casa corren en modelos locales gratuitos.
tl;dr
- Qué es: OpenClaw, un gateway de agentes de IA autoalojado, corriendo 8 agentes con nombre — cada uno con su propio trabajo, enrutamiento de modelo y permisos de herramientas — detrás de una app de chat que construí yo mismo.
- Qué cuesta: unos $24 al mes de API de DeepSeek para el trabajo del día a día; $0 por los modelos locales que cubren visión y trabajos privados.
- Qué necesitas: una máquina Linux con 32GB de RAM (la mía es una mini PC CHUWI AuBox), y paciencia para systemd. Una segunda máquina con GPUs de verdad es opcional y cambia lo que puede hacer el nivel local.
- Qué obtienes: una sola URL de chat para toda la casa, agentes que se pasan trabajo entre sí y persiguen a los que se quedan callados, generación de imágenes bajo demanda, y borradores de correo que nadie envía sin mí.
Lo que obtienes
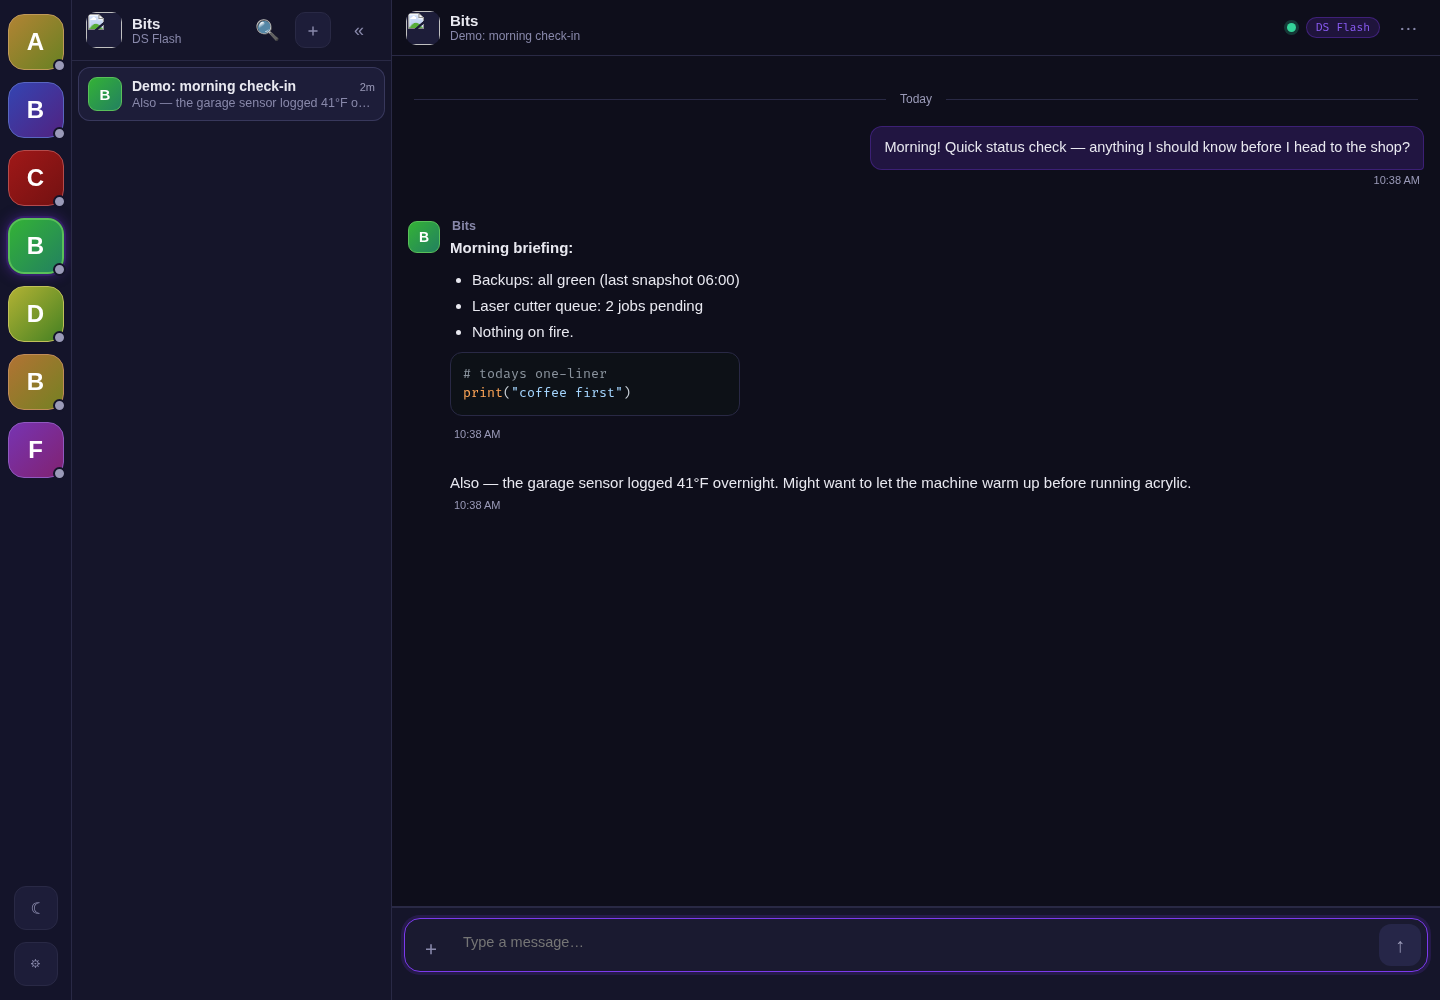
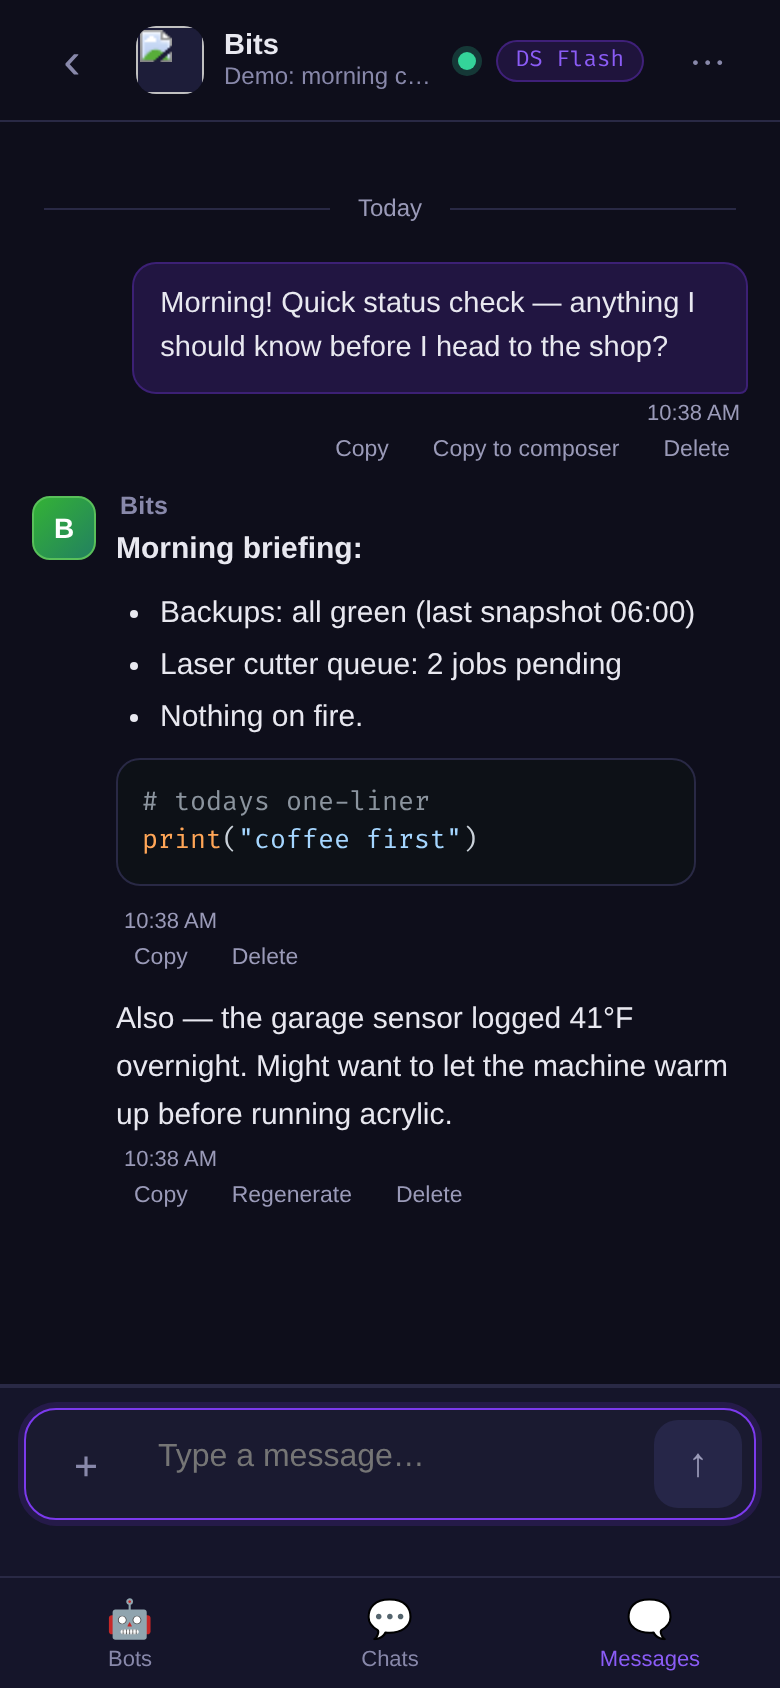
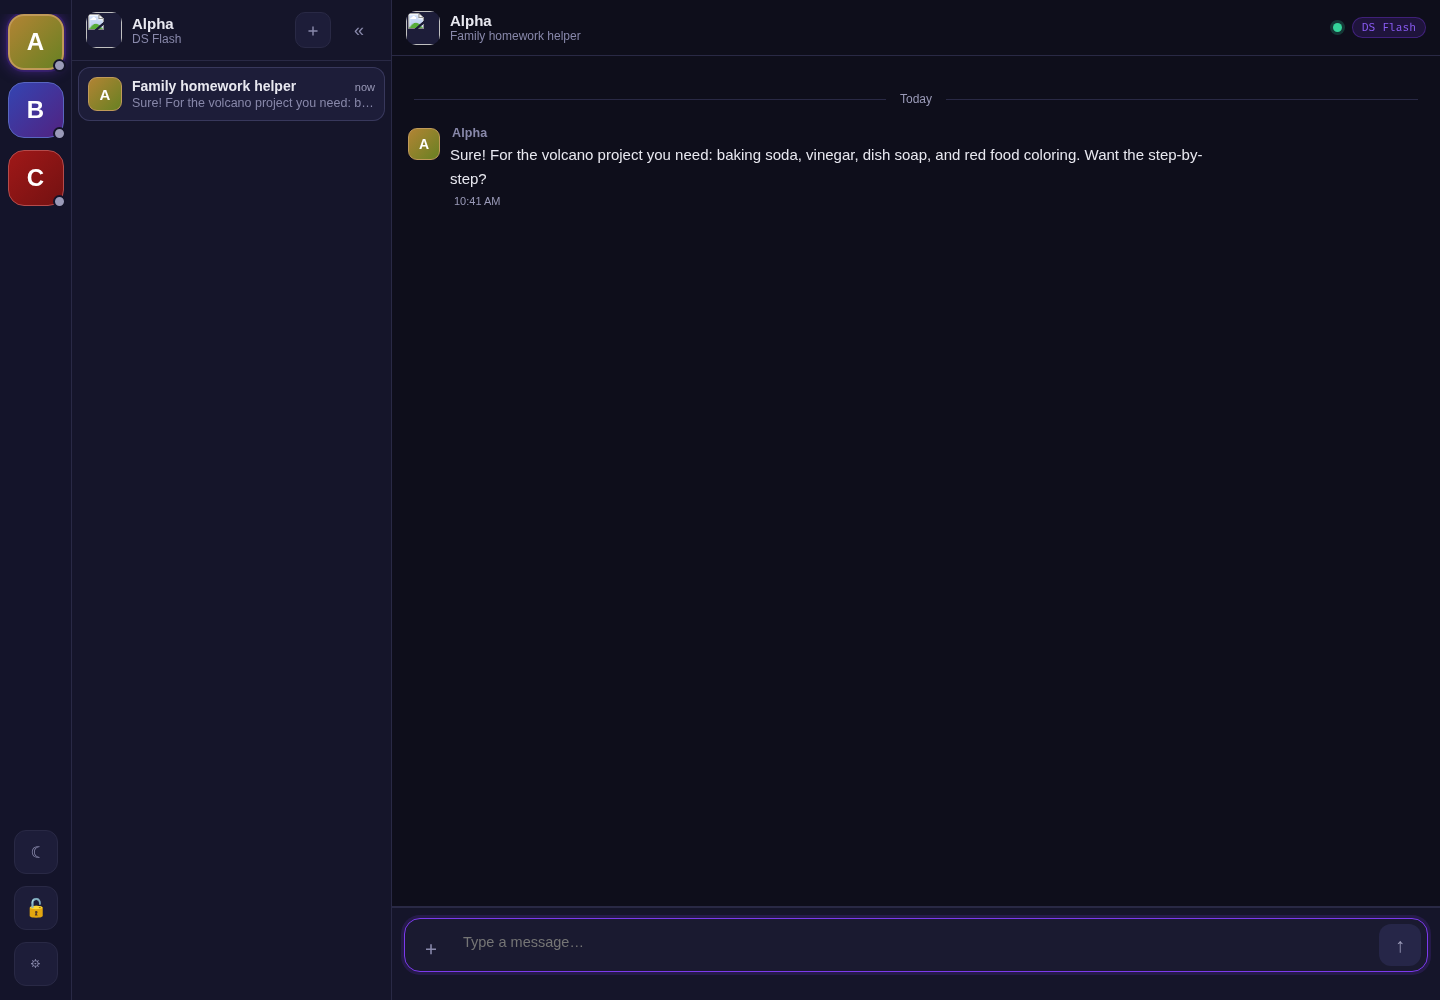
Primero el día a día. Esto es DisPatch, la app de chat que construí para ponerle una cara al gateway — las capturas son datos de demostración de sandbox de ese artículo, mis conversaciones reales siguen siendo mías.
| Qué | El número |
|---|---|
| Agentes con nombre | 8 (Bits, Flash, Brains, Hermes, Doxy, Charley, Alpha, Beta) |
| Modelos en la nube en la tabla de enrutamiento | 2 (DeepSeek flash y pro) |
| Entradas de modelos locales | un puñado en el equipo principal, el resto servido desde una caja GPU en mi red |
| Modelo local más grande | un MoE de 122B en la caja GPU; la mini PC misma llega hasta alrededor de 7B |
| Factura mensual medida en la nube | unos $24 (DeepSeek, el principal responsable) |
| Puerto del gateway | 18789 |
| Puerto del chat | 8765, en la red doméstica |
| Backup nocturno | 02:17 |
| Latido del gateway | cada 2 horas |
| Ventana del watchdog | 5 minutos, y luego se persigue a un trabajador silencioso |
La caja
El gateway y todo lo que lo rodea corren en una sola máquina pequeña. Sin rack, sin renta de GPU en la nube, sin una segunda hipoteca.
- CHUWI AuBox Ai365 — AMD Ryzen AI 9 365 («Strix Point»), 10 núcleos, GPU integrada Radeon 880M
- 30GB de DDR5 utilizables, compartidos entre el sistema operativo y todo lo demás — sin una reserva de VRAM que merezca ese nombre
- 1TB NVMe, corriendo Bluefin (inmutable, basado en Fedora Atomic)
- ROCm, no CUDA, para lo que sí corre localmente — se comporta un poco distinto a lo que asumen los tutoriales, pero funciona
Esta es la segunda caja que ocupa el puesto. La primera fue una ROG Flow Z13 de 128GB con 64GB reservados como VRAM, que corrió un modelo de mezcla de expertos de 120B localmente hasta que desarrolló una falla de alimentación en julio. Entradas más antiguas de este sitio describen aquella máquina; esta es la que la reemplazó, y tiene una cuarta parte de la memoria.
Lo que hizo que eso fuera sobrellevable es la otra mitad de la configuración: una segunda PC en mi red con GPUs de verdad, sirviendo los modelos grandes a través de StudioForge, un servidor compatible con OpenAI que escribí exactamente para esto. El nivel de 120B se mudó ahí en lugar de desaparecer, y la generación de imágenes se fue con él. La mini PC conserva un modelo pequeño y el modelo de embeddings para el trabajo privado; cualquier cosa más grande va por la red.
El elenco
En lugar de una sola pestaña de chat hablando con un solo modelo, tengo una pequeña oficina. Todos tienen un trabajo y un modelo que le queda bien — DeepSeek barato en la nube para la mayor parte del trabajo, modelos locales gratuitos donde importa la privacidad o la visión. (Los modelos locales fueron el plan original; en la práctica, sus tiempos de carga y su techo más bajo los convirtieron en el nivel de respaldo, no en el predeterminado.)
| Agente | Trabajo | Modelo principal | Corre en |
|---|---|---|---|
| Bits | Recepción. Habla conmigo, no hace ningún trabajo de herramientas ella misma, delega todo | DeepSeek (nube, nivel pro) | nube |
| Flash | Trabajos rápidos — resúmenes, búsquedas, ediciones rutinarias. Personalidad cero, pura herramienta | DeepSeek (nube, nivel flash) | nube |
| Brains | Pensamiento difícil — arquitectura, depuración, revisión de código | DeepSeek (nube, nivel pro) | nube |
| Hermes | Despliegues y programación, conectado mediante un runtime de agente separado. Dry-run por defecto; los despliegues reales necesitan mi aprobación explícita | DeepSeek (nube, nivel pro) | nube |
| Doxy | Trabajo pesado a granel. Sin medidor de API en un modelo local, así que corre toda la noche gratis | un modelo denso de 27B (local) | la caja GPU |
| Charley | Visión — de verdad mira capturas de pantalla, diagramas, cuadros de error | Gemma-4, con capacidad de visión (local) | la caja GPU |
| Alpha / Beta | Bots de «recepción» seguros para los dispositivos de la familia, solo herramientas de solo lectura | flash (nube) / Gemma-4 26B (local) | nube / la caja GPU |
Todos los agentes tienen modelos de respaldo — si el principal está ocupado o caído, se baja en silencio a un respaldo, en la nube o local. Beta y Charley tienen restricción estricta a herramientas de solo lectura: buscar cosas, hacer imágenes, nunca tocar archivos ni ejecutar comandos. Exactamente lo que quieres en un bot que un niño de diez años pueda abrir. La mensajería entre agentes está activa, controlada por una lista de permitidos de quién puede hablar con quién.
Las piezas
Nada de esto es un solo programa. Son ocho servicios pequeños, cada uno haciendo un trabajo, todos supervisados por systemd en lugar de un script niñero.
| Servicio | Qué hace | Dónde |
|---|---|---|
openclaw-gateway.service | El gateway de OpenClaw — el cerebro de la pila | puerto 18789, solo loopback, autenticación por token |
local-chat.service | DisPatch, el frontend de chat | puerto 8765, LAN |
lm-studio.service | Servidor de modelos local (un AppImage extraído) que sirve los modelos de la caja, más el modelo de embeddings | puerto 1234, local |
| la caja GPU | Modelos grandes a través de StudioForge, y generación de imágenes — ambos por la red, ninguno en esta máquina. ComfyUI local solía vivir aquí y ya no; no hay suficiente memoria para él y para un modelo de lenguaje al mismo tiempo. | una segunda PC, a través de Tailscale |
mailforge.service | MailForge — clasificación de correo; redacta respuestas, nunca envía ninguna | — |
hermes-gateway.service | Un gateway separado que conecta al agente de despliegue/programación | — |
openclaw-backup.timer | Backup nocturno | se dispara a las 02:17 |
dispatch-tracker-watch.path | El disparador del watchdog (más sobre esto abajo) | — |
Cada unidad se reinicia sola al fallar, ajustada para que una caída signifique segundos de inactividad, no una llamada a las 2am. La unidad de LM Studio verifica la salud de su propia API antes de darse por lista. La configuración del gateway se recarga en caliente, así que la mayoría de los cambios de enrutamiento no necesitan reinicio. La actualización automática está apagada a propósito — una actualización rompió la pila exactamente una vez, y ahora los saltos de versión pasan según mi propio calendario. Para revisar todo el zoológico:
systemctl --user status openclaw-gateway local-chat lm-studio
journalctl --user -u openclaw-gateway -f
Cómo se mueve realmente un mensaje de chat
La ruta es la que imaginas: navegador → DisPatch → gateway → el modelo del agente, local o en la nube, y de vuelta por el mismo camino. Dos detalles importan: si el modelo principal está ocupado o caído, responde un respaldo en su lugar, y la entrega de vuelta al navegador se confirma por rutas redundantes, así que una conexión caída no pierde el mensaje.
Poniéndolos a trabajar de verdad
Las respuestas de chat son el caso fácil. El patrón útil es pedir algo grande y dejar que el elenco decida quién lo hace.
El trabajo pesado — refactorizaciones largas, ediciones por lotes, cualquier cosa aburrida — va para Doxy en el modelo local gratuito, que puede moler una hora entera por el costo de la electricidad. El trabajo de imágenes por lotes va a la misma caja GPU.
Vigilándose a sí mismo
Un trabajo delegado que muere en silencio es peor que uno que nunca empezó — no te enteras hasta que vas a revisar. Por eso hay un watchdog, la única pieza de esta pila de la que de verdad estoy orgulloso.
Esto reemplazó a una idea genuinamente mala: un cron de LLM perpetuo cada cinco minutos. Bombardeaba de spam al modelo y provocaba sus propios timeouts de solicitud — el watchdog estaba creando exactamente el problema que existía para detectar. La versión orientada a eventos se arma solo cuando hay algo que vigilar, y luego se borra sola de cualquier manera.
Lo que cuesta
La economía es todo el sentido de dividir el elenco así. Precios en la nube, por millón de tokens:
| Modelo | Entrada | Salida |
|---|---|---|
| DeepSeek nivel flash (Flash, Alpha) | $0.14 / M tokens | $0.28 / M tokens |
| DeepSeek nivel pro (Bits, Brains, Hermes) | $0.435 / M tokens | $0.87 / M tokens |
| Modelos locales — Doxy, Charley y Beta, todos en la caja GPU | $0 | $0 |
Incluso el nivel «caro» son fracciones de centavo por solicitud típica. El verdadero ahorro está en dónde queda el volumen: los trabajos repetitivos de miles de tokens van al modelo local gratuito; el medidor de la nube solo gira para las decisiones de criterio. La búsqueda de memoria también corre en un modelo local de embeddings, así que las búsquedas constantes de fondo tampoco tocan jamás una API de pago.
Las reglas que no rompe
Un gateway que puede generar agentes y ejecutar herramientas necesita barandas de seguridad que no dependan del buen comportamiento del modelo.
- El acceso a la cámara, la grabación de pantalla, los SMS y los comandos de contactos/calendario están negados de plano a nivel del gateway — no un «el agente no debería», sino realmente bloqueado.
- Beta y Charley tienen herramientas de solo lectura. Nada de escritura de archivos, nada de shell, sin importar cuán amablemente se lo pidas.
- Los plugins son una lista estricta de siete permitidos: dos proveedores de modelos locales, DeepSeek, la búsqueda web de Brave, un navegador headless, memoria entre agentes y el puente de despliegue. Nada más se carga, esté instalado o no.
- Hermes — el único agente que puede tocar producción — hace dry-run por defecto. Un despliegue real necesita mi aprobación explícita, y los despliegues de mi sitio de negocios están detrás de la misma puerta.
Tropiezos
La lista honesta — cosas que de verdad se rompieron, en el orden en que me mordieron:
- Los modelos locales necesitan
reasoning: truepuesto a mano. Los míos emiten un stream de razonamiento separado antes de la respuesta real; con la bandera mal puesta, el gateway lo leía como un estancamiento y mataba la solicitud alrededor de los 6.5 minutos. El modelo no estaba atascado — estaba pensando en voz alta en un canal que el gateway no conocía. - Todo timeout viene por defecto a velocidad de nube. Un 120B en una iGPU es lento, no está roto. Subí los timeouts de proveedor, turno y aborto a unos 20, 30 y 35 minutos respectivamente; antes de eso, los trabajos largos morían a mitad de pensamiento por el crimen de ser locales.
- El AppImage de LM Studio se caía con SIGBUS cada vez que su montaje FUSE en
/tmpse reciclaba bajo presión de memoria — un error de bus genuino, no un OOM kill. Extraer el AppImage y correrlo como un servicio systemd normal terminó con eso. - La lista de permitidos de mensajería distingue mayúsculas, pero el gateway pone en minúsculas los IDs de agente internamente. Los envíos entre agentes fallaban hasta que agregué duplicados en minúsculas de cada nombre. Sin error, sin línea de log — simplemente nada se entregaba.
- La mensajería entre agentes necesita dos interruptores separados — la bandera de la función y el ajuste de visibilidad de sesión. Activa uno sin el otro y el valor por defecto bloquea en silencio todos los envíos.
- Un watchdog programado con LLM es una interrupción autoinfligida — la historia del cron cada cinco minutos de arriba. Lo orientado a eventos le ganó a lo programado, con facilidad.
- Un agente una vez resucitó su propia configuración mala. Una pasada de reconciliación de identidad reinyectó un archivo de espacio de trabajo obsoleto y dejó al gateway en un bucle de caídas. La configuración que un agente puede tocar es configuración que puede morderte de vuelta.
- Una lista de permitidos de plugins no vacía es absoluta. Marcar una entrada como
enabled: trueno hace nada si su ID no está también en la lista de permitidos. La lista de permitidos gana, en silencio.
Relacionado: StudioForge, la caja GPU que sirve los modelos grandes, el benchmark que uso para decidir qué modelo recibe qué trabajo, DeepSeek Harness, otro agente de programación que vive en la misma caja, y cuánto cuesta realmente todo esto.