Oito Agentes de IA, Uma Única Máquina AMD: Minha Stack Local de Agentes (OpenClaw)
- Categoria
- IA e LLM Local
- Publicado em
- 11 julho 2026
- Atualizado em
- 26 agosto 2026
- Por
- Jacob Lloyd — escrito com ajuda de IA, depois do projeto
- Tempo de leitura
- 11 min de leitura

Em termos simples: Um tour pelos oito ajudantes de IA rodando num único computador pequeno lá em casa, cada um com seu próprio nome e função — de responder perguntas da família a rascunhar e-mails. A maior parte do trabalho não custa nada porque roda localmente, e as conversas privadas nunca saem de casa. Mostra como pode ser uma configuração de IA doméstica sem mensalidades.
Agora mesmo há oito agentes de IA com nome morando num mini PC lá em casa. Eles têm funções, uma hierarquia, e um chat em grupo que toda a minha família consegue abrir pelo celular. Rodar todos eles custa cerca de 24 dólares por mês — a API barata do DeepSeek cuida do raciocínio do dia a dia, e os trabalhos que não deveriam sair de casa rodam em modelos locais gratuitos.
resumo
- O que é: o OpenClaw, um gateway de agentes de IA auto-hospedado, rodando 8 agentes com nome — cada um com sua própria função, roteamento de modelo e permissões de ferramentas — por trás de um app de chat que eu construí.
- Quanto custa: cerca de $24/mês de API do DeepSeek para o trabalho do dia a dia; $0 para os modelos locais que cobrem visão e trabalhos privados.
- O que você precisa: uma máquina Linux com 32 GB de RAM (a minha é um mini PC CHUWI AuBox), e paciência para o systemd. Uma segunda máquina com GPUs de verdade é opcional e muda o que o nível local consegue fazer.
- O que você ganha: uma única URL de chat para a casa toda, agentes que repassam trabalho entre si e cobram quem fica quieto demais, geração de imagens sob demanda, e rascunhos de e-mail que nada envia sem eu autorizar.
O que você ganha
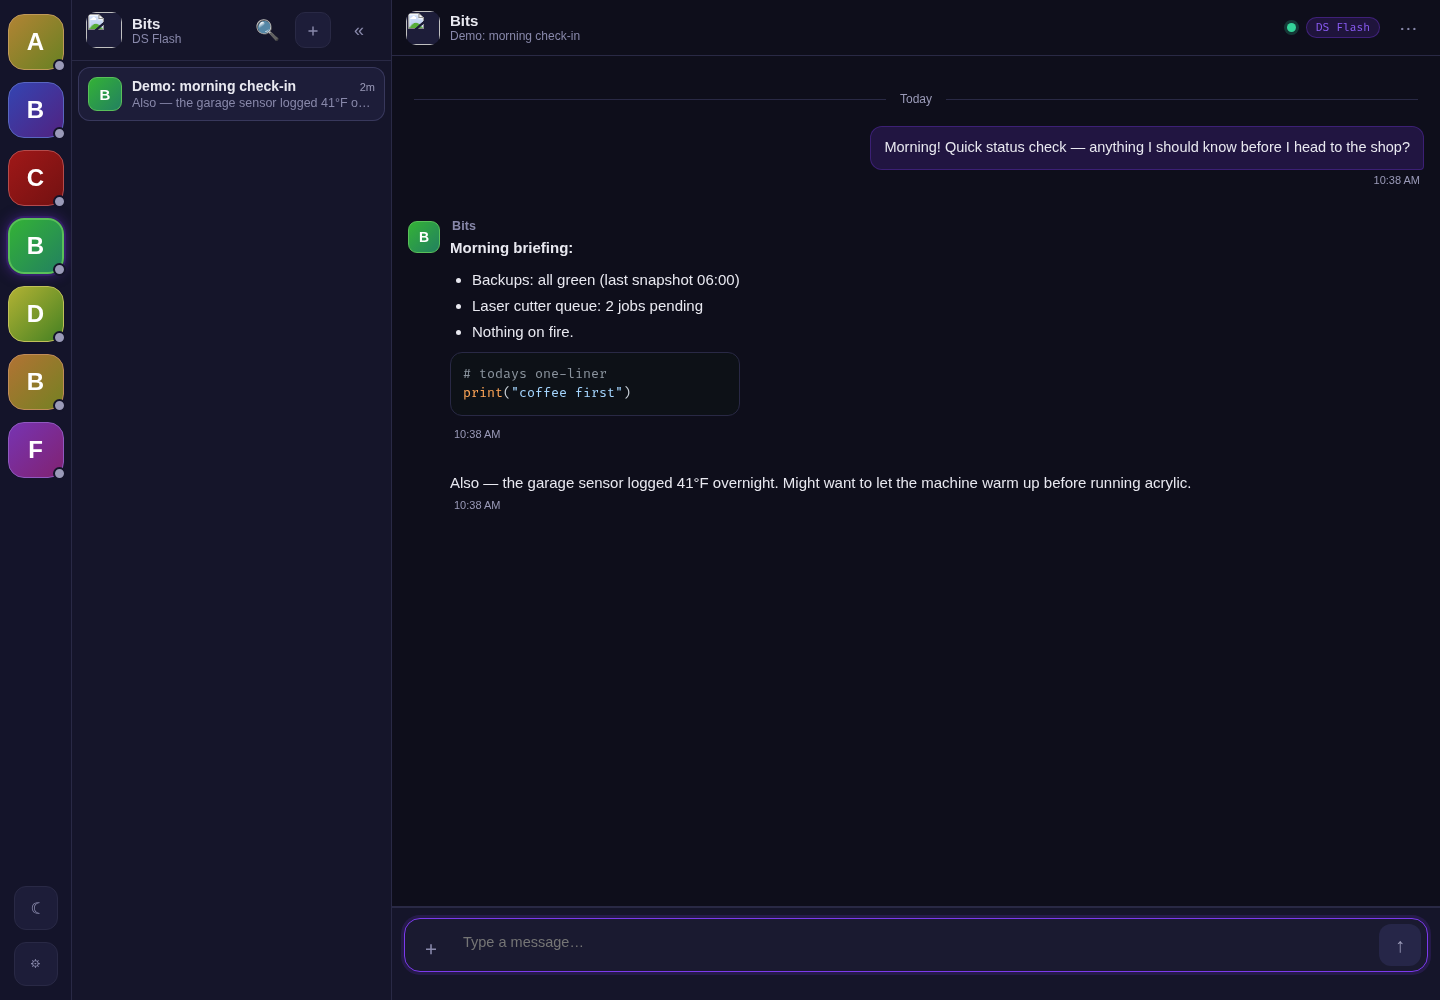
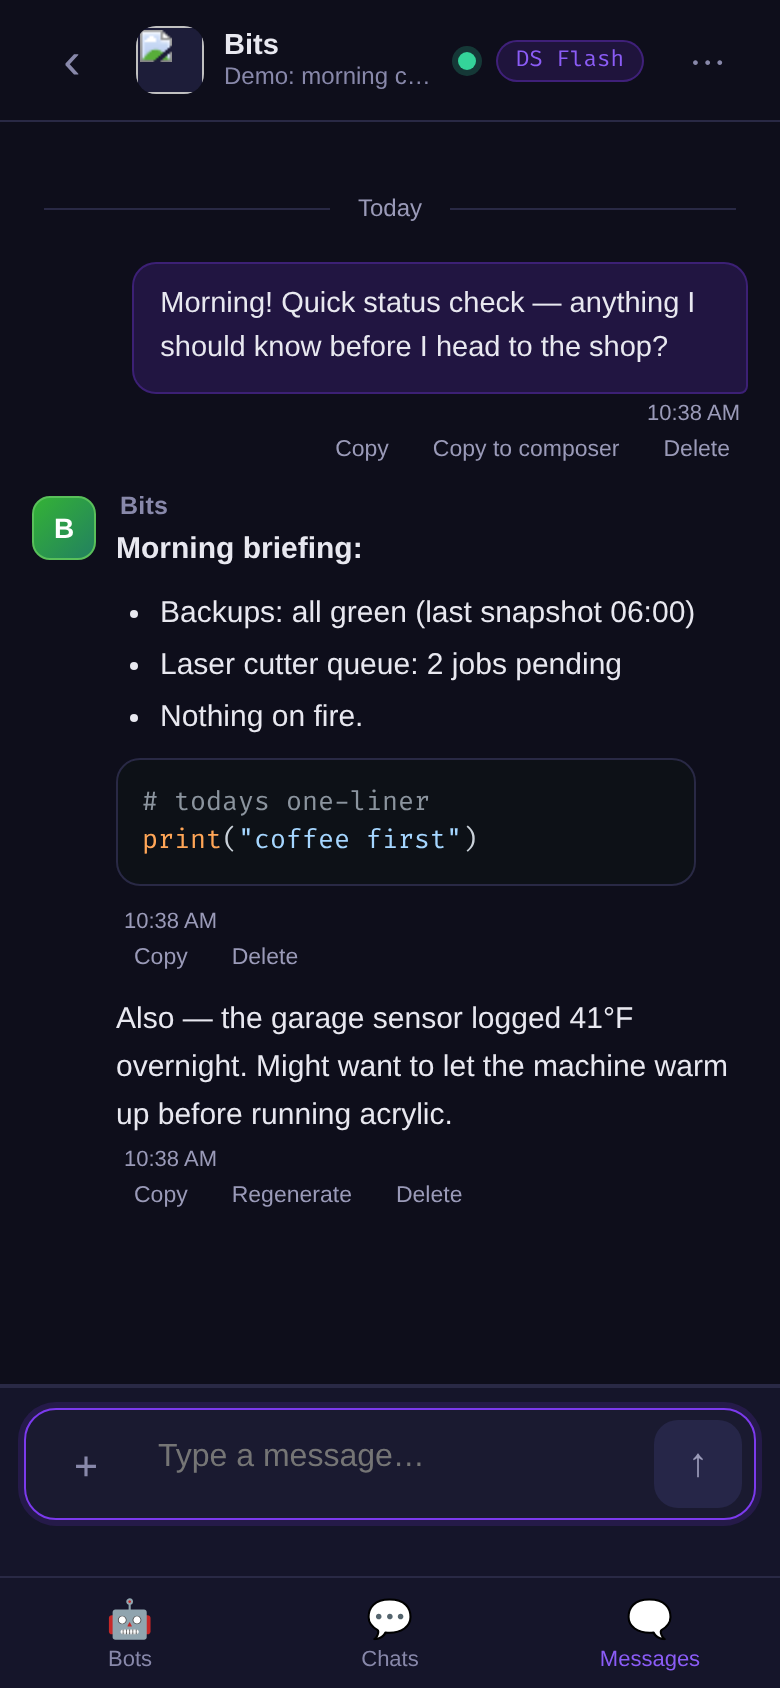
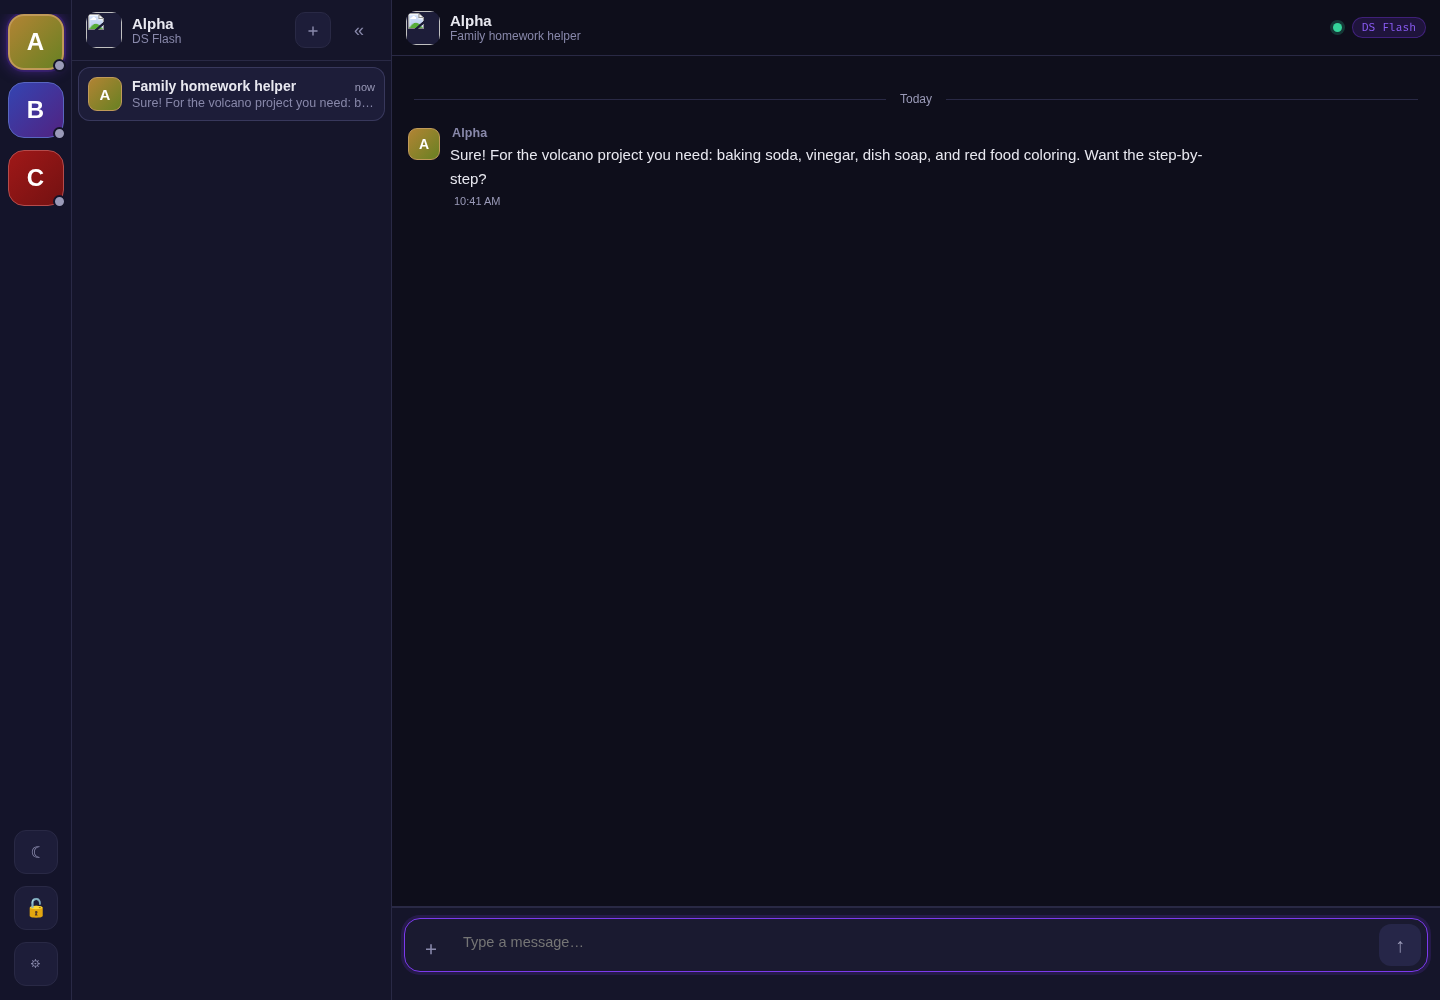
Primeiro, o dia a dia. Este é o DisPatch, o app de chat que construí para ficar na frente do gateway — as capturas de tela são dados de demonstração daquele artigo, minhas conversas de verdade continuam minhas.
| Item | O número |
|---|---|
| Agentes com nome | 8 (Bits, Flash, Brains, Hermes, Doxy, Charley, Alpha, Beta) |
| Modelos de nuvem na tabela de roteamento | 2 (DeepSeek flash e pro) |
| Entradas de modelo local | algumas na máquina principal, o resto servido de uma caixa com GPU na minha rede |
| Maior modelo local | um MoE de 122B na caixa com GPU; o próprio mini PC chega no máximo a uns 7B |
| Conta mensal de nuvem medida | cerca de $24 (DeepSeek, o principal responsável) |
| Porta do gateway | 18789 |
| Porta do chat | 8765, na rede doméstica |
| Backup noturno | 02:17 |
| Heartbeat do gateway | a cada 2 horas |
| Janela do watchdog | 5 minutos, depois um trabalhador silencioso é cobrado |
A máquina
O gateway e tudo ao redor dele rodam numa única máquina pequena. Sem rack, sem aluguel de GPU na nuvem, sem segunda hipoteca.
- CHUWI AuBox Ai365 — AMD Ryzen AI 9 365 ("Strix Point"), 10 núcleos, GPU integrada Radeon 880M
- 30 GB de DDR5 utilizável, compartilhado entre o sistema operacional e todo o resto — sem reserva de VRAM que mereça esse nome
- 1 TB NVMe, rodando Bluefin (imutável, baseado no Fedora Atomic)
- ROCm, não CUDA, para o que roda localmente — ele se comporta um pouco diferente do que os tutoriais pressupõem, mas funciona
Esta é a segunda máquina a ocupar o posto. A primeira foi um ROG Flow Z13 de 128 GB com 64 GB reservados como VRAM, que rodou um modelo mixture-of-experts de 120B localmente até desenvolver uma falha de energia em julho. Posts mais antigos aqui descrevem aquela máquina; esta é a que a substituiu, e ela tem um quarto da memória.
O que tornou isso suportável é a outra metade da configuração: um segundo PC na minha rede com GPUs de verdade, servindo os modelos grandes via StudioForge, um servidor compatível com OpenAI que escrevi exatamente para isso. O nível de 120B se mudou para lá em vez de desaparecer, e a geração de imagens foi junto. O mini PC mantém um modelo pequeno e o modelo de embedding para o trabalho privado; qualquer coisa maior atravessa a rede.
O elenco
Em vez de uma aba de chat conversando com um modelo, eu tenho um pequeno escritório. Todo mundo tem uma função e um modelo que combina com ela — nuvem barata do DeepSeek para a maior parte do trabalho, modelos locais gratuitos onde privacidade ou visão importam. (Os modelos locais eram o plano original; na prática, os tempos de carregamento e o teto mais baixo os transformaram no nível de fallback, não no padrão.)
| Agente | Função | Modelo principal | Roda em |
|---|---|---|---|
| Bits | Recepção. Fala comigo, não executa nenhuma ferramenta ela mesma, terceiriza tudo | DeepSeek (nuvem, nível pro) | nuvem |
| Flash | Trabalhos rápidos — resumos, buscas, edições de rotina. Personalidade zero, ferramenta pura | DeepSeek (nuvem, nível flash) | nuvem |
| Brains | Pensamento difícil — arquitetura, depuração, revisão de código | DeepSeek (nuvem, nível pro) | nuvem |
| Hermes | Deploys e programação, conectado por uma runtime de agente separada. Dry-run por padrão; deploys de verdade precisam do meu sinal verde explícito | DeepSeek (nuvem, nível pro) | nuvem |
| Doxy | Trabalho braçal em massa. Sem medidor de API num modelo local, então roda a noite toda de graça | um modelo denso de 27B (local) | a caixa com GPU |
| Charley | Visão — realmente olha capturas de tela, diagramas, caixas de diálogo de erro | Gemma-4, com capacidade de visão (local) | a caixa com GPU |
| Alpha / Beta | Bots seguros de "recepção" para os dispositivos da família, só ferramentas somente leitura | flash (nuvem) / Gemma-4 26B (local) | nuvem / a caixa com GPU |
Todo agente tem modelos de fallback — se o principal está ocupado ou fora do ar, ele cai silenciosamente para um backup, na nuvem ou local. Beta e Charley são restritos rigidamente a ferramentas somente leitura: buscar informações, gerar imagens, nunca tocar em arquivos ou rodar comandos. Exatamente o que você quer num bot que uma criança de dez anos pode abrir. A troca de mensagens entre agentes está ativada, controlada por uma lista de permissões de quem pode falar com quem.
As peças
Nada disso é um único programa. São oito pequenos serviços, cada um fazendo uma função, todos supervisionados pelo systemd em vez de um script babá.
| Serviço | O que faz | Onde |
|---|---|---|
openclaw-gateway.service | O gateway do OpenClaw — o cérebro da stack | porta 18789, só loopback, autenticação por token |
local-chat.service | DisPatch, o front-end do chat | porta 8765, LAN |
lm-studio.service | Servidor de modelo local (um AppImage extraído) servindo os modelos da própria máquina, mais o modelo de embedding | porta 1234, local |
| a caixa com GPU | Modelos grandes via StudioForge, e geração de imagens — ambos pela rede, nenhum nesta máquina. O ComfyUI local já morou aqui e não mora mais; não há memória suficiente para ele e para um modelo de linguagem ao mesmo tempo. | um segundo PC, via Tailscale |
mailforge.service | MailForge — triagem de e-mail; rascunha respostas, nunca envia uma | — |
hermes-gateway.service | Um gateway separado que conecta o agente de deploy/programação | — |
openclaw-backup.timer | Backup noturno | dispara às 02:17 |
dispatch-tracker-watch.path | O gatilho do watchdog (mais sobre isso abaixo) | — |
Toda unidade se reinicia sozinha em caso de falha, ajustada para que uma pane signifique segundos de indisponibilidade, não uma ligação às 2 da manhã. A unidade do LM Studio verifica a saúde da própria API antes de se declarar pronta. A configuração do gateway recarrega a quente, então a maioria das mudanças de roteamento não precisa de reinício. A atualização automática está desligada de propósito — uma atualização quebrou a stack exatamente uma vez, e agora as atualizações de versão acontecem na minha agenda. Para conferir o zoológico inteiro:
systemctl --user status openclaw-gateway local-chat lm-studio
journalctl --user -u openclaw-gateway -f
Como uma mensagem de chat realmente se move
A rota é a que você imaginaria: navegador → DisPatch → gateway → o modelo do agente, local ou na nuvem, e de volta pelo mesmo caminho. Dois detalhes importam: se o modelo principal está ocupado ou fora do ar, um fallback responde no lugar dele, e a entrega de volta ao navegador é confirmada por caminhos redundantes, então uma conexão que cai não perde a mensagem.
Fazendo trabalho de verdade
Respostas de chat são o caso fácil. O padrão útil é pedir algo grande e deixar o elenco resolver quem faz.
O trabalho pesado — refatorações longas, edições em lote, qualquer coisa entediante — vai para a Doxy no modelo local gratuito, que mói por uma hora inteira pelo custo da eletricidade. O trabalho de imagem em lote vai para a mesma caixa com GPU.
De olho em si mesmo
Um trabalho despachado que morre silenciosamente é pior do que um trabalho que nunca começou — você só descobre quando vai procurar. Por isso existe um watchdog, a única peça desta stack da qual eu realmente me orgulho.
Isso substituiu uma ideia genuinamente ruim: um cron de LLM perpétuo a cada cinco minutos. Ele enchia o modelo de spam e causava seus próprios timeouts de requisição — o watchdog estava criando exatamente o problema que existia para pegar. A versão orientada a eventos só se arma quando há um despacho para vigiar, e depois se apaga de qualquer jeito.
Quanto custa
A economia é o ponto principal da divisão do elenco. Preços da nuvem, por milhão de tokens:
| Modelo | Entrada | Saída |
|---|---|---|
| Nível flash do DeepSeek (Flash, Alpha) | $0,14 / M tokens | $0,28 / M tokens |
| Nível pro do DeepSeek (Bits, Brains, Hermes) | $0,435 / M tokens | $0,87 / M tokens |
| Modelos locais — Doxy, Charley e Beta, todos na caixa com GPU | $0 | $0 |
Até o nível "caro" custa frações de centavo por requisição típica. A economia de verdade está em onde fica o volume: trabalhos repetitivos de milhares de tokens vão para o modelo local gratuito; o medidor da nuvem só gira para decisões que exigem julgamento. A busca de memória também roda num modelo de embedding local, então as buscas constantes em segundo plano também nunca tocam numa API paga.
As regras que ele não quebra
Um gateway que pode criar agentes e rodar ferramentas precisa de salvaguardas que não dependam do bom comportamento do modelo.
- Acesso à câmera, gravação de tela, SMS e comandos de contatos/calendário são negados terminantemente no nível do gateway — não é "o agente não deveria", é realmente bloqueado.
- Beta e Charley recebem ferramentas somente leitura. Sem escrita de arquivos, sem shell, não importa quão educadamente você peça.
- Os plugins são uma lista de permissões rígida com sete itens: dois provedores de modelo local, DeepSeek, busca na web da Brave, um navegador headless, memória entre agentes e a ponte de deploy. Nada mais carrega, instalado ou não.
- Hermes — o único agente que pode tocar em produção — faz dry-run por padrão. Um deploy de verdade precisa do meu sinal verde explícito, e os deploys do site do meu negócio ficam atrás do mesmo portão.
Ciladas
A lista honesta — coisas que realmente quebraram, na ordem em que me morderam:
- Modelos locais precisam de
reasoning: truedefinido explicitamente. Os meus emitem um stream de raciocínio separado antes da resposta de verdade; com a flag errada, o gateway interpretava isso como travamento e matava a requisição por volta dos 6,5 minutos. O modelo não estava travado — estava pensando em voz alta num canal que o gateway não conhecia. - Todo timeout parte do padrão da velocidade da nuvem. Um 120B numa iGPU é lento, não quebrado. Aumentei os timeouts de provedor, turno e aborto para cerca de 20, 30 e 35 minutos; antes disso, trabalhos longos eram mortos no meio do raciocínio pelo crime de serem locais.
- O AppImage do LM Studio travava com SIGBUS sempre que seu ponto de montagem FUSE em
/tmpera reciclado sob pressão de memória — um erro de barramento genuíno, não um OOM kill. Extrair o AppImage e rodá-lo como um serviço systemd simples resolveu. - A lista de permissões de mensagens diferencia maiúsculas de minúsculas, mas o gateway converte os IDs de agente para minúsculas internamente. Os envios entre agentes falhavam até eu adicionar duplicatas em minúsculas de cada nome. Sem erro, sem linha de log — só nada era entregue.
- A mensagem entre agentes precisa de duas chaves separadas — a flag de recurso e a configuração de visibilidade de sessão. Ative uma sem a outra e o padrão bloqueia silenciosamente todo envio.
- Um watchdog de LLM agendado é uma pane autoinfligida — a história do cron de cinco em cinco minutos lá em cima. O modelo orientado a eventos venceu o agendado, com folga.
- Um agente já ressuscitou sua própria configuração ruim. Um passe de reconciliação de identidade reinjetou um arquivo de workspace desatualizado e colocou o gateway num loop de pane. Configuração que um agente pode tocar é configuração que pode te morder de volta.
- Uma lista de permissões de plugins não vazia é absoluta. Marcar uma entrada com
enabled: truenão faz nada se o ID dela também não estiver na lista de permissões. A lista de permissões vence, silenciosamente.
Relacionado: StudioForge, a caixa com GPU que serve os modelos grandes, o benchmark que uso para decidir qual modelo fica com qual tarefa, DeepSeek Harness, outro agente de codificação morando na mesma máquina, e quanto tudo isso realmente custa.