StudioForge: Um servidor LLM que utiliza exclusivamente GPU e que substituiu o LM Studio
- Categoria
- IA e LLM Local
- Publicado em
- 23 agosto 2026
- Atualizado em
- 19 outubro 2026
- Por
- Jacob Lloyd — escrito com ajuda de IA, depois do projeto
- Tempo de leitura
- 41 min de leitura
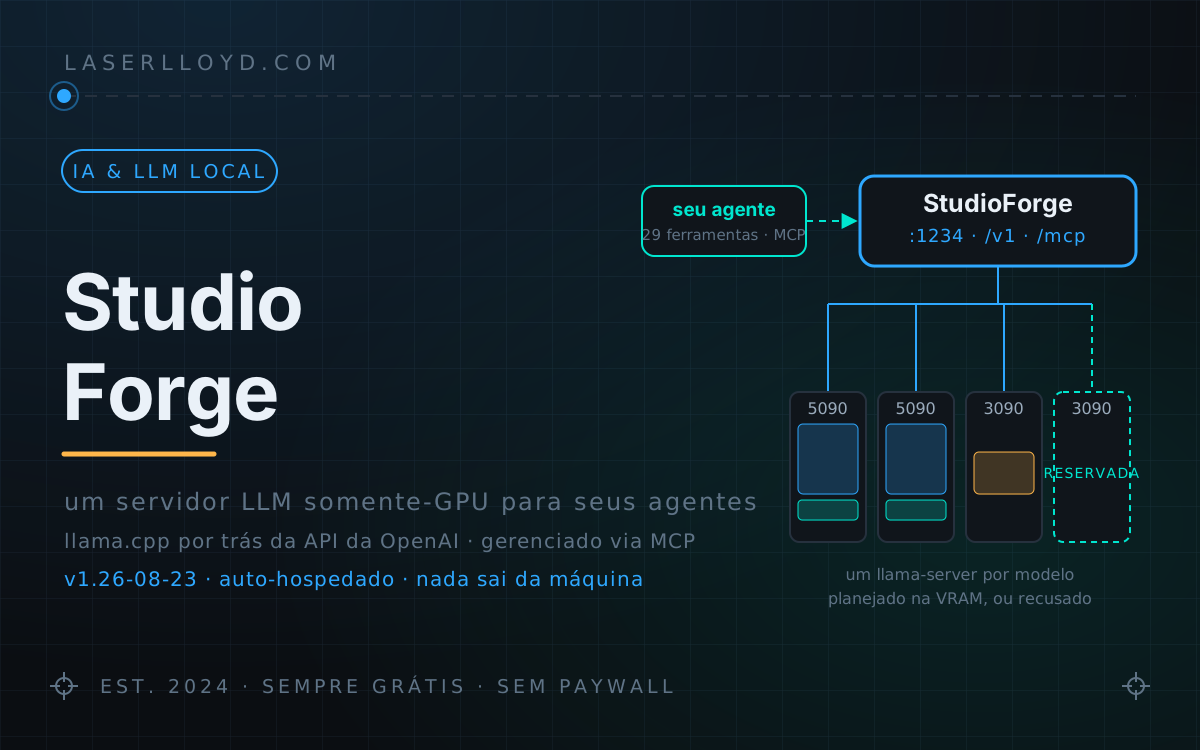
Em termos simples: Um programa para o computador que controla as suas placas gráficas. As aplicações solicitam-lhe respostas da IA; ele determina em quais placas um modelo pode ser executado, inicia-o, mantém-no pronto durante o uso e desliga-o quando está inativo. Um modelo ou é totalmente compatível com as placas gráficas ou é rejeitado – nunca é executado parcialmente no processador lento. Requer placas NVIDIA e funciona melhor no Windows. Aplicações de chat, assistentes de programação e os seus próprios scripts utilizam-no simplesmente alterando um endereço. É gratuito e de código aberto (MIT).
O StudioForge é o servidor de modelos local que criamos para substituir o LM Studio no nosso rig com GPU. Ele gerencia o llama.cpp, implementa a API do OpenAI na porta 1234 (a mesma do LM Studio, propositalmente), possui um painel de controle via navegador e um componente de recuperação; além disso, expõe seu plano de gerenciamento através do MCP, permitindo que um agente em outra máquina o execute sem necessidade de acesso ao shell.
Código-fonte completo no GitHub ou baixe o zip
Criamos esse servidor após inúmeros problemas com o LM Studio: erros como 200 para caminhos não roteados, impossibilidade de saber quais modelos estavam realmente carregados e modelos de raciocínio que ultrapassavam a janela de 8.192 tokens, algo que nossa configuração do cliente nunca solicitou. O problema mais grave foi um modelo que não podia ser reduzido em tamanho; o LM Studio afirma que “reduz automaticamente o tamanho do carregamento na GPU… e o restante na memória RAM do sistema”, mas na prática isso ocorre na velocidade da memória RAM, ainda assim retornando sucesso sem aviso.
Se você leu o artigo sobre o dsh, o bloco de provedores chamado “Local GPU rig” refere-se exatamente a este servidor. É também ele que nossos stacks de agentes locais, o DisPatch, o MailForge e o InfoForge utilizam para obter modelos.
Resumindo:
- O que é: um servidor compatível com OpenAI, exclusivamente para GPU, baseado no
llama-serverdo llama.cpp. Versão 0.2.0, testada com o buildb10425do llama.cpp (CUDA 13.3). Gateway na porta1234, painel de controle em8080, serviço de monitoramento em1235; cada modelo carregado gera um processo filho nas portas18100–18200. - O que faz: carrega um modelo na primeira utilização, escolhendo o contexto, o tipo de cache KV, a localização na GPU e o número de slots disponíveis com base na VRAM livre no momento. Ele desativa modelos inativos, mantém os selecionados carregados, aloca placas inteiras para um único modelo quando solicitado e disponibiliza 29 ferramentas MCP na versão 0.2.0 (19 de gerenciamento e 10 de recuperação).
- O que nunca faz: utiliza a CPU para processamento. Se um modelo não couber inteiramente na VRAM, ele é simplesmente recusado. Não realiza chamadas externas, exceto ao Hugging Face para obter modelos, ao GitHub para atualizações do motor e verificação de versões, além de URLs de imagens indicadas em requisições.
- Requisitos: GPUs NVIDIA com driver da série 580 ou superior, Python 3.12+, uv e uma pasta contendo arquivos GGUF. Não tem experiência em rodar modelos localmente? Comece por aqui.
- Restrições: funciona apenas com NVIDIA; Windows é a plataforma de referência. Linux é suportado e testado via CI, mas não o testamos integralmente em nossos próprios ambientes. O software é licenciado sob MIT; há uma dependência LGPL descrita em Restrições.
O que ele NÃO é:
- Não é um modelo nem um motor de IA. O llama.cpp realiza os cálculos; o StudioForge decide quais processos rodam com quais configurações e em quais GPUs.
- Não é um aplicativo de chat. A aba “Chat” existe apenas para comprovar que o fluxo de requisições funciona corretamente.
- Não é um servidor para CPU. O parâmetro
--n-gpu-layerstem valor fixo999em todo o código-fonte. - Não é um segundo tipo de API. Não há endpoints Ollama ou KoboldCpp. Oferecemos apenas a interface OpenAI, um espelho estilo LM Studio em
/api/v0e o REST de gerenciamento em/api.
Como se comparam
| LM Studio 0.4.21 | StudioForge 0.2.0 | |
|---|---|---|
| Motor | versões próprias do llama.cpp, além do MLX na Apple | usa o llama-server oficial; uma versão específica (b10425, CUDA 13.3) testada antes do uso |
| Caminhos não roteados | 200 com corpo de erro; o log indica Returning 200 anyway | 404 com envelope JSON; JSON em todos os status |
| Erros | mensagens em texto livre que os clientes devem interpretar via regex | um código de erro estável error.code; diagnósticos em error.studioforge |
| Carregamento de configuração | context_length é ignorado em um dos dois caminhos de carregamento; repetition_penalty também é ignorado silenciosamente | apenas um caminho de carregamento; todos os campos são respeitados e os valores efetivos são retornados |
| Quando não há recursos suficientes | "reduzirá automaticamente o tamanho do offload na GPU… e o restante irá para a RAM do sistema" | 507 insufficient_vram: informa bytes necessários e disponíveis, VRAM livre por GPU, o maior contexto possível e sugestões |
| Multi-GPU | prioridade ou divisão equitativa; toggle por GPU; suporte a tensor parallel desde a versão 0.4.15 | um planejador que define o tamanho do contexto, tipo de KV e quantos slots cada GPU receberá |
| TTL de inatividade | 60 minutos; o sistema descarrega automaticamente até deixar apenas 1 modelo carregado via JIT | 1.800 s (30 min) por padrão; em nosso ambiente, 900 s (15 min); varredura a cada 15 s; permite carregar quantos modelos couberem |
| Gerenciamento remoto | /api/v1 para carregar/descarregar/download; o LM Link está em versão prévia | /api via REST, CLI sfctl, 29 ferramentas MCP; funciona na sua LAN ou em uma rede VPN própria |
| MCP | apenas como host (ele utiliza servidores MCP) | funciona como servidor MCP para seu próprio gerenciamento; também possui um servidor MCP de monitoramento |
| Fonte do código | fechada; gratuita para uso pessoal e corporativo interno | código aberto, sob licença MIT |
As informações referentes ao LM Studio foram verificadas com base em seu changelog, documentação e rastreador de bugs em 23/08/2026 (versão 0.4.21, lançada em 12/08/2026). O item 2 consta no rastreador público de bugs. Os itens 3 e 4 representam problemas que nosso próprio cliente teve de contornar na API da versão 0.3.x; não os testamos novamente na versão 0.4.21, portanto devem ser considerados como parte do histórico documentado.
O LM Studio é o melhor aplicativo desktop: GUI refinada, suporte ao MLX no Apple Silicon, endpoint compatível com a Anthropic, aplicativo móvel e lançamentos frequentes. A verdadeira diferença está no comportamento padrão: o LM Studio tenta fazer um modelo rodar de qualquer maneira; já o StudioForge recusa e explica o motivo. Quando um agente decide o que será carregado, isso faz diferença, pois nenhum componente downstream consegue distinguir um carregamento rápido de um carregamento problemático sem medições.
| Servidor · motor · licença | Hot-swap / TTL de inatividade | Posicionamento em múltiplas GPUs | Recusa ao uso da CPU | Gerenciamento remoto / MCP |
|---|---|---|---|---|
| StudioForge 0.2.0 llama.cpp, uma versão específica · MIT | ✅ Carregamento JIT · TTL de 1.800 s; varredura a cada 15 s | planejado por modelo; suporte a placas diferentes; pinning e leases | ✅ -ngl 999 + --fit off; código de erro 507 com detalhes numéricos | ✅ REST + 29 ferramentas MCP |
| LM Studio 0.4.21 versões próprias do llama.cpp + MLX · código fechado | ✅ Carregamento JIT · TTL de 60 min; descarrega automaticamente até 1 modelo | prioridade ou divisão equitativa; suporte a tensor parallel | ❌ reduz o offload na GPU; o restante vai para a RAM | REST; apenas como host MCP |
| Ollama 0.32.15 llama.cpp/GGML; MLX na Apple · MIT | ✅ keep_alive por 5 min; até 3 modelos residem por GPU | distribui automaticamente os modelos entre as placas | ❌ utiliza a CPU; exibe percentual de uso da CPU em ollama ps | API rica /api/*; sem servidor MCP |
| Roteador llama-server (b105xx, agosto de 2026) baseado no llama.cpp · MIT | ✅ um processo filho por modelo; --sleep-idle-seconds; evicção LRU por contagem | configuração manual via -sm / -ts / -dev | ❌ --fit on reduz o tamanho planejado do modelo | /models/load|unload |
| llama-swap v251 proxy que inicia outros processos · MIT | ✅ todo o produto; TTL por modelo/grupo via ttl | ❌ depende inteiramente do parâmetro cmd | n/a (é apenas um proxy) | /ui + roteamento para os demais serviços |
| vLLM 0.27.1 motor próprio (PagedAttention) · Apache-2.0 | ❌ apenas um modelo por processo | tensor / pipeline / expert parallel | parcialmente (não há caminho para offload na CPU) | apenas LoRA; modo “desenvolvimento local” |
| KoboldCpp 1.119 fork do llama.cpp + suporte a imagem/áudio · AGPL-3.0 | ✅ --admin + --routermode | configuração manual via --tensor_split | ❌ utiliza a CPU quando possível | /api/admin/*; apenas cliente MCP |
| TextGen (ex-oobabooga) 4.9 5 carregadores, incluindo ExLlamaV3, TRT-LLM · AGPL-3.0 | ✅ troca sem reinicialização; TTL desconhecido | configuração manual via --tensor-split | ❌ utiliza a CPU quando possível | /v1/internal/model/*; cliente MCP |
| TabbyAPI (versão contínua) apenas ExLlamaV3, sem suporte a GGUF · AGPL-3.0 | ✅ gerenciamento administrativo + carregamento inline; TTL desconhecido | gpu_split_auto ativado por padrão | ✅ funciona assim, pois o ExLlama não tem caminho para CPU | chave administrativa em /v1/model/load |
| Jan 0.8.4 modo roteador do llama.cpp · Apache-2.0 | ✅ via roteador; TTL desconhecido | herdado do llama.cpp | ❌ utiliza a CPU quando possível | /v1/orchestrations; cliente MCP |
| LocalAI 4.9.0 +60 backends como imagens de container · MIT | ✅ carregamento sob demanda; WATCHDOG_IDLE_TIMEOUT | "ajuste automático do modelo à GPU" | ❌ afirma "não é necessária GPU" | REST + interface gráfica; apenas cliente MCP |
| GPUStack 2.2.3 vLLM, SGLang, MindIE, VoxBox · Apache-2.0 | parcial (em implantações de cluster) | distribuição/agrupamento automático; multi-nó | ? | API completa para gerenciamento de cluster |
Informações verificadas em fontes primárias em 23/08/2026. O ponto de interrogação indica desconhecido, não “não há”. Os workers do GPUStack funcionam apenas no Linux; o vLLM não possui suporte nativo ao Windows.
- Carregamento JIT e TTL de inatividade não são novidades. LM Studio, Ollama, llama-swap e LocalAI já oferecem ambos os recursos; o llama-swap ainda possui flags
swap,exclusiveepersistentpara definir políticas de uso. - Três recursos são raros: recusa ao uso da CPU (apenas o TabbyAPI oferece isso, pois o ExLlama não tem caminho para CPU), planejador que ajusta contexto e slots conforme as GPUs disponíveis, e gerenciamento via ferramentas MCP — este último não encontramos em nenhum outro programa da categoria.
- O maior rival é o próprio roteador do llama.cpp. Ele executa vários modelos com isolamento de processos, é gratuito e já vem embutido no binário. Contudo, não possui evicção baseada em memória (usa contagem como critério), nem pinning, leases ou mensagens detalhadas sobre falhas.
A compatibilidade com o LM Studio foi um requisito de design. O StudioForge replica sua porta /v1/models para listar modelos baixados, o carregamento JIT, o TTL de inatividade, o parâmetro ttl por requisição, a estrutura de pastas publisher/repo/ (usada em conjunto, permitindo que ambos os programas compartilhem uma biblioteca), o espelho /api/v0/models e o link profundo lmstudio://open_from_hf. Para migrar um cliente, basta alterar o nome do host. Porém, ambos os programas não podem ocupar a porta 1234 simultaneamente; portanto, encerre o LM Studio ou altere o parâmetro server.port.
O que roda onde
Qualquer aplicativo que já se comunique com um endpoint no estilo OpenAI precisa apenas de uma URL base e de um ID de modelo: interfaces de chat como SillyTavern (Chat Completion → Custom), Open WebUI e LibreChat; assistentes de programação como Continue, Cline, aider e dsh; o SDK openai em qualquer linguagem; além de ferramentas de automação que permitem digitar o endpoint diretamente. Apenas o host com GPU realiza qualquer instalação.
| Componente | Onde | Para que serve |
|---|---|---|
| Gateway | no host com GPU, um único processo, 1234 | /v1, /mcp (19 ferramentas), /api. Armazena o registro de modelos, o planejador e o supervisor. |
| Painel de controle | no mesmo processo, segundo uvicorn, 8080 | Dashboard, Configuração, Modelos, Download, Chat, Servidor, Logs. |
| Watchdog | um processo separado, 1235 | Seu próprio servidor MCP com 10 ferramentas de recuperação. Continua ativo mesmo quando o gateway não está. |
llama-server filhos | 18100–18200, apenas loopback | Um por modelo carregado. Uma falha afeta apenas um modelo, nunca o gateway. Como os filhos se ligam apenas a 127.0.0.1, o gateway é a única superfície pública. |
sfctl complemento | na máquina do agente | Um cliente HTTP puro (Python 3.11+, sem CUDA) e a ponte MCP via stdin/stdout. |
| Biblioteca GGUF | models.dir, onde já se encontra | Indexada no local; nada é copiado. |
Como uma solicitação flui
Tudo o que um cliente pode errar é verificado antes do primeiro byte ser enviado. Um ID de modelo inválido resulta em um código 404 com um corpo JSON; os clientes lidam bem com isso, mas frequentemente tratam incorretamente um quadro de erro contido num fluxo SSE do tipo 200. A partir de GET /health no nosso sistema (resumido):
{"status": "ok", "boot": {"phase": "ready", "ready": true},
 "engine": {"ok": true, "tag": "b10425", "variant": "cuda", "smoke_tested": true},
"gpu_count": 4, "models_indexed": 34, "can_serve": true}can_serveé o campo que deve ser consultado.statusapenas indica que o processo está ativo;can_servepermanece como “falso” durante a primeira varredura da biblioteca.GET /health?deep=trueexecuta um completamento de 8 tokens em cada modelo carregado; quando nenhum modelo está carregado, ele retornano_models_loadedem vez de prosseguir.local-modelfunciona corretamente.local-model,default,autoecurrenttodos mapeiam paramodels.default_model, pois os clientes do LM Studio recorrem a essa string literal.- O carregamento inicial não parece ser um travamento do sistema. O stream aberto exibe
: loading <model id> (5s)a cada cinco segundos, seguido por: prefilling …até que o primeiro token seja gerado. Essas são linhas de comentário do tipo SSE, ignoradas pelos parsers, e evitam que os timeouts de leitura sejam acionados no cliente. - Só é possível carregar um modelo por vez, em toda a máquina. A tentativa de carregar dois modelos simultaneamente fez com que ambos entrassem em conflito nos mesmos recursos da GPU; um deles acabou falhando por falta de memória.
- O
ttlde uma solicitação apenas redefine o temporizador de inatividade. Ele nunca consegue “travar” ou “desbloquear” um modelo.
O planejador de VRAM
Esta é a parte que a maioria dos servidores locais ignora. core/planner.py (3.188 linhas na versão 0.2.0) responde a uma pergunta antes do início da execução de um modelo: considerando a quantidade de VRAM livre em cada placa no momento, qual é o maior “window size” possível, qual a melhor qualidade de cache e quantos slots podem ser utilizados por esse modelo? E, se nenhuma configuração for viável, qual mensagem de recusa deve ser exibida?
A escada de contexto
Na primeira execução, tune_for_hardware eleva o limite mínimo para 16.384 quando a placa de vídeo mais pequena possui 24 GiB ou mais de memória. O planejador nunca oferece uma janela de contexto maior que o comprimento treinado pelo modelo, pois isso exigiria escalonamento RoPE e reduziria a qualidade.
A segunda fase existe devido a um caso específico de carregamento. Naquela ocasião, havia 79.832 MB livres e outros 19.423 MB ocupados por um modelo inativo. Com esse volume de memória, 262.144 tokens no formato q4_0 caberiam em 96.004 MB, e 65.536 tokens no formato f16 ocupariam 95.236 MB. Na prática, foi carregado 8.192 tokens no formato f16, utilizando 89.860 MB. O código antigo permitia apenas a evicção do limite mínimo; assim, o modelo pagou pelo custo da evicção e acabou recebendo a menor janela possível.
A qualidade do cache é definida em cada degrau: f16/f16 → q8_0/q8_0 → q8_0 K + q4_0 V. O formato simétrico q4_0 foi removido de todos os caminhos automáticos. Com um cache K no formato q4_0, o modelo Qwen2.5-7B reproduziu apenas 11,7% dos tokens que gera no formato f16; já a combinação q8_0/q8_0 resultou em um valor de divergência KL de 0,0018.
O tamanho do cache KV depende da arquitetura
A maioria dos calculadores de VRAM computam o cache KV como número de camadas × número de heads × dimensão do head × 2 × bytes × contexto. Isso está correto para o Llama, mas é totalmente errado para duas famílias populares de modelos. O Gemma 3 e 4 intercalam cinco camadas com janela deslizante por cada camada completa; nesse caso, a dimensão do head é reduzida à metade. Já o Qwen3.5, 3.6 e 3.8 definem full_attention_interval = 4, de modo que apenas a cada quarta camada há um cache KV; as demais são camadas recorrentes com estado fixo.
Um cálculo incorreto gera custos elevados. Antes da correção, o planejador estimava 480 GiB somente para o cache KV num modelo Gemma-4 de 31 bilhões de parâmetros, com uma janela de contexto de 262.144 tokens; por isso, limitou o modelo a 65.536 tokens. Durante semanas, os registros de calibração indicavam um consumo previsto de 95.615 MB, quando na verdade foram usados apenas 40.037 MB. Após a correção, o consumo total (pesos mais cache KV) foi estimado em cerca de 38 GiB para 262.144 tokens, rodando em duas placas 5090. Isso representa uma janela de contexto quatro vezes maior; todos os modelos Gemma-4 se beneficiaram disso. Atribuir o custo do cache KV a todas as camadas do Qwen3.5 foi outro erro: resultou num sobrecusto de 4×.
Se você for criar seu próprio estimador, copie exatamente a fórmula de cálculo da janela deslizante do llama.cpp. Um multiplicador fixo de 1,25× subestimou o valor real em 3,6× quando se consideram quatro slots; isso levaria ao esgotamento da memória durante o carregamento do modelo.
O que medimos em quatro placas gráficas diferentes
O sistema utiliza duas RTX 5090 e duas RTX 3090; o painel indica um total de 111,7 GiB de memória, com o driver 610,88 (CUDA 13,3). O planejador tenta usar uma única placa primeiro, pois a divisão da carga entre placas via PCIe, sem NVLink, é mais lenta e segue o ritmo da placa mais lenta.
| Configuração (1,5B Q4_K_M, 8k ctx, média de 3 execuções) | Geração | Processamento do prompt |
|---|---|---|
| Uma única RTX 3090 | 352,5 tok/s | 2.803,6 tok/s |
Duas RTX 3090s, -sm layer | 344,4 tok/s | 2.722,5 tok/s |
Duas RTX 3090s, -sm tensor | 294,3 tok/s | 1.182,0 tok/s |
Duas RTX 3090s, -sm row | Falha: device CUDA2 does not support split buffers | |
Uma única placa superou o desempenho de duas placas juntas. A divisão da carga via tensor custou 17% do tempo de geração e 58% do tempo de processamento do prompt neste modelo pequeno; por isso, o modo tensor é opcional e só deve ser usado em testes de desempenho. O modo -sm row é aceito pelo parser, mas falha na execução via CUDA; assim, o StudioForge bloqueia essa configuração antes de iniciar a execução.
A questão de quantos “slots” paralelos valem a pena utilizar é outra história. Vale notar que o parâmetro --ctx-size do llama.cpp representa o orçamento total de memória KV compartilhado entre todos os slots, não o valor por slot individual. Com --ctx-size 4096 e sem --parallel, o sistema relata total_slots: 4, ou seja, 1.024 tokens por conversa. O StudioForge inicia a execução com base em ctx_per_slot × parallel.
| Concorrência | Por stream | Agregado | p50 | p95 | Lote alcançado |
|---|---|---|---|---|---|
| 1 | 302,8 tok/s | 302,8 tok/s | 0,41 s | 0,41 s | 1,00 |
| 2 | 225,3 tok/s | 425,3 tok/s | 0,46 s | 0,49 s | 1,84 |
| 4 | 134,5 tok/s | 436,0 tok/s | 0,83 s | 1,00 s | 3,46 |
| 8 | 83,3 tok/s | 576,9 tok/s | 1,57 s | 1,77 s | 6,03 |
Qwen2.5-1,5B-Instruct Q4_K_M, uma única RTX 3090, 8.192 tokens por slot, KV em f16; oito slots iniciados, prompts de 512 tokens e 192 tokens gerados cada; data: 19/08/2026. Os resultados foram reproduzidos em três execuções com variação inferior a 2%.
Por que o valor para uma única placa é 302,8 aqui, enquanto a tabela anterior indica 352,5 para o mesmo modelo e mesma placa? São testes distintos, com configurações diferentes. Nesta execução, foram utilizados oito slots KV, além de prompts e comprimentos de saída próprios. Compare apenas linhas dentro da mesma tabela, não entre tabelas.
- O estimador sugeriu 8 slots; a medição indicou 2. Com quatro slots, cada stream passa a operar a 44% da velocidade individual. A regra escolhe o maior valor entre 1, 2, 4 ou 8 que mantenha cada stream acima de 65% da velocidade individual e ainda resulte num aumento de 15% no desempenho agregado.
- O desempenho agregado continua subindo, mesmo quando cada usuário fica mais lento. Oito slots permitem processar 1,9× mais tokens que uma única placa, porém cada conversa é executada a apenas 27% da velocidade individual. Uma regra que priorizasse apenas o desempenho agregado escolheria 8 slots, tornando cada chat três vezes mais lento.
- O processamento em lote é real. O aumento do “lote alcançado” de 1,00 para 6,03 comprova que há etapas de decodificação compartilhadas, e não apenas uma fila de espera.
Outros dois parâmetros foram testados antes de serem considerados confiáveis:
- A decodificação especulativa ajuda apenas um único stream. No modelo Qwen3.8-27B Q5_K_S, com uma RTX 3090 e um cabeçalho MTP, quatro prompts diferentes geraram 37,75 tok/s sem essa funcionalidade; com
draft-mtpna profundidade 3, o desempenho subiu para 50,70 tok/s (+34,3%). Ao repetir o mesmo prompt, o ganho foi de +751%, mas isso se deveu ao cache de prompts, não à decodificação especulativa. Acima de quatro slots, o parâmetroautodesativa automaticamente essa funcionalidade. - Um micro-lote maior troca memória VRAM por velocidade no pré-processamento. Para um prompt de 5.166 tokens, o uso de
-ub 2048resultou em um ganho de 18,6% em relação ao valor padrão de 512, mas exigiu 210 MiB adicionais de memória. O planejador calcula esse consumo e eleva automaticamente o valor de-ubapenas quando há mais de quatro slots em uso.
A recusa, com os números
Cada lançamento passa por --fit off e --n-gpu-layers 999. Isso é importante porque a versão do llama.cpp b10425 vem com --fit configurado como ativado por padrão, além de --n-gpu-layers auto (ambos provenientes do PR #16653, dezembro de 2025). Juntos, eles formam um mecanismo de transferência parcial para a GPU; trata-se de um padrão razoável para servidores em geral, mas exatamente o que este projeto recusa. Quando nada consegue ser carregado, recebe-se um erro HTTP 507. Um exemplo real, resumido:
HTTP 507  {"error": {"code": "insufficient_vram", "message":
 "Cannot load '…/gemma-4-31B-it-QAT-Q4_0' entirely in VRAM: needs 29.09 GiB,
  20.90 GiB usable. … Suggestions: set KV cache type to q8_0 …;
  VRAM is held by other processes: …",
 "studioforge": {
   "required_bytes": 31235974510, "available_bytes": 22438368871,
   "per_gpu_free": {"3": 22438368871},
   "max_ctx_that_fits": null,
   "notes": ["wanted up to 262144 tokens of context but not even the 128000 floor
             fits in the VRAM available right now"],
   "estimate_mb": {"weights_bytes": 16818.2, "kv_bytes": 8575.0,
                   "compute_bytes": 2438.6, …, "total": 29788.9},
   "retry_after_s": null }}}
Foi o modelo de 31 bilhões de parâmetros que tentamos carregar numa única RTX 3090. A mensagem é destinada aos usuários; error.studioforge serve para os programas. Quando um tamanho menor caberia, max_ctx_that_fits indica esse valor. O parâmetro retry_after_s é definido apenas quando o modelo está sobrecarregado; caso contrário, tentar novamente não adiantaria nada.
Pins, TTLs e leases
Um modelo é carregado na primeira solicitação e descarregado após o período de inatividade definido pelo TTL (models.default_ttl_s; atualizado a cada 15 segundos).
Um “pin” representa um estado desejado. Um modelo “pinado” não possui temporizador de inatividade e nunca é removido da memória. Caso ele falhe ou não consiga iniciar, um mecanismo de reconciliação o recarrega, com intervalos que variam de 60 a 900 segundos. Contudo, um comando de descarregamento explícito tem prioridade e mantém o modelo desativado até que alguém o carregue ou “pinne” novamente.
Um “lease” atribui uma ou mais placas gráficas a um modelo específico. Uma placa gráfica sob “lease” fica indisponível para outros modelos; o modelo proprietário é forçado a usar exatamente essas placas. A solicitação de uma placa já alocada resulta em um erro 409 conflict; não há possibilidade de “tomar posse” da placa. Um “lease” também pode ser usado para reservar recursos para programas externos ao servidor: reserve_gpus(devices=[3], reason="ComfyUI render") é a forma como impedimos que geradores de imagens e modelos de linguagem disputem uma mesma placa gráfica.
A remoção de modelos da memória nunca afeta modelos “pinados”, modelos atendendo a solicitações, modelos ainda em processo de carregamento ou placas sob “lease”. Um mecanismo de reequilíbrio em segundo plano pode mover um modelo inativo para uma localização mais adequada, mas isso ocorre no máximo uma vez por modelo a cada 30 minutos – já que o movimento apaga o cache de prompts. Em nossas conversas longas, esse cache abrangia 93% de um prompt contendo 98 mil tokens.
Quando as coisas dão errado
A VRAM é liberada quando o processo que a utilizou termina. No Windows, os processos filhos são criados dentro de um objeto de trabalho anônimo gerado com JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE; assim, o kernel os encerra independentemente de como o processo pai termina. No Linux, utiliza-se PR_SET_PDEATHSIG, que é um mecanismo “melhor esforço”; por isso, uma varredura inicial e o reclaim_orphan_engines capturam os processos que escapam.
Por que existe essa varredura: em 18/08/2026, cerca de 25 GiB de VRAM estavam em uso em duas placas gráficas, mesmo com “tudo parado”. Os responsáveis eram três processos filhos do llama-server.exe, deixados para trás após um teste iniciado e abandonado por um agente de programação. Atualmente, cada processo que utiliza a VRAM é classificado como ours, child-of-live-process, orphan, other-instance ou foreign; somente os processos classificados como orphan são encerrados.
Os códigos de saída têm significado. O valor 2 indica um erro de configuração relacionado à definição de uma chave. O 3 sinaliza conflito de portas: o “tray” aguarda que o processo responsável termine em vez de reiniciá-lo. O código 75 indica que foi solicitado um reinício: o servidor encerra suas atividades (tempo médio de 1,0 segundo) e o “tray” o reinicia sem contar isso como uma falha. Essa separação existe porque, numa ocasião, um reinício via GUI fez com que dois servidores disputassem a porta 1234; o “tray” acabou marcando o servidor como “Crashed”, mesmo estando ele funcionando normalmente.
Quando o gateway fica travado, mas não totalmente inoperante, utilize o watchdog em 1235. Trata-se de um processo independente, criado apenas com argparse e os módulos de logging da biblioteca padrão; portanto, ele inicia mesmo quando o arquivo config.yaml está corrompido. Seus dez comandos são: health, get_config, set_config, restart_server, kill_model, nuke_all_models, reclaim_orphan_engines, tail_logs, gpu_status e rollback_update. Esse watchdog não importa o código que ele próprio repara.
O painel de controle
O painel em 8080 é executado no mesmo processo e não utiliza URLs absolutos; por isso, funciona via HTTP simples ou atrás de um proxy HTTPS. No Windows, também há um ícone na área de notificação.


sfctl, o código de pareamento nunca precisa ser inserido em nenhum arquivo de configuração.Usando-o como backend do harness
A inferência e o gerenciamento são processos separados. Qualquer cliente pode usar /v1 sem precisar instalar nada. Apenas um agente que precise gerenciar a máquina precisa das ferramentas MCP.
Qualquer cliente OpenAI
server.api_key é null por padrão; portanto, qualquer chave não vazia funciona. A maioria dos clientes OpenAI se recusa a iniciar com uma chave vazia.
export OPENAI_BASE_URL=http://my-gpu-rig:1234/v1
export OPENAI_API_KEY=not-required        # any non-empty string while server.api_key is unset

curl http://my-gpu-rig:1234/v1/chat/completions -H "Content-Type: application/json" \
  -d '{"model": "<id from /v1/models>", "messages": [{"role": "user", "content": "hello"}]}'
GET /v1/models lista todos os modelos baixados, no estilo do LM Studio, e adiciona state; para modelos carregados, também exibe ctx_per_slot e max_parallel. Os IDs correspondem ao caminho completo publisher/repo/file, a um nome de arquivo simples ou a publisher/name; a comparação é feita sem diferenciar maiúsculas/minúsculas.
O nome do parâmetro para definir o URL base varia em cada cliente, o que gera muita confusão: Open WebUI usa OPENAI_API_BASE_URL; LibreChat utiliza um endpoint custom com baseURL e models.fetch: true; aider usa OPENAI_API_BASE e depois --model openai/<id>; Continue utiliza provider: openai e apiBase. O dsh aceita o mesmo bloco de configuração do provedor OpenAI que outros servidores (baseURL, apiKeyEnv); o YAML exato está na documentação do dsh. Mesmo um servidor sem chave ainda precisa de alguma credencial, pois os clientes exigem um token de autenticação.
OpenClaw em outra máquina
A máquina com o agente instala um pequeno pacote: sfctl. Ele requer Python 3.11 e não depende do pacote do servidor; portanto, não precisa de CUDA nem de planificador.
sfctl servers add rig http://my-gpu-rig:1234 --api-key <PIN> --use
openclaw mcp add studioforge --command sfctl --arg mcp
Se você editar a configuração manualmente, note que a chave do OpenClaw é mcp.servers, aninhada sob mcp. O mapa plano mcpServers é usado pelo Claude Code, Cline e LibreChat; o esquema do OpenClaw não reconhece esse formato. A configuração de inferência fica em models.providers, sendo a chave baseUrl com um valor em minúsculas: rl.
// ~/.openclaw/openclaw.json
{ "mcp": { "servers": {
      "studioforge": { "command": "sfctl", "args": ["mcp"] } } },
  "models": { "providers": {
      "studioforge": {
        "baseUrl": "http://my-gpu-rig:1234/v1",
        "apiKey": "not-required",
        "api": "openai-completions",
        "models": [ { "id": "<id from /v1/models>", "name": "Rig 27B", "contextWindow": 131072 } ] } } } }
Na versão 0.2.0, o agente vê uma lista combinada de 29 ferramentas: as 19 do gateway e as 10 do watchdog. Três ferramentas do watchdog foram renomeadas para recovery_* para evitar conflitos; restart_server manteve seu nome, pois as mensagens de erro instruem o agente a chamá-lo. Se o servidor principal estiver inativo, a ponte ainda lista as ferramentas de gerenciamento com uma nota explicativa, para que o agente saiba da existência delas. O ciclo executado por um agente é o seguinte:
list_models(limit=N): lista os modelos disponíveis, do mais recente para o mais antigo. Leia a linha recomendada.load_model(**row["load_args"]): passe os parâmetros da linha sem alterações.load_recommended(model_id, ctx_size=N)quando você sabe qual tamanho de contexto precisa; ele recusa a carga caso não seja possível.- Execute a inferência via HTTP, não via MCP. Indicar um modelo não carregado faz com que ele seja carregado usando os padrões do planificador, e não os parâmetros da linha lida.
model_options(model_id)fornece informações sobre velocidade para cada nível de contexto.search_models→repo_details→download_modelpara obter um modelo novo.pin_modelserve para fixar um modelo que deve estar sempre disponível;reserve_gpuserelease_gpuspermitem reservar ou liberar GPUs específicas.server_statuseconnection_info: mostram quais modelos estão carregados, quais agentes utilizam a VRAM e todos os endereços onde o servidor responde.
Todos os clientes recebem também esta nota ao se conectar:
INFERENCE IS NOT HERE. This server exposes no chat/completion/generation tool
by design. To actually run a prompt, use the OpenAI-compatible HTTP API on the
gateway port (POST /v1/chat/completions, /v1/embeddings; GET /v1/models).
Naming an unloaded model in a request just-in-time loads it, so you usually do
not need load_model at all -- reach for it only to pre-warm a model or to load
one with non-default context/quantization settings.
O Claude Code não pode usar este servidor para sua própria inferência. Seus protocolos de gateway são Anthropic Messages, Bedrock e Vertex, e não /v1/chat/completions. Mesmo assim, ele pode utilizar as ferramentas de gerenciamento: claude mcp add studioforge -- sfctl mcp (o parâmetro -- é obrigatório).
As ferramentas de benchmark devem solicitar uma licença via POST /api/leases, aguardar que os modelos estejam livres e recarregar os modelos que foram deslocados. O nosso script antigo usava pkill -f llama-server, o que interrompia todos os backends.
O que um agente pode escolher
Cada linha do catálogo representa uma chamada real ao planificador: indica se o modelo cabe na VRAM disponível, em quais dispositivos, quantos slots são necessários e se caberia caso as GPUs estivessem livres (para que o agente saiba quando fazer o descarregamento). O repo_details lê os cabeçalhos do arquivo GGUF remotamente, por meio de requisições HTTP Range (2–15 MB, armazenados em cache), evitando o download de 20 GB; ele também retorna uma matriz de adequação do modelo ao contexto, calculada pelo mesmo planificador:
| Quantização | 1× RTX 5090 | 2× RTX 5090 | Todas as quatro placas |
|---|---|---|---|
| BF16 (51,8 GiB) | não cabe | 32k no formato q8_0 | 256k |
| Q8_0 (27,9 GiB) | não cabe | 256k | 256k |
| Q5_K_M (19,3 GiB) | 128k no formato q8_0 | 256k | 256k |
| IQ2_M (10,5 GiB) | 256k | 256k | 256k |
unsloth/Qwen3.8-27B-GGUF, calculado em nosso hardware. Os valores indicam o maior tamanho de janela possível com cache f16; “no formato q8_0” aparece apenas onde um cache quantizado permite maior alcance.
A quantização influencia mais do que a quantidade de placas: ao passar de BF16 para Q5_K_M, um modelo passa de “não cabe” para “128k” em uma única placa. Para ajustar um modelo ou testar diferentes configurações, execute benchmark_parallel no modelo escolhido e depois use reserve_gpus.
Instalação
Windows (plataforma de referência):
- Instale o Git, o Python 3.12+, o uv e um driver NVIDIA atualizado.
- Clone o repositório ou descompacte o arquivo baixado.
- Clique duas vezes em
launchers\Update StudioForge.bat. Apesar do nome, esta é a etapa inicial: ela cria o ambiente virtual e instala, testa e fixa a versão mais recente do llama.cpp compatível com seu driver (provavelmente você obterá uma versão mais nova queb10425). - Execute
launchers\Start StudioForge.bat, oulaunchers\StudioForge Tray.batpara usar o ícone na bandeja do sistema. O painel abre emhttp://127.0.0.1:8080, na aba “Setup”, onde a opção “Detect LM Studio library” localiza sua pasta de modelos existente.
No Linux, também são necessários o cmake e um kit de desenvolvimento CUDA cujo nvcc seja compatível com seu driver, pois a versão oficial não disponibiliza compilações CUDA para Linux e o motor é compilado uma única vez por versão. Conforme mencionado, nós mesmos ainda não testamos esse caminho de instalação do início ao fim.
git clone https://github.com/LaserLloyd/StudioForge.git && cd StudioForge
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python -e ".[dev]"
.venv/bin/studioforge serve --open     # first run builds the engine
Em servidores sem interface gráfica, o diretório deploy/ contém duas unidades systemd do tipo user, pois o servidor deve rodar sob o usuário proprietário da biblioteca de modelos, do ambiente virtual e dos dispositivos GPU. A unidade de monitoramento utiliza Restart=always e não depende do gateway, permanecendo ativa mesmo quando este cai. Execute sudo loginctl enable-linger "$USER" para que as unidades iniciem sem necessidade de login.
| Serviço | Porta padrão | Chave de configuração |
|---|---|---|
Gateway (/v1, /api, /mcp) | 1234 | server.port |
| Painel de controle web | 8080 | gui.port |
| Monitoramento de recuperação | 1235 | watchdog.port |
llama-server (apenas loopback) | 18100–18200 | gateway.child_port_start / _end |
A validação de configuração rejeita qualquer porta de serviço que entre em conflito com o intervalo reservado para os processos filhos. O diretório de dados é procurado primeiro em SF_DATA_DIR, depois na pasta onde se encontra o arquivo --config, e por fim em <repo>/data; mais detalhes estão em docs/SETUP.md. Uma única instância pode usar um determinado diretório de dados, graças a um bloqueio exclusivo do sistema operacional.
Segurança
A regra é: leituras, inferências e carregamentos permanecem permitidos; alterações na configuração exigem uma credencial. Com server.api_key não definido, uma solicitação que modifique a configuração, reinicie componentes, atualize o sistema, libere VRAM, faça downloads, alugue recursos ou os exclua só será aceita da mesma máquina, ou se contiver o PIN do MCP em X-MCP-Pin, ou ainda como token de autenticação. Qualquer outra solicitação receberá o erro 403 remote_admin_requires_credential.
- O PIN protege apenas o MCP. Trata-se de um código de pareamento exibido no banner de inicialização; não é uma chave API.
server.api_keyé a verdadeira credencial e vem sem valor definido por padrão. Após ser configurada, ela protege os endpoints/v1,/api,/mcpe também o mecanismo de monitoramento.- Por padrão, os três listeners vinculam-se a
0.0.0.0. A aba “Configuração” torna a linha “Exposição de rede” amarela sempre que algum listener está exposto sem chave de autenticação. Configure uma chave antes de expor qualquer listener. - Uma solicitação de navegador de origem cruzada não é considerada local, mesmo que use loopback. Caso contrário, qualquer página web poderia executar
PATCH /api/configem127.0.0.1:1234. A verificação de origem leva em conta a porta;Origin: nullé considerado um valor estrangeiro. Navegadores remotos nunca têm acesso ao PIN. - Os URLs de imagens são obtidos por meio de um mecanismo de proteção SSRF que bloqueia endereços de loopback, link-local, privados, ULA e CGNAT (
100.64/10, onde ficam os pares da rede mesh-VPN); somente após validação o endereço é acessado.
Existem duas limitações: a verificação de “mesma máquina” considera confiável qualquer solicitação vinda do loopback, que por trás de um proxy reverso corresponde ao próprio proxy; portanto, coloque o proxy atrás de server.api_key. Além disso, há apenas uma chave compartilhada, sem contas ou limitação de taxa de uso. Use-a apenas no loopback, por trás de um proxy autenticador ou em uma rede mesh VPN; nunca na internet aberta.
Limitações
- O Windows é a plataforma de referência. A bandeja do sistema, o mecanismo de proteção da VRAM e os contadores de uso da GPU por processo foram desenvolvidos lá. O Linux roda nos testes de CI (ver Instalação). O macOS não é suportado (não há suporte ao CUDA).
- Apenas NVIDIA. O planejador lê os dados do NVML e o motor de processamento é compilado com CUDA.
- O valor da VRAM é uma estimativa. O tamanho dos pesos está dentro de 2% do tamanho do arquivo; os valores relativos a KV são calculados com precisão a partir do layout de cada camada. Porém, o buffer de computação é um valor calibrado (entre 0,03 e 0,15), mantido na memória e reiniciado após uma reinicialização do sistema.
- A divisão da carga entre múltiplas GPUs é proporcional, não medida. A largura de banda da interconexão entre GPUs não é considerada no cálculo; sistemas com GPUs de gerações diferentes operam na velocidade da GPU mais lenta.
- As estimativas de velocidade baseiam-se em dados fornecidos pelos fabricantes, não em medições reais. Em nosso equipamento, um modelo denso de 31 bilhões de parâmetros alcançou 39,4 tokens/s, contra uma estimativa de 36,1; já um modelo MoE com 122 bilhões de parâmetros obteve 37,3 tokens/s, em vez dos 47,4 previstos.
- Reservar uma GPU para outro programa apenas limita o nosso planejador. Isso não impede que esse programa ou qualquer outro utilize a memória da GPU.
- Detalhes sobre licenças. O StudioForge utiliza a licença MIT. O pystray, responsável por desenhar o ícone na bandeja do Windows, está sob a licença LGPL-3.0. Quando instalado normalmente como pacote separado, basta manter os avisos de licença. Caso prefira, pode incluir o código-fonte do pystray em um único executável ou mantê-lo como módulo independente.
- Ninguém mais auditou esse código. Tudo o que foi descrito acima representa nossa própria descrição do código; portanto, revise-o antes de confiar nele para tarefas críticas.
2.503 testes unitários foram aprovados e 17 foram ignorados em 327 segundos em nosso computador; os testes de CI são executados no Windows e no Ubuntu, utilizando um backend de GPU fictício. Outro conjunto de testes utiliza modelos reais em GPUs reais; esse conjunto está desativado por padrão e requer a definição de uma variável de ambiente, devido ao problema mencionado anteriormente.
Atualização — 2026-10-19 (v2.0.1)
Tudo o que foi descrito acima refere-se à versão 0.2.0. O StudioForge agora está na versão 2.0.1 em main (commit 34f4b03; ainda não há release marcado nem imagem de container publicada). O modelo de segurança também sofreu mudanças significativas, motivo pelo qual escrevemos um texto separado sobre isso: StudioForge 2.0: contas, chaves API com escopo e um caminho seguro de atualização. A versão resumida:
- Loopback por padrão. O gateway, o painel e o watchdog ficam vinculados a
127.0.0.1. Uma configuração que utilize0.0.0.0impede a inicialização do sistema (auth_required_for_remote_bind; código de saída 4), até que haja uma conta proprietária ou uma chave administrativa. - Chaves por cliente. Chaves API com escopo
read,inferenceouadmin; podem ter prazo de expiração e limite de uso, sendo armazenadas em formato hash. A criação da primeira chave ativa a autenticação para todos os chamadores, inclusive programas rodando na mesma máquina. Clientes sem chave recebem resposta401; portanto, crie uma chave para cada cliente antes de iniciar a nova versão. server.api_keyemcp.pinestão obsoletos. A chave antiga continua funcionando como chave administrativalegacy. Para desativar o uso do PIN, definamcp.pin_required: falsee tambémmcp.pin: null; caso contrário, um novo PIN será gerado na próxima inicialização.- Tenants utilizam chaves
inference(versão 2.0.1). Outros programas que usam GPU podem obter e liberar licenças por conta própria, sem precisar de chave administrativa; cada licença fica vinculada à chave que a solicitou. - Também novidades: página de login e guia de configuração com oito etapas no painel, registro de auditoria, TLS opcional, verificação de Origem nos endpoints MCP,
studioforge doctoresupport-bundle; a API REST do LM Studio em/api/v1, além dos endpoints no estilo Anthropic/v1/messagese OpenAI/v1/responses. Há também detecção de ROCm/Vulkan/Metal (não testada em hardware AMD ou Apple real); um Dockerfile com variantes para CUDA, ROCm e Vulkan. Apenas o caminho via CUDA conseguiu rodar modelos até agora. O procedimento completo para empacotar todo o stack em um container está descrito em Todo módulo no Docker. - A seção de Segurança acima está desatualizada. Ela descreve os vínculos de rede da versão 0.2.0 (
0.0.0.0) e o uso do PIN como credencial administrativa remota.
Armadilhas comuns
- Encerre o LM Studio antes de iniciar. Ambos precisam da porta 1234. O parâmetro
server.portdefine o uso da porta pelo StudioForge. Compartilhar a pasta do modelo é permitido. --ctx-sizerefere-se ao total de tokens para todos os slots, não por slot; além disso, o parâmetro--fitvem ativado por padrão. Se você executar diretamente ollama-server, use--fit offe defina manualmente o tamanho do contexto por slot.- Modelos de raciocínio podem retornar uma resposta vazia quando usam
--reasoning-format auto. Para o mesmo prompt, o campocontentcontém 0 caracteres, enquantoreasoning_contentpossui 316 caracteres quando o modo éauto; já comnone, o campocontenttem 323 caracteres. O camporeasoning_contentnão consta no esquema da OpenAI, portanto clientes padrão não o enxergam. Usenonesomente se seu cliente ler esse campo. - Não encerre o processo do tray por força. Em ambientes com venv, o mecanismo de monitoramento opera na mesma árvore de processos; ao tentar reiniciá-lo dessa forma, tanto o servidor quanto o monitoramento foram desativados. Use o menu da bandeja, o painel ou
sfctl recover --restart. - Comandos como
pkill -f llama-serverde outras ferramentas podem desativar seus backends. Nesse caso, faça um novo “lease” da GPU. - O número do barramento
busIdinformado pelo NVML está em hexadecimal. Por exemplo,"00000000:42:00.0"corresponde ao barramento 66; interpretá-lo como decimal resultou na atribuição da VRAM a um chip errado, sem gerar nenhum erro. - Repetir o mesmo prompt em benchmarks de decodificação especulativa acaba medindo apenas o cache de prompts. Use prompts diferentes. O endpoint
/propsainda exibespeculative.types: "none"durante a fase de rascunho; portanto, consulte o valor detimings.draft_nem uma conclusão real. - Modelos de visão não se beneficiam do cache de prompts. O llama.cpp desativa a reutilização do cache para modelos multimodais; além disso, cada imagem consome 1.024 tokens por padrão, então janelas de até 8k tokens são preenchidas rapidamente.
Obtenha-o
O GitHub sempre tem a versão mais recente, incluindo os testes, documentação, lançadores e unidades do systemd:
github.com/LaserLloyd/StudioForge
git clone https://github.com/LaserLloyd/StudioForge.gitO arquivo zip corresponde à versão 0.2.0: main no commit d7e5d26 (25/08/2026), além de pacotes pré-compilados e sdists para ambos os pacotes em dist/. Tudo descrito neste artigo (29 ferramentas, os painéis, o planejador) refere-se a essa versão. O GitHub main já evoluiu para a versão 2.0.1 (veja a atualização acima), que disponibiliza 33 ferramentas MCP, incluindo plan_load, check_loaded_model e as ferramentas relacionadas a tenants. O hash SHA-256 do arquivo zip é:
72e3b44487645e7790ba8497e029868e07ca340f67c92f1834345d4e50839f6d studioforge-2026-08.zipEste arquivo contém apenas os arquivos monitorados (não há config.yaml, nem data/). Licença: MIT: você pode usá-lo, modificá-lo, distribuí-lo ou vendê-lo; basta manter o aviso de direitos autorais. Não há garantia alguma.
Encontrou um bug? Nosso e-mail está na página “Sobre”. As informações úteis são o error.code, os números exibidos no erro 507 e as últimas vinte linhas de logs/models/<model>.log. Por favor, omita o PIN e quaisquer chaves. Solicitações para um planejador de alocação de recursos, predefinições de amostragem ou suporte a GPUs AMD são muito bem-vindas.
O que isso significa para nós
Na maior parte, este projeto consistiu em medições, não em código. O planejador utiliza cálculos aritméticos que qualquer um poderia escrever. Ele só se tornou confiável depois de analisarmos o layout real das estruturas de dados do llama.cpp e medirmos que o número ideal de slots era 2, quando nossa estimativa indicava 8. Se você já utiliza o LM Studio em 1234, para testar isso basta fazer um clone do projeto, criar um arquivo batch e apontar o models.dir para a pasta que você já possui. Caso não valha a pena investir tempo nisso, sua configuração atual permanece inalterada.
Relacionado: DeepSeek Harness (dsh) (o sistema que utiliza este servidor como um provedor OpenAI comum), bench-llm / CrucibleForge (a ferramenta de benchmark que agora utiliza recursos de GPU), Minha configuração com OpenClaw (o post que identificou o problema) e DisPatch (o aplicativo de chat que fica na frente deste sistema).
Downloads
Gratuito para uso pessoal. Se isso te economizar uma tarde, o botão do café está logo ali.