كيف يعمل CrucibleForge: شرح لمعيار تقييم النماذج اللغوية المفتوحة المصدر
- تاريخ النشر
- 7 نوفمبر 2026
- بقلم
- جاكوب لويد — كُتب بمساعدة الذكاء الاصطناعي بعد إنجاز المشروع
- مدة القراءة
- قراءة 1 دقيقة
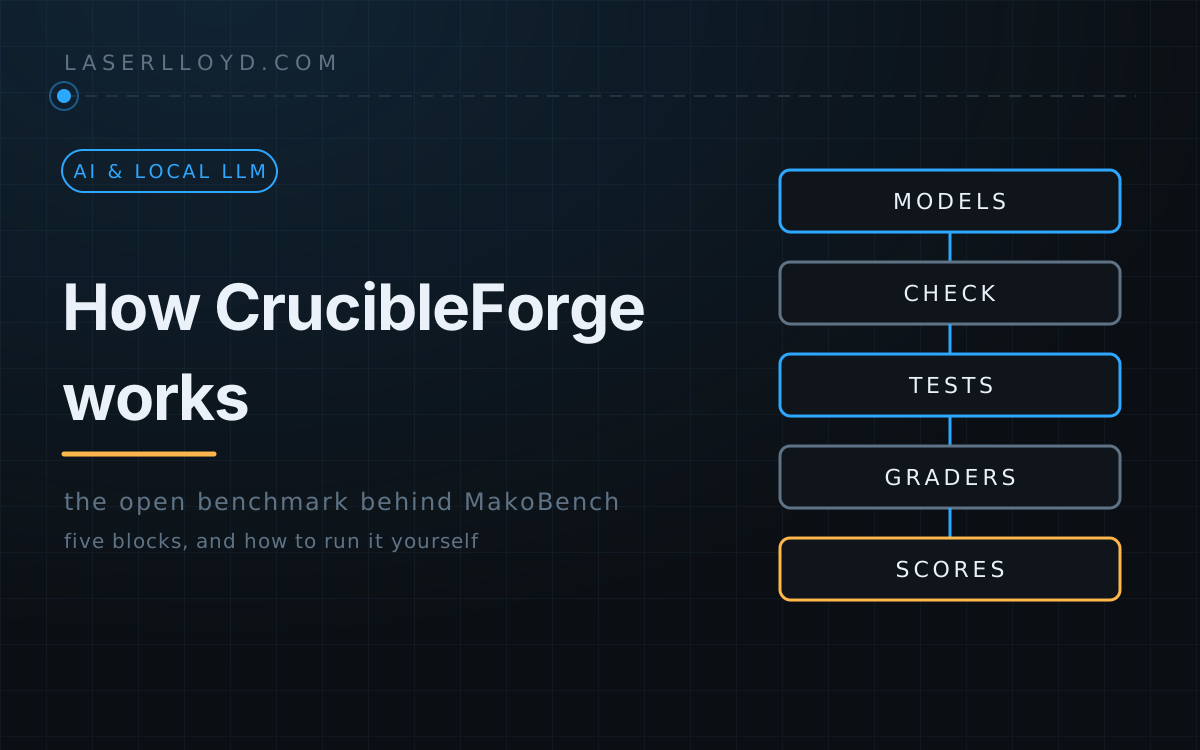
بعبارة مبسطة: CrucibleForge هو أداة مجانية تختبر قدرة نموذج اللغة على كتابة الكود وإجراء محادثات، ثم تمنحه درجة. يمكن استخدامه مع نموذج موجود على جهازك أو مع نموذج يتم الوصول إليه عبر واجهة برمجة التطبيقات الخاصة بإحدى الشركات. تشرح هذه الصفحة الخطوات الخمس التي يتبعها البرنامج، ونوعية الاختبارات، ومن يقوم بالتقييم، وكيفية تشغيله بنفسك باستخدام بعض الأوامر.
CrucibleForge هو أداة مفتوحة المصدر لقياس أداء نماذج اللغة. كل ما عليك فعله هو توجيهه نحو النموذج المراد اختباره؛ حيث يقوم بتشغيل مجموعة ثابتة من الاختبارات، وتقييم الإجابات، ثم كتابة تقرير بالنتائج. MakoBench هو لوحنا العام للنتائج، وكل رقم يظهر عليه ناتج عن استخدام هذه الأداة. يمكنك تشغيل الأداة نفسها على نماذجك الخاصة. إنها مجانية ومتاحة تحت ترخيص MIT-0، لذا لا توجد أي شروط لاستخدامها.
خلاصة مختصرة
- خمسة أقسام رئيسية: النموذج نفسه، فحص الإعدادات، الاختبارات، آليات التقييم، والدرجات.
- يتم تقييم الكود عن طريق تشغيله، بينما يتم تقييم المحادثات بواسطة نموذج خاص يجيب على قائمة من الأسئلة بنعم/لا.
- الدرجة الإجمالية هي مجموع درجات الكود والمحادثات. أما اختبارات المحتوى غير المناسب للأطفال فتُقيّم بشكل منفصل ولا تُضاف إلى الدرجة الإجمالية.
- تعمل الأداة مع أي نقطة وصول من نوع OpenAI. سواء كان خادمًا محليًا أو واجهة برمجية مضيفة، بشرط وضع المفتاح في متغير بيئي.
- يمكنك البدء في الاستخدام خلال عشر دقائق تقريبًا. ولا يتطلب الجهاز الذي يشغلها وجود بطاقة رسومات (GPU).
الكتل الخمسة
هذه هي الأداة بأكملها على المستوى الذي تحتاج إلى استخدامها فيه. كل كتلة تقوم بمهمة واحدة وتسلم نتيجتها إلى الكتلة التالية.

- نماذجك. يتواصل CrucibleForge مع أي نموذج يتحدث بتنسيق الدردشة الخاص بـ OpenAI؛ وهذا يشمل كلًا من الخوادم الموجودة على جهازك والواجهات البرمجية المضيفة لدى الشركات.
- فحص التوافق. تطلب مزودات الخدمات المختلفة تنسيقات طلبات مختلفة قليلاً. قبل إجراء أي اختبارات على النموذج، يتم إرسال سبع طلبات بسيطة للتأكد من أن النظام يتواصل معه بشكل صحيح: يتم إرجاع معرف النموذج، وتصل الإجابات المنطقية إلى المكان المتوقع، وتظل المعلومات ثابتة بين الجولات المختلفة، ويعمل تبادل طلبات الأدوات بشكل سليم، ويتم قبول إعدادات التحكم في توليد النصوص، كما أن مطالبات البرمجة المتوسطة تتناسب مع حدود عدد الرموز المسموح بها؛ بالإضافة إلى ذلك، بالنسبة للمزودات المضيفة، يتم التحقق من أن وثائق المزود قد تم مراجعتها خلال الـ 120 يومًا الماضية. أي فشل في هذا الفحص يعني عدم تشغيل النموذج، لأن الدرجة الناتجة عن طلبات غير صحيحة ستعكس أخطاءً في النظام نفسه وليس في أداء النموذج.
- أداة تشغيل الاختبارات. تقوم هذه الأداة بإرسال حالات الاختبار إلى النموذج بشكل متوازي، ضمن الحدود التي يسمح بها الخادم، وتسجل كل مطالبة وإجابة.
- أدوات التقييم. يتم تقييم كل إجابة باستخدام الطريقة المناسبة لها؛ راجع القسم التالي لمزيد من التفاصيل.
- الدرجات والنتائج. تُجمع الدرجات في فئات “الكود” و“الدردشة” و“المجموع الكلي”، مع بيان هامش الخطأ لكل منها؛ كما تقوم الأداة بإنشاء تقرير. من جانبنا، يُستخدم هذا التقرير في لوحة MakoBench؛ أما من جانبك، فهو ملف يمكنك فتحه في متصفح الويب.
الاختبارات، بعبارات بسيطة
يحتوي التقييم الإجمالي على جزأين؛ كل جزء يمنح 10 نقاط في حالة إتمام الاختبارات القياسية بشكل مثالي. المجموع الكلي هو 20 نقطة. تُفتح مجموعات إضافية من الأسئلة الأصعب عندما يحقق النموذج نسبة 90% أو أكثر في أحد الأجزاء، وهذه هي الطريقة الوحيدة للتجاوز عتبة الـ10 نقاط. لكل إصدار من الاختبارات حد أقصى ثابت؛ واستخدام مجموعات أسئلة جديدة يرفع هذا الحد.
البرمجة: هل يمكنه كتابة برامج وتحليلها؟
- الدوال (5 نقاط). كتابة دالة بلغة بايثون بناءً على وصف معين. تُشغل اختبارات وحدة مخفية في بيئة معزولة؛ ويُمنح التقييم الجزئي بناءً على نسبة مجموعات الاختبارات التي تم اجتيازها.
- التنبؤ وإصلاح الأخطاء (2.5 نقطة). تحديد ما الذي ستطبعه برمجة قصيرة، ثم إيجاد خطأ في مشروع صغير وإصلاحه. يتم مقارنة الإجابات بدقة أو التحقق من صحتها عبر تشغيل الحل المقترح.
- استخدام الأدوات (2.5 نقطة). محادثات مخطط لها مسبقًا يتوجب على النموذج فيها استدعاء الأدوات بشكل صحيح، مع وجود فخوخ مثل استخدام أداة خاطئة أو تمرير وسائط غير صالحة.
لا يتطلب أي من هذه الاختبارات رأيًا بشريًا؛ البرنامج يُشغل ويُحدد ما إذا كان قد اجتاز الاختبار أم لا.
المحادثة: هل يمكنه أن يكون رفيقًا جيدًا في قصة؟
- التمثيل الدرامي العميق (3 نقاط). جلسات طويلة ومعقدة؛ هل يتذكر النموذج معلومة تم ذكرها سابقًا، ويقبل التصحيحات ويحافظ على وجهة نظر الشخصية؟
- المحادثة اليومية (3 نقاط). محادثة عادية مع رفيق افتراضي يجب أن تظل متسقة عبر العديد من المراحل.
- الشخصية المتعددة الأوجه (2 نقطة). شخصية واحدة لها عدة أساليب في التحدث وعادات مختلفة.
- الكتابة الإبداعية (2 نقطة). كتابة قصة مشتركة ضمن قيود صارمة مثل الطول والزمن المستخدم ووجود أو غياب عناصر معينة.
يقيس هذا القسم التمثيل الدرامي والمحادثة اليومية؛ لا يقيّم القدرة على الإجابة على الأسئلة المباشرة، لذا يجب فهمه كمقياس لمدى جودة النموذج في سياق القصص وليس كمقياس لمدى كفاءته كمساعد.
المحتوى غير المناسب للعرض العام: مفصول عمدًا
بعض النماذج صُممت خصيصًا للقصص الإباحية، وهناك أشخاص يرغبون في ذلك بالفعل؛ لذا توجد مجموعة اختبارات مخصصة لهذا الغرض. يحصل هذا القسم على تقييم منفصل (تقييم المحتوى غير المناسب للعرض العام) ولا يُضاف أبدًا إلى التقييم الإجمالي. جميع الشخصيات في هذه الاختبارات بالغون؛ وارتفاع الرقم يعني أن النموذج يذهب إلى حدود أبعد في هذا المجال. مدى فائدة ذلك يعتمد على الغرض الذي تريده منه.
كيف يتم تقييم المحادثات؟
لا يمكن تشغيل إجابات المحادثة، لذا يقوم نموذج تحكيم بقراءتها. لا يمنح هذا النموذج تقييمًا حرًا؛ بل يحمل كل سيناريو قائمة من الأسئلة التي تتطلب إجابة بنعم أو لا، مثل “هل ظلت الشخصية على صيغة المتكلم؟”. لكل سؤال يجيب التحكيم بـ “نعم” أو “لا” ويستشهد بالجملة الداعمة. الإجابة “نعم” التي لا يوجد دليل عليها في النص تُعتبر “لا”. تُطبق قواعد نصية بسيطة مثل حساب الكلمات أو منع استخدام عبارات معينة جنبًا إلى جنب مع عمل التحكيم.
هناك عاملان يضمنان نزاهة التحكيم: أولاً، يجب أن يطرح كل سؤال فكرة واحدة فقط؛ ثانيًا، قبل استخدام أي نموذج تحكيم يتم إجراء اختبار معايرة للتأكد من أنه سيقوم بعمله دون تلاعب أو تجاهل.
الهوامش والتعادلات
لكل تقييم هوامش ± ناتجة عن إجراء اختبارات متعددة. إذا كان الفارق بين نموذجين أقل من هذه الهوامش، فإنهما يُعتبران متعادلين بغض النظر عن ترتيبهما في الجدول. لا تُقارن التقييمات إلا داخل إصدار واحد من مجموعة الاختبارات، ويتم ذكر هذا الإصدار في كل صف من تقارير التقييم.
قم بتشغيله بنفسك في عشر دقائق
تحتاج إلى ثلاثة أشياء: نموذج للاختبار خلف واجهة برمجية على غرار OpenAI، بالإضافة إلى أداة تقييم، وجهاز كمبيوتر مثبت عليه uv. لا يحتاج الجهاز إلى بطاقة رسومات، لذا يمكنك تشغيله من على جهاز لابتوب باستخدام واجهة برمجية مستضافة على الإنترنت. في نظام لينكس، يتم تنفيذ الأوامر داخل bwrap (أداة bubblewrap). أما في ويندوز وماك أو إس فلا يوجد مثل هذا الحل؛ لذا يجب استخدام صورة Docker المذكورة في ملف README، أو إضافة المعلمة --allow-unsandboxed قبل تنفيذ الأوامر، مع العلم أن الكود الذي يولده النموذج سيُنفذ على جهازك.
١. التثبيت
git clone https://github.com/LaserLloyd/CrucibleForge.git
cd CrucibleForge
uv sync --python 3.13
uv run crucibleforge config --init
الأمر الأخير يقوم بإنشاء ملف models.yaml يحتوي على إعدادات لمزودي الخدمات مثل LM Studio وOllama وllama.cpp وأي خادم محلي، بالإضافة إلى DeepSeek وOpenRouter وOpenAI وغيرهم. لا يتم تشغيل أي شيء حتى تقوم بتفعيل أحد المزودين.
٢. حدد مكان وجود النموذج لديك
افتح ملف models.yaml. يحدد كل مزود موقع الخادم، بينما تحدد إعدادات النموذج اسم النموذج المستخدم على ذلك الخادم. في حالة استخدام خادم محلي:
providers:
  mylocal:
    type: openai
    base_url: http://localhost:8080/v1   # your llama.cpp / LM Studio / StudioForge address

models:
  - name: my-model
    provider: mylocal
    model_id: the-id-your-server-reports
    context_length: 32768
للاطلاع على أسماء النماذج المتاحة لدى الخادم، نفذ الأمر التالي:
uv run crucibleforge models discover mylocal٣. تحقق من الإعدادات
uv run crucibleforge statusيُظهر هذا الأمر حالة كل مزود (مفعّل أم لا)، وهل تم إدخال المفاتيح اللازمة أم لا، بالإضافة إلى قائمة النماذج وأداة التقييم وعدد الحالات التي يتم اختبارها. يجب تصحيح أي خطأ يظهر كـ “DOWN” أو “NOT SET” قبل المتابعة.
٤. خطة الاختبار ثم تشغيله
أضف المعلمة --plan إلى أي أمر تشغيل؛ فلن يتم تنفيذ أي شيء، بل سيتم عرض ما سيتم اختباره وتقدير الوقت اللازم لذلك.
uv run crucibleforge all --models my-model --judge mylocal:my-judge --plan
uv run crucibleforge all --smoke --models my-model --judge mylocal:my-judge --yes
عملية الاختبار التجريبي تغطي مجموعة صغيرة من الحالات: توليد النصوص، تقييمها، ثم إنشاء التقرير. هذه العملية تثبت أن الإعدادات صحيحة. في اختباراتنا، استغرقت العملية أقل من دقيقتين وكلفت حوالي سنتين أمريكيين فقط عند استخدام نموذج مستضاف على الإنترنت. لا يُعتبر هذا الاختبار مقياسًا للأداء، لأنه يغطي جزءًا بسيطًا من إجمالي ٣٣ حالة اختبار؛ ولذلك يظهر التقرير أن النموذج “جزئي” دون وجود تقييم إجمالي أو ترتيب.
٥. اقرأ التقرير
افتح ملف results/report.html في متصفحك، أو اقرأ ملف results/report.md. بجانبهما يوجد ملف failures.md وملف report.json، بالإضافة إلى سجل كامل لكل الأسئلة والإجابات التي قدمها النموذج. أما عملية الاختبار الكاملة، والتي تتم باستخدام نفس الأمر دون إضافة المعلمة --smoke، فتستغرق حوالي ٢٥ إلى ٣٠ دقيقة لكل نموذج محلي على جهاز يحتوي على بطاقة رسومات قوية، مع احتساب وقت تقييم النموذج أيضًا. وللحصول على واجهة رسومية سهلة الاستخدام، نفذ الأمر uv run crucibleforge gui ثم افتح العنوان الذي يظهر لك؛ حيث يعمل البرنامج محليًا على جهازك فقط بشكل افتراضي.
الاتصال بواجهة خلفية أو واجهة برمجية
لا يحتوي CrucibleForge على أي نماذج داخله؛ فهو مجرد عميل. كل ما يحتاجه موجود في ملف models.yaml، ويقسم إلى ثلاثة أجزاء: مزود الخدمة، والنموذج، والمُقيِّم.
الخادم المحلي
استخدم type: openai وعنوان الخادم. ومن الأمثلة على العناوين الشائعة:
- خادم llama.cpp:
llama-server، العنوان:http://127.0.0.1:8080/v1 - LM Studio:
http://localhost:1234/v1 - Ollama:
http://localhost:11434/v1 - vLLM:
http://localhost:8000/v1 - StudioForge: بوابته على المنفذ 1234، العنوان:
/v1(وليس منفذ لوحة التحكم). استخدمtype: studioforgeإذا أردت أن يقوم CrucibleForge بتخصيص وحدة معالجة الرسومات وتحميل النماذج عبر مخطط الخادم.
إذا طلب الخادم مفتاحًا، فقم بتسمية المتغير البيئي بـ api_key_env. ولا تقم بلصق المفتاح داخل الملف.
واجهة برمجية مستضافة
providers:
  deepseek:
    type: openai
    base_url: https://api.deepseek.com/v1
    api_key_env: DEEPSEEK_API_KEY
    concurrency: 8

models:
  - name: deepseek-flash
    provider: deepseek
    model_id: deepseek-flash
    context_length: 131072
export DEEPSEEK_API_KEY=... # your own key, set in your shell
uv run crucibleforge statusيحتوي ملف الإعدادات الابتدائي بالفعل على إدخالات لـ DeepSeek وOpenAI وOpenRouter وغيرها. كما يعمل Claude مباشرةً؛ فشركة Anthropic توفر نقطة اتصال متوافقة مع OpenAI، لذا يكفي استخدام مزود بـ type: openai وعنوانه base_url: https://api.anthropic.com/v1 بالإضافة إلى مفتاح Anthropic الخاص بك. أما المزودون الذين لا يملكون نقطة اتصال من طراز OpenAI فيمكن الوصول إليهم عادةً عبر OpenRouter. تتطلب التشغيلات المستضافة دفع تكاليف فعلية، لذا استخدم --plan وقم بتشغيل اختبار تجريبي أولاً. قم بتحديد price للنموذج المستضاف (بالدولارات لكل مليون رمز تم إرساله أو استقباله)، وستظهر في التقرير عمود بعنوان تكلفة التشغيل: وهو ما تكلفه تشغيلة واحدة من اختبارات الكود والدردشة بالأسعار المحددة، وذلك للجزء المتعلق بتوليد النصوص فقط. أما الخطط الثابتة فلا تتضمن فواتير حسب عدد الرموز، لذا اكتب basis: list داخل كتلة الأسعار؛ حيث يتم تقدير التكلفة باستخدام علامة ~ بناءً على عدد الرموز بأسعار القائمة. أما النماذج التي تعمل على أجهزتك فتظهر بعلامة “-”. يحذر CrucibleForge ويمتنع عن التشغيل إذا لم يكن هناك سعر محدد لنموذج مستضاف.
تقوم بعض مزودي الخدمات بتطبيق مرشحات محتوى قد تمنع ظهور رد معين. يقوم CrucibleForge بتسجيل هذه الحالات من خلال النصوص المسجلة في كل تقرير، ويضع علامة “blocked” ملاحظة على الصف المعني، كما يمنح الردات المحظورة درجة صفر. ولا يتوجب عليك فعل أي شيء لتفعيل هذه الميزة.
المُقيِّم
تحتاج اختبارات الدردشة إلى مُقيِّم، ويجب ألا يكون هذا المُقيِّم هو النموذج قيد الاختبار. يمكن أن يكون نموذجًا آخر على خادمك المحلي أو نموذجًا مستضافًا. يمكن تحديده لكل تشغيلة باستخدام --judge provider:model_id، أو قائمة المرشحين تحت judge: في ملف models.yaml. وهناك نقطتان يجب معرفتهما:
- يؤثر المُقيِّم على درجات الدردشة. لن تتطابق أرقام الدردشة الخاصة بك مع لوحة تحكم MakoBench إلا إذا استخدمت نفس المُقيِّم. أما اختبارات الكود فتعمل بغض النظر عن ذلك، لأنها تُقيَّم عبر تشغيلها فعليًا.
- يرفض معظم المُقيِّمات المستضافة أو يخففون من حدة النصوص ذات المحتوى الجنسي. وتلاحظ عملية المعايرة ذلك. ومع ذلك، تستمر بقية اختبارات الدردشة في الحصول على درجات، بينما تظل الصفوف المتعلقة بالمحتوى غير اللائق في حالة “غير مُقيَّمة” حتى تقوم بتقييمها باستخدام نموذج مناسب.
المضي قدمًا
crucibleforge conform --models my-modelيقوم بتشغيل سبع عمليات تحقق إعدادية بشكل منفصل.crucibleforge cases verifyيعيد حساب جميع الإجابات الصحيحة دون اتصال بالإنترنت، كاختبار ذاتي.crucibleforge reportيعيد إنشاء التقرير من النتائج المحفوظة مسبقًا.- توجد النتائج في مجلد
results/بجانب ملفmodels.yaml، وبالتالي تظل على جهازك.
يحتوي ملف README على إرشادات حول استخدام Docker، وكيفية تشغيل العمليات بشكل منفصل، وكيفية الحفاظ على خصوصية الاختبارات المخصصة، بالإضافة إلى كيفية إضافة حالات اختبار جديدة. هل تريد فقط الأرقام؟ يحتوي لوحة تحكم MakoBench على النتائج الخاصة بالنماذج التي قمنا بتشغيلها، ويمكنك أيضًا طلب منا تشغيل نموذجك الخاص. لمعرفة كيفية فهم النتائج بشكل تفصيلي، راجع كيف يعمل MakoBench. وللحصول على دليل تثبيت شامل مع نتائج فعلية، راجع تشغيل CrucibleForge على نماذجك الخاصة.