Fonctionnement de CrucibleForge : un benchmark open source pour les grands modèles linguistiques, expliqué
- Catégorie
- IA et LLM locaux
- Publié
- 7 novembre 2026
- Par
- Jacob Lloyd — rédigé avec l'aide de l'IA, une fois le projet terminé
- Temps de lecture
- 14 min de lecture
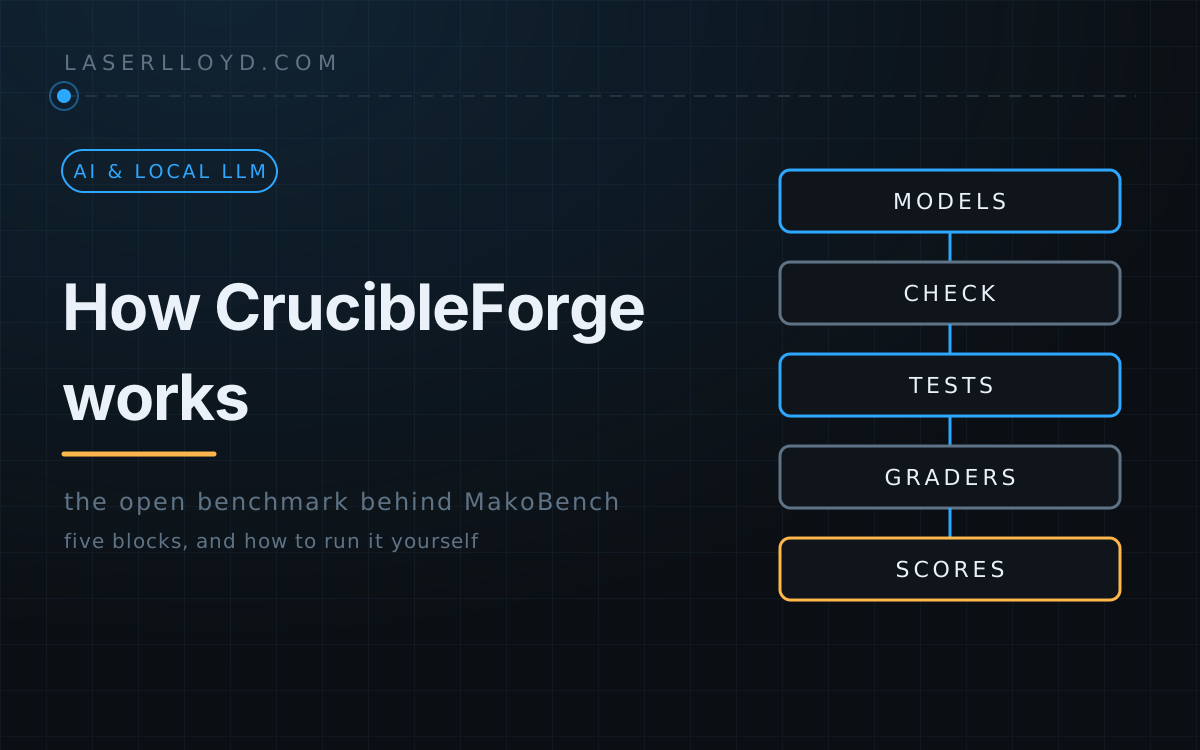
En clair : CrucibleForge est un outil gratuit qui teste un modèle de langage en lui demandant d’écrire du code et de tenir une conversation, puis lui attribue une note. Il fonctionne avec un modèle installé sur votre propre ordinateur ou avec un modèle auquel vous accédez via l’API d’une entreprise. Cette page décrit les cinq étapes du processus, les tests effectués, qui procède à la notation, ainsi que la manière de l’exécuter vous-même en quelques commandes.
CrucibleForge est un outil de référence open source pour les modèles linguistiques. Vous le dirigez vers un modèle, il exécute un ensemble prédéfini de tests, évalue les réponses et génère un rapport. MakoBench est notre tableau de bord public ; chaque chiffre qui y figure provient de cet outil. Vous pouvez utiliser le même outil sur vos propres modèles. Il est gratuit et distribué sous licence MIT-0, donc son utilisation ne comporte aucune condition.
En bref
- Cinq composants. Votre modèle, un contrôle de configuration, les tests, les évaluateurs et les scores.
- Le code est évalué en l’exécutant. Les conversations sont évaluées par un modèle juge qui répond à une liste de questions par oui/non.
- Le score total est la somme des scores du code et des conversations. Les tests NSFW sont notés séparément et ne sont jamais ajoutés au total.
- L’outil fonctionne avec tout endpoint compatible OpenAI. Que ce soit un serveur local ou une API hébergée, il suffit de définir la clé dans une variable d’environnement.
- Vous pouvez le mettre en marche en une dizaine de minutes. L’ordinateur nécessaire pour l’exécuter n’a pas besoin de GPU.
Les cinq étapes
Il s’agit de l’ensemble du processus tel que vous devez le utiliser. Chaque étape effectue une tâche précise et transmet son résultat à l’étape suivante.

- Vos modèles. CrucibleForge communique avec tout système capable de suivre le format de chat d’OpenAI. Cela inclut aussi bien un serveur installé sur votre machine qu’une API hébergée par une entreprise.
- Vérification de conformité. Les différents fournisseurs exigent des requêtes légèrement différentes. Avant de lancer les tests, sept appels simples confirment que le système communique correctement avec le modèle : l’identifiant du modèle est renvoyé, le raisonnement s’affiche là où attendu, un fait persiste entre les tours de dialogue, les appels aux outils fonctionnent dans les deux sens, les paramètres de génération sont acceptés, un prompt de codage moyen respecte le budget en tokens, et pour les fournisseurs hébergés, la documentation officielle a été consultée au cours des 120 derniers jours. Un échec à cette vérification signifie que le modèle ne sera pas testé, car un score obtenu à partir d’une requête erronée refléterait les défauts du système et non ceux du modèle.
- Exécution des tests. Les cas de test sont envoyés au modèle en parallèle, dans la limite autorisée par le serveur, puis chaque prompt et réponse sont enregistrés.
- Évaluation des résultats. Chaque réponse est notée selon la méthode adaptée. Voir la section suivante pour plus de détails.
- Calcul des scores et sortie finale. Les notes se regroupent en catégories Code, Chat et Total, chacune ayant sa propre marge d’erreur. Le programme génère ensuite un rapport. De notre côté, ce rapport alimente le tableau MakoBench ; de votre côté, il s’agit simplement d’un fichier report.html que vous pouvez ouvrir dans un navigateur.
Les tests, en termes simples
Le score global se compose de deux parties, chacune valant dix points pour une exécution parfaite des tests standards. Le total est la somme des deux, soit 20 points au maximum. Des ensembles de questions plus difficiles se débloquent lorsqu’un modèle obtient 90 % ou plus à l’une des parties ; c’est le seul moyen de dépasser les 10 points. Chaque version des tests possède un maximum fixe ; un nouvel ensemble de questions augmente ce maximum.
Code : le modèle sait-il écrire et raisonner sur des programmes ?
- Fonctions (5 points). Écrire une fonction Python à partir d’une description. Des tests unitaires sont exécutés dans un environnement isolé. Les points attribués dépendent du pourcentage de groupes de tests réussis.
- Prédiction et débogage (2,5 points). Prédire exactement ce qu’affiche un petit programme, puis trouver et corriger une erreur dans ce même programme. Les réponses sont comparées textuellement ou vérifiées en exécutant la correction.
- Utilisation d’outils (2,5 points). Conversations scriptées où le modèle doit utiliser correctement des outils, avec des pièges tels qu’un mauvais outil ou un argument invalide.
Rien de tout cela ne nécessite d’opinion subjective. Le code s’exécute, et il réussit ou échoue.
Chat : le modèle fait-il un bon compagnon dans une histoire ?
- Jeu de rôle approfondi (3 points). Séances longues et riches en lore. Le modèle se souvient-il d’un détail mentionné précédemment, accepte-t-il une correction tout en conservant le point de vue du personnage ?
- Conversation (3 points). Un échange quotidien où la cohérence doit être maintenue sur plusieurs tours de dialogue.
- Personnage (2 points). Un seul personnage capable d’adopter différentes voix et habitudes.
- Écriture créative (2 points). Rédaction collective d’une histoire sous diverses contraintes : longueur, temps verbal, éléments obligatoires ou interdits, etc.
Le volet « Chat » évalue le jeu de rôle et la capacité à tenir une conversation. Il ne note pas les simples réponses à des questions ; considérez-le donc comme un indicateur de la qualité du modèle dans un contexte narratif, et non de ses compétences en tant qu’assistant.
NSFW : tests séparés exprès
Certains modèles sont conçus pour la fiction pour adultes, et certaines personnes en ont précisément besoin ; c’est pourquoi il existe un groupe de tests dédié. Ce volet génère son propre score (le « score NSFW ») qui n’est jamais ajouté au total. Tous les personnages dans ces tests sont majeurs. Un score plus élevé signifie simplement que le modèle va plus loin dans ce domaine ; son utilité dépend de vos besoins.
Fonctionnement de la notation « Chat »
Les réponses du volet « Chat » ne peuvent pas être exécutées, c’est pourquoi un modèle juge les analyse. Ce dernier ne délivre pas de note librement. Chaque cas comporte une liste de questions à répondre par oui ou non, par exemple : « Le personnage est-il resté à la première personne ? ». Pour chacune, le juge indique oui ou non et cite la phrase qui le prouve. Une réponse affirmative sans citation valable est comptée comme négative. Des règles textuelles, telles que des comptages ou l’interdiction de certains mots, s’appliquent également.
Deux mécanismes garantissent l’intégrité du juge. D’abord, chaque question doit porter sur un seul aspect précis. Ensuite, avant toute utilisation, un test de calibration vérifie que le juge remplit bien sa tâche sans la minimiser ou la refuser tacitement.
Marges et ex æquo
Chaque score inclut une marge ± calculée via des échantillonnages répétés sur les cas de test. Deux modèles dont les scores se situent dans ces marges sont considérés comme à égalité, quelle que soit leur position dans le tableau. Les comparaisons ne portent que sur une même version du jeu de tests, identifiée dans chaque ligne du rapport.
Exécutez-le vous-même en dix minutes
Vous avez besoin de trois choses : un modèle à tester derrière un endpoint similaire à celui d’OpenAI, un juge, et une machine sur laquelle uv est installé. La machine n’a pas besoin de GPU ; vous pouvez donc l’exécuter depuis un ordinateur portable en utilisant une API hébergée. Sous Linux, les réponses générées s’exécutent dans bwrap (bubblewrap). Sous Windows et macOS, il n’y a pas de pare-feu intégré ; utilisez donc l’image Docker indiquée dans le README ou ajoutez --allow-unsandboxed avant la sous-commande, en acceptant que le code généré par le modèle s’exécute directement sur votre machine.
1. Installation
git clone https://github.com/LaserLloyd/CrucibleForge.git
cd CrucibleForge
uv sync --python 3.13
uv run crucibleforge config --init
La dernière commande crée un fichier de démarrage models.yaml contenant des configurations pour LM Studio, Ollama, llama.cpp ou tout autre serveur local, DeepSeek, OpenRouter, OpenAI et quelques autres fournisseurs. Rien ne s’exécute tant que vous n’activez pas un fournisseur.
2. Indiquez où se trouve votre modèle
Ouvrez models.yaml. Un fournisseur précise l’emplacement du serveur, tandis qu’une entrée de modèle désigne un modèle spécifique sur ce serveur. Pour un serveur local :
providers:
  mylocal:
    type: openai
    base_url: http://localhost:8080/v1   # your llama.cpp / LM Studio / StudioForge address

models:
  - name: my-model
    provider: mylocal
    model_id: the-id-your-server-reports
    context_length: 32768
Pour voir les identifiants proposés par un serveur, interrogez-le ainsi :
uv run crucibleforge models discover mylocal3. Vérifiez la configuration
uv run crucibleforge statusCette commande affiche chaque fournisseur avec son statut (UP ou DOWN), indique si sa clé d’accès est définie, liste vos modèles, le juge ainsi que le nombre de cas à tester. Corrigez tout élément marqué DOWN ou NOT SET avant de continuer.
4. Planification, puis exécution test
Ajoutez --plan à toute commande d’exécution : aucune action ne sera réellement effectuée. Le programme affiche simplement ce qui serait exécuté ainsi qu’une estimation du temps nécessaire.
uv run crucibleforge all --models my-model --judge mylocal:my-judge --plan
uv run crucibleforge all --smoke --models my-model --judge mylocal:my-judge --yes
L’exécution test couvre un petit sous-ensemble de cas : génération, évaluation par le juge et création du rapport. Elle prouve que votre configuration fonctionne correctement. Avec un modèle hébergé, l’opération ne prend qu’une minute ou deux et coûte environ deux cents dans notre test. L’exécution test ne produit pas de score définitif, car elle ne couvre qu’une fraction des 33 cas disponibles. Le rapport indique simplement que le modèle est partiellement validé, sans mention de score global ni de classement.
5. Lisez le rapport
Ouvrez results/report.html dans un navigateur, ou lisez results/report.md. À côté se trouvent failures.md, report.json ainsi que la transcription de chaque prompt et de chaque réponse générée par le modèle. Une exécution complète, effectuée avec la même commande mais sans --smoke, prend environ 25 à 30 minutes pour chaque modèle local, y compris le temps nécessaire au juge. Pour une version graphique, lancez uv run crucibleforge gui puis ouvrez l’adresse indiquée ; par défaut, elle n’est accessible que depuis votre propre machine.
Connexion à un backend ou à une API
CrucibleForge ne contient aucun modèle en lui-même ; c’est un client. Tout ce dont il a besoin se trouve dans models.yaml, sous trois formes : un fournisseur, un modèle et un juge.
Serveur local
Utilisez type: openai ainsi que l’adresse du serveur. Voici quelques adresses courantes :
llama-serverde llama.cpp :http://127.0.0.1:8080/v1- LM Studio :
http://localhost:1234/v1 - Ollama :
http://localhost:11434/v1 - vLLM :
http://localhost:8000/v1 - StudioForge : son passerelle sur le port 1234,
/v1(pas le port du panneau de contrôle). Utiliseztype: studioforgesi vous souhaitez que CrucibleForge réserve un GPU et charge les modèles via le planificateur du serveur.
Si le serveur demande une clé, nommez la variable d’environnement avec api_key_env. Ne collez jamais la clé directement dans le fichier.
API hébergée
providers:
  deepseek:
    type: openai
    base_url: https://api.deepseek.com/v1
    api_key_env: DEEPSEEK_API_KEY
    concurrency: 8

models:
  - name: deepseek-flash
    provider: deepseek
    model_id: deepseek-flash
    context_length: 131072
export DEEPSEEK_API_KEY=... # your own key, set in your shell
uv run crucibleforge statusLe fichier de démarrage contient déjà des entrées pour DeepSeek, OpenAI, OpenRouter et d’autres. Claude fonctionne également directement : Anthropic propose un point de terminaison compatible avec OpenAI ; il suffit donc de spécifier un fournisseur avec type: openai, base_url: https://api.anthropic.com/v1 ainsi que votre clé Anthropic. Un fournisseur ne proposant pas de point de terminaison au style OpenAI peut généralement être atteint via OpenRouter. Les exécutions sur des serveurs hébergés ont un coût réel ; utilisez donc --plan et effectuez d’abord un test limité. Attribuez à chaque modèle hébergé un price (en dollars par million de tokens entrants et sortants) ; le rapport affichera alors une colonne Coût d’exécution indiquant ce que coûte une exécution des tests standard Code et Chat à ce tarif, génération seule. Pour un abonnement forfaitaire sans facturation au token, indiquez basis: list dans le bloc de prix ; le coût sera alors marqué d’un ~ en tant qu’estimation basée sur le nombre de tokens au tarif standard. Un modèle exécuté sur votre propre matériel affiche un tiret. CrucibleForge émet une alerte et refuse de démarrer si un modèle hébergé ne possède pas de prix défini.
Certains fournisseurs appliquent un filtre de contenu susceptible de bloquer certaines réponses. CrucibleForge enregistre ces cas dans les transcriptions à chaque rapport, marque la ligne concernée par un compteur “blocked” et une note explicative, puis attribue une note nulle à la réponse bloquée. Vous n’avez rien à faire pour activer cette fonctionnalité.
Le juge
Pour les tests de Chat, il faut un juge ; ce dernier ne doit pas être le modèle testé. Il peut s’agir d’un second modèle sur votre serveur local ou d’un modèle hébergé. Indiquez-le pour chaque exécution via --judge provider:model_id, ou listez les candidats sous judge: dans models.yaml. Deux points importants à retenir :
- Le juge influence les scores de Chat. Vos résultats de Chat ne correspondront au tableau de classement MakoBench que si vous utilisez le même juge. Pour les tests de Code, cela n’a pas d’importance, car ces derniers sont notés en exécutant effectivement le code.
- La plupart des juges hébergés refusent ou atténuent les contenus à caractère adulte. Le contrôle de calibration le détecte. Le reste des tests Chat est tout de même noté ; quant aux lignes NSFW, elles restent marquées “unjudged” jusqu’à ce que vous les évaluiez avec un modèle capable de le faire.
Aller plus loin
crucibleforge conform --models my-modelexécute les sept vérifications de configuration de manière autonome.crucibleforge cases verifyrecalcule toutes les réponses attendues hors ligne, en guise de auto-test.crucibleforge reportregénère le rapport à partir des résultats stockés.- Les résultats se trouvent dans
results/, à côté de votre fichiermodels.yaml; ils restent donc sur votre machine.
Le fichier README décrit la procédure d’utilisation avec Docker, les exécutions en arrière-plan, comment garder un test personnalisé privé, ainsi que la manière d’ajouter de nouveaux cas de test. Souhaitez-vous uniquement les chiffres ? Le tableau de bord MakoBench présente ces données pour les modèles que nous avons testés, et vous pouvez nous demander d’en tester un nouveau. Pour une explication détaillée sur l’interprétation des scores, consultez Comment fonctionne MakoBench. Enfin, pour un guide d’installation accompagné de sorties réelles, voyez Exécuter CrucibleForge sur vos propres modèles.