CrucibleForgeの仕組み:オープンなLLMベンチマークの解説
- カテゴリ
- AIとローカルLLM
- 公開日
- 2026年11月7日
- 著者
- Jacob Lloyd — プロジェクト完了後、AIの支援を受けて執筆
- 読了時間
- 約17分で読めます
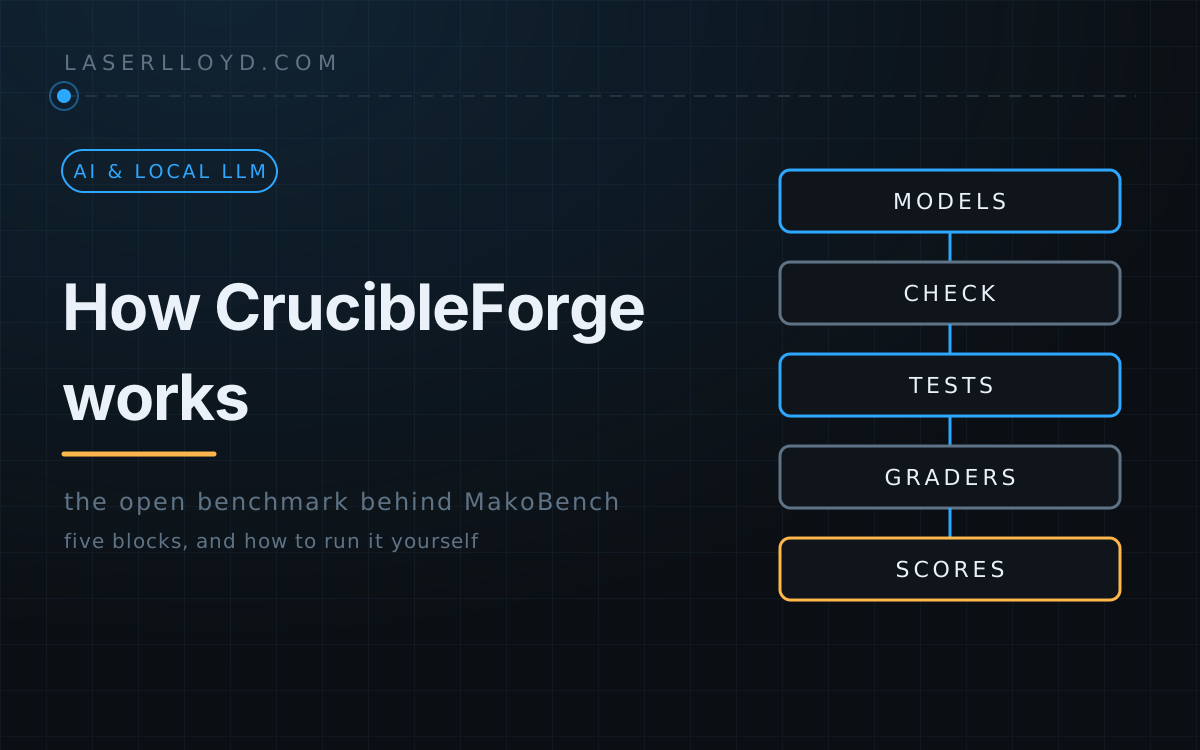
かんたんに言うと: CrucibleForgeは無料のツールで、言語モデルに対してコード記述や会話能力をテストし、そのスコアを算出します。ご自身のコンピューター上にあるモデルでも、企業が提供するAPI経由でも利用可能です。このページでは、処理が5段階に分かれていること、各テストの内容、採点を行う仕組み、そして数個のコマンドで自分でも実行できる方法を解説します。
CrucibleForgeは言語モデル向けのオープンソースベンチマークです。任意のモデルを指定すると、一連のテストが実行され、その回答が採点されてレポートが作成されます。MakoBenchは私たちが公開しているスコアボードで、掲載されている数値はすべてこのツールによって算出されたものです。皆様もご自身のモデルに対して同じツールを実行することが可能です。本ツールは無料かつMIT-0ライセンスに基づいて提供されておりますので、利用に関する制限は一切ありません。
要約
- 5つのブロック構成です。 モデル指定、設定確認、テスト実行、採点処理、そして最終スコアがそれにあたります。
- コードは実際に実行して採点され、チャットの回答は判定用モデルによって「はい/いいえ」のチェックリスト形式で評価されます。
- 総合スコアはコード部門とチャット部門の合計値です。 NSFW関連のテストは別途採点され、総合スコアには含まれません。
- OpenAI形式のエンドポイントであればどんな環境でも利用可能です。 ローカルサーバーでもクラウド上のAPIでも問題なく動作し、認証キーは環境変数として設定します。
- 約10分程度で実行準備が整います。 また、GPUを必要とするような計算も一切行われません。
5つのブロックについて
これが実際に使う際に必要なツール全体です。各ブロックがそれぞれ一つの処理を行い、その結果を次のブロックへと渡しています。

- 使用するモデルです。 CrucibleForgeは、OpenAIのチャット形式に対応しているあらゆるものと通信できます。つまり、自分のマシン上で動作するサーバーであれ、企業が提供するホスティング型APIであれ、どちらとも連携可能です。
- 互換性の確認です。 各プロバイダーごとに若干異なるリクエスト形式が求められます。モデルをベンチマークする前に、7回の簡易的な呼び出しを行い、ハーネスが正しく通信できるかを確認します。具体的には、モデルIDが適切に返されること、推論結果が期待通り得られること、会話の文脈が維持されること、ツール呼び出しの往復処理が機能すること、サンプラー設定が受け入れられること、適度な長さのコーディングプロンプトがトークン制限内に収まること、そしてホスティング型プロバイダーの場合は過去120日以内にベンダーのドキュメントが確認済みであることを検証します。いずれかのチェックに失敗した場合、そのモデルは実行されません。なぜなら不適切なリクエストから得られるスコアはモデルではなくハーネスの性能を測ることになってしまうからです。
- テストランナーです。 この機能が各テストケースをモデルに送信します。サーバーの許容範囲内で並列処理も可能で、すべてのプロンプトと回答が記録されます。
- 採点器です。 それぞれの回答は該当する採点方法によって評価されます。詳細は次のセクションをご覧ください。
- スコアと出力結果です。 各回答の採点結果は「コード」「チャット」「合計」という3つの項目に集約され、それぞれに誤差範囲も示されます。そしてこのツールがレポートを生成します。私たち側ではそのデータがMakoBenchの掲示板に反映されます。利用者様側ではブラウザで開けるファイルとして提供されます。
テスト内容について、分かりやすく説明します
合計スコアは二つの部分から成り、それぞれ標準テストを完璧にこなした場合に10点ずつ得られます。これらを足し合わせた値が全体のスコアとなり、最大で20点になります。各パートで90%以上の正答率を達成すると、より難易度の高い問題が含まれたボーナスパックが解禁されます。これが10点を超える唯一の方法です。各テストバージョンには最大スコアが定められており、新しいパックが追加されるとその上限も引き上がります。
コーディング:プログラムの作成や論理的思考はできるか?
- 関数作成(5点)。 説明に基づいてPython関数を記述します。隠された単体テストがサンドボックス環境で実行されます。得点は、合格したテストグループの割合に応じて付与されます。
- 予測とバグ修正(2.5点)。 短いプログラムが出力する内容を正確に答えた後、小規模なプロジェクト内のバグを見つけて修正します。回答は正確さで評価されるか、修正内容を実行して確認されます。
- ツール利用(2.5点)。 モデルが適切にツールを呼び出す必要があるシナリオです。間違ったツールや不適切な引数といった罠も含まれます。
これらは主観的な判断を要するものではありません。コードが実行され、合格または不合格となるだけです。
対話能力:物語の中で良き相手になれるか?
- 深いロールプレイ(3点)。 背景設定が豊富な長尺のセッションです。モデルは先に提示された事実を覚えており、訂正を受け入れつつキャラクターの視点を維持できるかが問われます。
- 日常的な会話(3点)。 多数のやり取りを通じて一貫性を保ち続ける、日常的な相棒としての対話能力です。
- キャラクター表現(2点)。 複数の口調や習慣を持つ単一のキャラクターを描写する能力です。
- 創作執筆(2点)。 文字数や時制、必須または禁止事項など、さまざまな制約下で共同で物語を作成します。
対話テストではロールプレイや相棒としての会話能力が測られます。単純な質疑応答の能力は評価対象外ですので、これはモデルが物語の中でどれほど良い役割を果たせるかを示すものとご理解ください。アシスタントとしての優秀さを示すものではありません。
NSFW:意図的に別グループに分けています
成人向けコンテンツ用に開発されたモデルも存在し、そうした用途を求める利用者もいるため、専用のテスト群が設けられています。こちらは独自のスコア(NSFWスコア)が付与され、合計スコアには一切加算されません。テスト内の登場人物は全員成人です。数値が高いほどモデルが過激な内容を生成する傾向があることを示しますが、それが利用目的に適しているかは状況によります。
対話評価の仕組み
対話の回答は実行不可能なため、判定用モデルが内容を読み取ります。このモデルは自由記述形式での採点は行いません。各ケースには「キャラクターが一人称で話しているか」といった「はい/いいえ」で答える質問のリストがあり、判定モデルはそれぞれに回答し、裏付けとなる文章を引用します。返答内にその根拠となる文が存在しない場合、「はい」とされた回答も無効となります。また文字数や禁止フレーズといった単純な規則も判定モデルと並行して適用されます。
判定の公正さを保つため二つの仕組みがあります。まず、各チェック項目は必ず一つの事柄のみを問う形になっています。さらに判定モデルが実際に任務を遂行できるか、無断で拒否したり評価を甘くしたりしないかを確認するための校正テストも事前に行われます。
誤差範囲と同点の扱い
各スコアにはテストケース群から算出されたブートストラップ法による ± の誤差範囲が付与されます。二つのモデルの差がこの範囲内である場合、表上での順位に関係なく同点とみなされます。なおスコア比較は常に同じテストセット内で行われ、各行にはそのバージョン情報も記載されています。
10分で自分でも実行可能です
必要なものは3つだけです。OpenAI風のエンドポイント経由でテストするためのモデル、判定用プログラム、そして uv がインストールされたマシンです。GPUは不要なので、ホスト型APIを利用しながらノートパソコン上でも実行できます。Linux環境では bwrap(バブルウラップ)の中でコードが実行されます。WindowsやmacOSにはこれがありませんので、READMEに記載されているDockerイメージを利用するか、サブコマンドの前に --allow-unsandboxed を付与し、モデルが生成したコードがあなた自身の権限で実行されることを承諾してください。
1. インストール
git clone https://github.com/LaserLloyd/CrucibleForge.git
cd CrucibleForge
uv sync --python 3.13
uv run crucibleforge config --init
最後のコマンドにより、LM Studio、Ollama、llama.cpp、その他のローカルサーバー、DeepSeek、OpenRouter、OpenAIなど複数のプロバイダー用の初期設定ファイル models.yaml が作成されます。ただし、何かを有効化しない限り実際には何も動作しません。
2. モデルの配置場所を指定する
models.yaml を開いてください。プロバイダーの項目にサーバーの場所が記載され、モデル項目にはそのサーバー上にある特定のモデル名が記載されています。ローカルサーバーの場合は以下の通りです。
providers:
  mylocal:
    type: openai
    base_url: http://localhost:8080/v1   # your llama.cpp / LM Studio / StudioForge address

models:
  - name: my-model
    provider: mylocal
    model_id: the-id-your-server-reports
    context_length: 32768
サーバーが提供可能なモデルIDを確認したい場合は、次のコマンドを実行してください。
uv run crucibleforge models discover mylocal3. 設定内容を確認する
uv run crucibleforge statusこのコマンドにより、各プロバイダーが「UP」または「DOWN」の状態か、認証キーが設定済みかどうか、利用可能なモデル、判定用プログラム、およびテストケース数が一覧表示されます。続行する前に「DOWN」や「NOT SET」と表示されている項目を修正してください。
4. 計画策定とスモークテスト
実行コマンドに --plan を付与すると、実際には何も実行されません。代わりに実行予定の処理内容や所要時間の見積もりが出力されます。
uv run crucibleforge all --models my-model --judge mylocal:my-judge --plan
uv run crucibleforge all --smoke --models my-model --judge mylocal:my-judge --yes
スモークテストでは、タグ付けされたごく一部のケースのみを対象に生成・判定・レポート作成が行われます。これにより設定が正しく機能しているか確認できます。ホスト型モデルを使った私たちのテストでは2分未満で完了し、費用は約2セント程度でした。ただし、全33ケースのうちごく一部しか対象としないため、スコアとしては扱えません。レポート上では「Total」値やランクも記載されず、モデルは「Partial」状態と判定されます。
5. レポートの確認方法
ブラウザで results/report.html を開くか、results/report.md を閲覧してください。同じディレクトリには failures.md、report.json もあり、各モデルが受け取ったプロンプトと生成結果の記録も保存されています。完全なテスト実行は --smoke を付与しない同じコマンドで行えますが、高速なGPU環境でもローカルモデル1つあたり25〜30分程度かかります。GUI版も用意されており、uv run crucibleforge gui を実行すると表示されるアドレスにアクセスできます。初期設定では自身のマシン内からのみ接続可能となっています。
バックエンドまたはAPIの接続方法
CrucibleForgeにはモデルが内蔵されていません。これは単なるクライアントです。必要な情報はすべて models.yaml に記載されており、プロバイダー、モデル、そして判定用モデルの3つの要素から成ります。
ローカルサーバー
type: openai を指定し、サーバーのアドレスを入力します。一般的なアドレス例は以下の通りです:
- llama.cppの
llama-server:http://127.0.0.1:8080/v1 - LM Studio:
http://localhost:1234/v1 - Ollama:
http://localhost:11434/v1 - vLLM:
http://localhost:8000/v1 - StudioForge:ポート1234上のゲートウェイ
/v1(コントロールパネル用ポートではありません)。CrucibleForgeにGPUを利用させ、サーバーのプランナー経由でモデルを読み込ませたい場合はtype: studioforgeを指定してください。
もしサーバー側でキーの入力が求められたら、環境変数名として api_key_env を設定してください。ただし実際のキー自体はファイル内に記載してはいけません。
ホスティング型API
providers:
  deepseek:
    type: openai
    base_url: https://api.deepseek.com/v1
    api_key_env: DEEPSEEK_API_KEY
    concurrency: 8

models:
  - name: deepseek-flash
    provider: deepseek
    model_id: deepseek-flash
    context_length: 131072
export DEEPSEEK_API_KEY=... # your own key, set in your shell
uv run crucibleforge status初期設定用ファイルにはすでにDeepSeek、OpenAI、OpenRouterなどのエントリが含まれています。Claudeも直接利用可能です。Anthropic社はOpenAI互換のエンドポイントを提供しているため、type: openai および base_url: https://api.anthropic.com/v1 を指定し、自身のAnthropic用キーを用意すれば利用できます。OpenAIスタイルのエンドポイントを持たないサービスも、ほとんどはOpenRouter経由で接続可能です。
ホスティング型サービスの利用には実際に費用が発生しますので、まず --plan を使って簡易テストを行うことをお勧めします。ホスティング型モデルには price として1百万トークンあたりの利用料金(単位:ドル)を設定してください。そうするとレポート内に Run cost という列が現れ、その料金に基づいて標準的なコード・チャットテストを一回実行した際の費用が算出されます。定額プランの場合はトークン数に応じた課金は発生しないため、価格設定欄内に basis: list と記載すれば、リスト価格を基準とした概算値として「〜」マークが付きます。自身のPC上で動作するモデルにはダッシュ記号が表示されます。もしホスティング型モデルに料金設定がなければCrucibleForgeは警告を出して起動を拒否します。
一部のプロバイダーではコンテンツフィルターが働き、応答内容がブロックされる場合もあります。CrucibleForgeは各レポート内でそのような事例を記録し、該当行に「blocked」という数値と備考を付加するとともに、ブロックされた応答のスコアはゼロとして処理します。この機能を有効化するための操作は一切不要です。
判定用モデル
チャットテストには判定用モデルが必要で、そのモデルはテスト対象のモデルとは別物でなければなりません。ローカルサーバー上にある別モデルやホスティング型のモデルでも構いません。--judge provider:model_id を実行時オプションとして渡すか、models.yaml 内の judge: 欄に候補モデルを列挙してください。以下の2点にご留意ください:
- 判定用モデルによってチャットスコアが変わる。MakoBenchの集計表と数値を一致させるためには同一の判定用モデルを使う必要があります。コードテストではどちらのモデルを使用しても問題ありません。なぜならこのテストは実際にプログラムを動かして採点するからです。
- 多くのホスティング型判定用モデルは成人向けコンテンツを拒否または緩和する。校正チェックでその事象が検知されます。それ以外のチャットテスト項目の採点は通常通り行われ、NSFW関連の行については「unjudged」という状態のまま保留となります。後から適切な判定用モデルを用いて手動で評価する必要があります。
さらに詳しく
crucibleforge conform --models my-modelと入力すると、7つのセットアップチェックが個別に実行されます。crucibleforge cases verifyは自己テストとして、すべての正解データをオフラインで再生成します。crucibleforge reportは保存済みの結果からレポートを再作成します。- 実行結果は
results/フォルダ内に保存され、models.yamlと同じ場所にあるため、すべてご自身のPC上に残ります。
READMEにはDockerを使う方法やバックグラウンド実行の仕方、独自テストを非公開にする手順、テストケースの追加方法などが記載されています。単に数値結果だけが必要な場合はどうすればよいでしょうか? MakoBenchのページには私たちが既に実行したモデルに関する結果が掲載されており、こちらからご自身のモデルの実行を依頼することも可能です。スコアの見方について詳しく知りたい場合は MakoBenchの仕組みをご覧ください。また、実際の出力例付きのインストール手順が知りたい方は CrucibleForgeを自分のモデルで動かす方法を参照してください。