Cómo funciona CrucibleForge: una explicación sobre este benchmark abierto para LLM.
- Categoría
- IA y LLM Local
- Publicado
- 7 noviembre 2026
- Por
- Jacob Lloyd — escrito con ayuda de IA, después del proyecto
- Tiempo de lectura
- 13 min de lectura
En palabras simples: CrucibleForge es una herramienta gratuita que evalúa a un modelo de lenguaje en cuanto a su capacidad para escribir código y mantener una conversación; posteriormente le asigna una puntuación. Funciona tanto con un modelo instalado en su propio ordenador como con uno al que se accede mediante la API de una empresa. Esta página explica los cinco pasos que realiza el proceso, qué tipos de pruebas se aplican, quién realiza la calificación y cómo ejecutarlo usted mismo con unos cuantos comandos.
CrucibleForge es un sistema de evaluación de código abierto para modelos de lenguaje. Se le indica el modelo que se desea probar; luego ejecuta un conjunto fijo de pruebas, califica las respuestas y genera un informe. MakoBench es nuestro tablero público de resultados; todas las cifras que allí aparecen provienen de esta herramienta. Puede utilizarla también con sus propios modelos. Es gratuita y cuenta con licencia MIT-0, por lo que no hay restricciones para su uso.
En resumen:
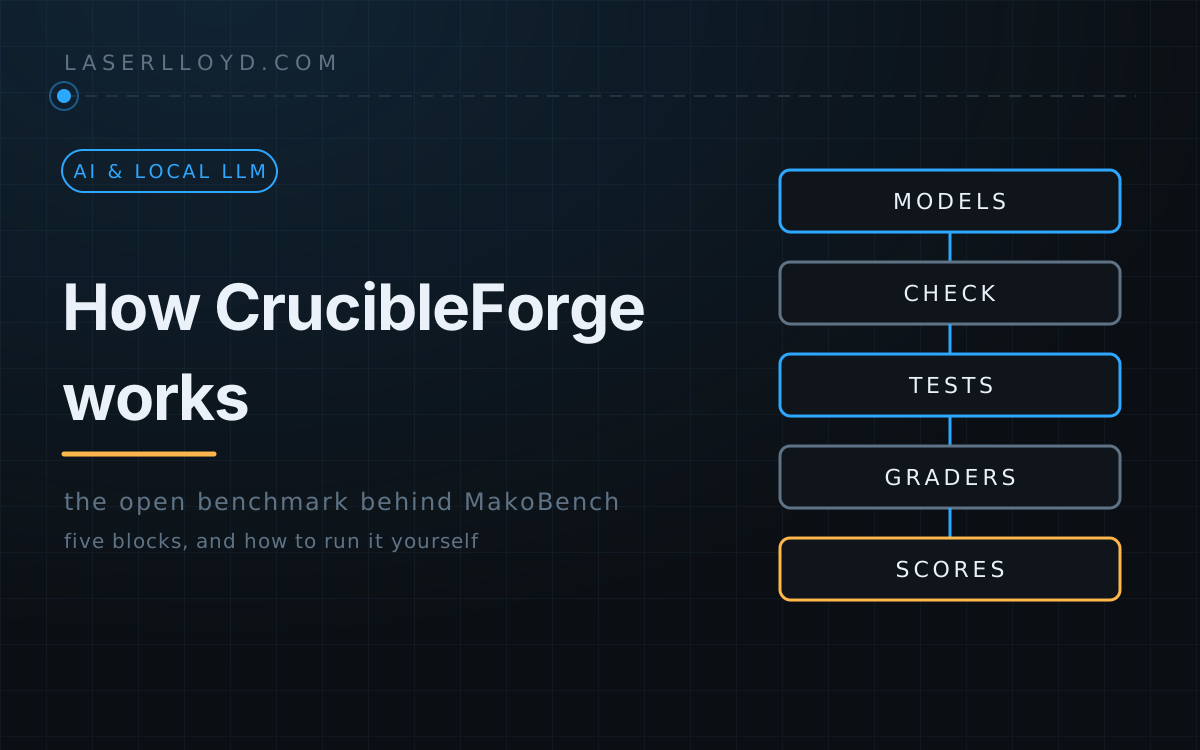
- Cinco componentes principales: el modelo, una verificación de configuración, las pruebas, los evaluadores y las puntuaciones.
- El código se califica ejecutándolo; el chat se califica mediante un modelo juez que responde a una lista de preguntas de tipo sí/no.
- La puntuación total es la suma de las puntuaciones del código y del chat. Las pruebas inapropiadas se califican por separado y nunca se incluyen en el total.
- Funciona con cualquier endpoint compatible con OpenAI. Ya sea un servidor local o una API alojada; solo es necesario indicar la clave mediante una variable de entorno.
- Puede ponerlo en marcha en unos diez minutos. La máquina donde se ejecuta no requiere GPU alguna.
Los cinco bloques
Esta es toda la herramienta, tal como debe usarse. Cada bloque realiza una tarea y entrega su resultado al siguiente.

- Sus modelos. CrucibleForge se comunica con cualquier modelo que siga el formato de chat de OpenAI. Esto incluye tanto servidores locales como APIs alojadas por empresas.
- Verificación de conformidad. Cada proveedor requiere solicitudes ligeramente distintas. Antes de evaluar un modelo, siete llamadas sencillas demuestran que el sistema se comunica correctamente con él: se obtiene el ID del modelo, el razonamiento llega donde debe, cierta información persiste entre turnos, las llamadas a herramientas funcionan, los parámetros de muestreo son aceptados, un prompt de codificación mediano cabe dentro del límite de tokens, y para proveedores alojados se verifica que la documentación haya sido revisada en los últimos 120 días. Si esta verificación falla, el modelo no se ejecuta, ya que una puntuación basada en solicitudes incorrectas reflejaría errores del sistema y no del propio modelo.
- Ejecutor de pruebas. Envía los casos de prueba al modelo, en paralelo según lo permita el servidor, y registra cada prompt y respuesta.
- Correctores. Cada respuesta es evaluada mediante el método adecuado. Consulte la sección siguiente para más detalles.
- Puntuaciones y resultados. Las calificaciones se agrupan en Codificación, Chat y Total, cada una con su margen correspondiente; luego la herramienta genera un informe. En nuestro caso, ese informe alimenta el tablero MakoBench; en el suyo, se obtiene un archivo report.html que puede abrirse en cualquier navegador.
Las pruebas, en términos sencillos
La puntuación total consta de dos partes; cada una vale 10 puntos por completar perfectamente las pruebas estándar. La suma de ambas da el total, que es 20 puntos. Se desbloquean paquetes adicionales con preguntas más difíciles cuando un modelo obtiene al menos el 90 % de aciertos en una de las partes; esa es la única forma de superar los 10 puntos. Cada versión de las pruebas tiene un máximo fijo; al añadir nuevos paquetes, ese límite aumenta.
Código: ¿puede escribir y razonar sobre programas?
- Funciones (5 puntos). Escribir una función en Python a partir de una descripción. Se ejecutan pruebas ocultas en un entorno aislado. La puntuación parcial corresponde al porcentaje de grupos de pruebas que se superan.
- Predicción y detección de errores (2,5 puntos). Indicar exactamente qué imprime un programa corto; luego encontrar y corregir un error en un proyecto pequeño. Las respuestas se comparan textualmente o se verifican ejecutando la corrección.
- Uso de herramientas (2,5 puntos). Conversaciones preprogramadas en las que el modelo debe invocar correctamente las herramientas disponibles; incluyen trampas como usar una herramienta equivocada o proporcionar argumentos incorrectos.
Nada de esto requiere opinión subjetiva. El código se ejecuta, y simplemente pasa o no pasa las pruebas.
Chat: ¿es un buen compañero en una historia?
- Juego de roles profundo (3 puntos). Sesiones largas y cargadas de trasfondo narrativo. ¿Recuerda el modelo un dato introducido previamente, acepta una corrección y mantiene el punto de vista del personaje?
- Conversación (3 puntos). Un diálogo cotidiano que debe permanecer coherente a lo largo de muchos turnos.
- Personajes (2 puntos). Un único personaje con varias voces y hábitos distintos.
- Escritura creativa (2 puntos). Crear una historia en colaboración, respetando restricciones como la longitud, el tiempo verbal o elementos que deben o no aparecer.
La sección de Chat evalúa el juego de roles y la capacidad de conversar como compañero. No puntúa la simple resolución de preguntas; por eso debe interpretarse como medida de lo bien que un modelo funciona dentro de una historia, no como medida de lo útil que es como asistente.
NSFW: separado a propósito
Algunos modelos están diseñados para ficción para adultos, y hay personas que buscan exactamente eso; por ello existe un grupo de pruebas dedicado. Este grupo genera su propia puntuación (puntuación NSFW) y nunca se suma al total. Todos los personajes en dichas pruebas son adultos. Un número más alto simplemente indica que el modelo va más lejos en ese tipo de contenido. Si eso resulta útil o no depende del propósito que se le dé.
Cómo funciona la calificación del Chat
Como las respuestas de Chat no pueden ejecutarse, un modelo juez las analiza. No otorga una nota libre; cada caso incluye una lista de preguntas tipo sí/no, por ejemplo: “¿el personaje mantuvo la primera persona?”. Para cada una, el juez responde sí o no y cita la línea que lo demuestra. Si la respuesta es “sí” pero no hay cita en la respuesta, se cuenta como “no”. También se aplican reglas textuales, como conteos y frases prohibidas.
Dos mecanismos garantizan la honestidad del juez: cada pregunta debe referirse a una sola cosa; además, antes de utilizarlo se realiza un control de calibración para asegurar que el juez cumpla su función sin negarse o suavizar los resultados.
Márgenes y empates
Cada puntuación incluye un margen ± calculado mediante bootstrap sobre los casos de prueba. Dos modelos cuyas puntuaciones estén dentro de dicho margen se consideran empatados, independientemente del orden en que aparezcan en la tabla. Las comparaciones solo se realizan dentro de una misma versión del conjunto de pruebas; el informe indica esa versión en cada fila.
Ejecútelo usted mismo en diez minutos
Se necesitan tres cosas: un modelo para probar detrás de un endpoint similar al de OpenAI, un “juez” y una máquina con uv instalado. La máquina no requiere GPU, por lo que puede ejecutarse desde un portátil contra una API alojada. En Linux, las respuestas generadas se ejecutan dentro de bwrap (bubblewrap). En Windows y macOS no existe este entorno; por eso use la imagen de Docker indicada en el README o añada --allow-unsandboxed antes del subcomando, asumiendo que el código generado por el modelo se ejecutará con sus mismos privilegios.
1. Instalación
git clone https://github.com/LaserLloyd/CrucibleForge.git
cd CrucibleForge
uv sync --python 3.13
uv run crucibleforge config --init
El último comando genera un archivo inicial models.yaml que incluye proveedores para LM Studio, Ollama, llama.cpp o cualquier servidor local, DeepSeek, OpenRouter, OpenAI y algunos más. Nada se ejecuta hasta que active algún proveedor.
2. Indique dónde se encuentra su modelo
Abra models.yaml. Un proveedor indica la ubicación del servidor, y una entrada de modelo nombra uno específico en dicho servidor. Para un servidor local:
providers:
  mylocal:
    type: openai
    base_url: http://localhost:8080/v1   # your llama.cpp / LM Studio / StudioForge address

models:
  - name: my-model
    provider: mylocal
    model_id: the-id-your-server-reports
    context_length: 32768
Para ver los identificadores que ofrece un servidor, pregúntele así:
uv run crucibleforge models discover mylocal3. Compruebe la configuración
uv run crucibleforge statusEsta salida muestra cada proveedor como ACTIVO o INACTIVO, si su clave está configurada, sus modelos, el “juez” y el número de casos. Corrija cualquier elemento marcado como INACTIVO o NO CONFIGURADO antes de continuar.
4. Planifique y luego haga una prueba preliminar
Añada --plan a cualquier comando de ejecución; así no se llamará a nada. El programa imprimirá lo que se ejecutaría y una estimación del tiempo necesario.
uv run crucibleforge all --models my-model --judge mylocal:my-judge --plan
uv run crucibleforge all --smoke --models my-model --judge mylocal:my-judge --yes
La prueba preliminar abarca un pequeño subconjunto etiquetado, desde la generación hasta la evaluación y el informe final. Demuestra que su configuración funciona correctamente. En nuestra prueba con un modelo alojado, tardó menos de dos minutos y costó unos dos centavos. Esta prueba no genera una puntuación definitiva, ya que cubre solo algunos de los 33 casos posibles; el informe indica que el modelo obtuvo resultados parciales, sin un total ni un rango de clasificación.
5. Lea el informe
Abra results/report.html en un navegador, o lea results/report.md. Junto a ellos encontrará failures.md, report.json y un registro detallado de cada prompt y respuesta generada por el modelo. Una ejecución completa, es decir, el mismo comando sin --smoke, tarda aproximadamente entre 25 y 30 minutos por modelo local en una GPU rápida, incluyendo la fase de evaluación. Para una versión gráfica tipo “apuntar y hacer clic”, ejecute uv run crucibleforge gui y abra la dirección que aparece; por defecto, este servicio escucha únicamente en su propia máquina.
Conexión a un backend o API
CrucibleForge no contiene ningún modelo en su interior; es simplemente un cliente. Todo lo que necesita se encuentra en models.yaml, dividido en tres partes: un proveedor, un modelo y un juez.
Servidor local
Utilice type: openai junto con la dirección del servidor. Algunas direcciones típicas son:
- El servidor de llama.cpp:
llama-server; dirección:http://127.0.0.1:8080/v1 - LM Studio:
http://localhost:1234/v1 - Ollama:
http://localhost:11434/v1 - vLLM:
http://localhost:8000/v1 - StudioForge: su puerta de enlace en el puerto 1234,
/v1(no el puerto del panel de control). Utilicetype: studioforgesi desea que CrucibleForge reserve una GPU y cargue los modelos mediante el planificador del servidor.
Si el servidor solicita una clave, asigne el nombre de la variable de entorno como api_key_env. No pegue la clave directamente en el archivo.
API alojada
providers:
  deepseek:
    type: openai
    base_url: https://api.deepseek.com/v1
    api_key_env: DEEPSEEK_API_KEY
    concurrency: 8

models:
  - name: deepseek-flash
    provider: deepseek
    model_id: deepseek-flash
    context_length: 131072
export DEEPSEEK_API_KEY=... # your own key, set in your shell
uv run crucibleforge statusEl archivo de inicio ya incluye entradas para DeepSeek, OpenAI, OpenRouter y otros. Claude también funciona directamente: Anthropic dispone de un endpoint compatible con OpenAI; por lo tanto, basta con configurar un proveedor con type: openai, base_url: https://api.anthropic.com/v1 y su clave de Anthropic. Los proveedores que no cuentan con un endpoint estilo OpenAI normalmente se pueden acceder mediante OpenRouter. Las ejecuciones en servidores alojados tienen un costo real; por eso, utilice primero --plan para realizar una prueba preliminar. Asigne a cada modelo alojado un valor de price (dólares por millón de tokens entrantes y salientes); el informe mostrará entonces una columna llamada Costo de ejecución: cuánto cuesta realizar una ejecución de las pruebas estándar de Código y Chat a ese precio, considerando únicamente la generación de texto. En los planes fijos no hay cobro por tokens; en tal caso, escriba basis: list dentro del bloque de precios; el costo se indicará con un ~ como estimación basada en el conteo de tokens al precio estándar. Para los modelos que se ejecutan en su propio hardware, aparece un guion. CrucibleForge advierte y se niega a iniciarse si un modelo alojado no tiene precio definido.
Algunos proveedores aplican filtros de contenido que pueden bloquear ciertas respuestas. CrucibleForge registra dichos casos en las transcripciones de cada informe, marca la fila con un contador “bloqueado” y una nota, y asigna una puntuación de cero a esas respuestas bloqueadas. No es necesario realizar ninguna configuración adicional para activar esta función.
El juez
Para las pruebas de Chat se requiere un juez, y este no debe ser el modelo que se está evaluando. Puede tratarse de un segundo modelo en su servidor local o de uno alojado. Para especificarlo, utilice --judge provider:model_id en cada ejecución, o bien liste los candidatos bajo judge: en el archivo models.yaml. Hay dos cosas importantes que debe saber:
- El juez influye en las puntuaciones de Chat. Sus resultados solo coincidirán con los de la tabla MakoBench si utiliza el mismo juez. En cambio, las pruebas de Código se puntúan independientemente, ya que se evalúan mediante ejecución directa.
- La mayoría de los jueces alojados rechazan o suavizan el texto para adultos. Esto se detecta en la comprobación de calibración. El resto de las respuestas de Chat sí se puntúan; sin embargo, las filas correspondientes a contenido NSFW quedan marcadas como “sin juzgar” hasta que utilice un modelo capaz de evaluarlas.
Para ir más allá
crucibleforge conform --models my-modelejecuta por sí solo las siete comprobaciones de configuración.crucibleforge cases verifyvuelve a generar todas las respuestas correctas de forma offline, como una prueba automática.crucibleforge reportreconstruye el informe a partir de los resultados almacenados.- Los resultados se guardan en
results/, junto a su archivomodels.yaml; por lo tanto, permanecen en su máquina.
En el README encontrará la guía para usar Docker, cómo ejecutar procesos de forma independiente, cómo mantener privadas sus pruebas personalizadas y cómo añadir nuevos casos de prueba. ¿Solo le interesan las cifras? El tablero de MakoBench muestra los resultados de los modelos que ya hemos probado; además, puede solicitarnos que probemos el suyo. Para conocer en detalle cómo interpretar las puntuaciones, consulte Cómo funciona MakoBench. Si desea una guía paso a paso con ejemplos reales de salida, vea Ejecutar CrucibleForge con sus propios modelos.