Wie CrucibleForge funktioniert: Ein offener LLM-Benchmark, erklärt
- Kategorie
- KI & lokale LLMs
- Veröffentlicht
- 7 November 2026
- Von
- Jacob Lloyd — mit KI-Unterstützung geschrieben, im Nachhinein
- Lesezeit
- 11 Min. Lesezeit
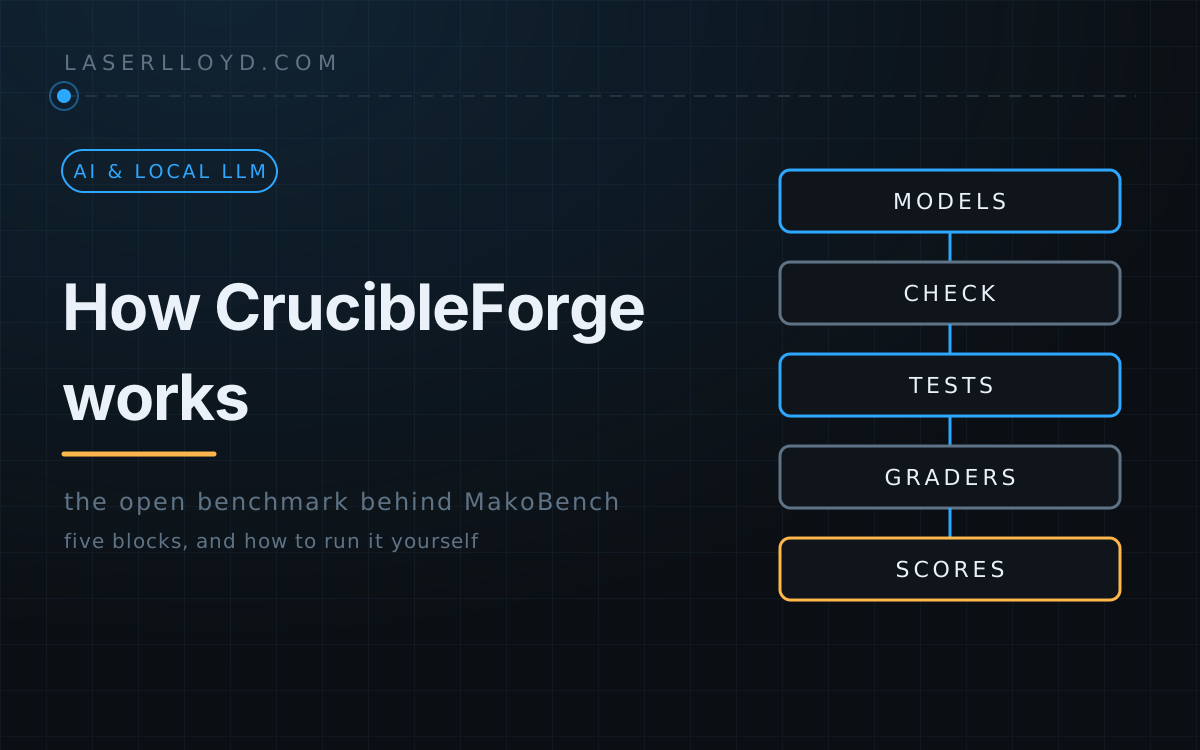
Kurz gesagt: CrucibleForge ist ein kostenloses Tool, das ein Sprachmodell darauf prüft, ob es Code schreiben und Konversationen führen kann – anschließend vergibt es eine Bewertung. Es funktioniert mit einem Modell auf Ihrem eigenen Computer oder mit einem Modell, auf das Sie über die API eines Unternehmens zugreifen können. Diese Seite erklärt die fünf Schritte, die durchlaufen werden, welche Tests durchgeführt werden, wer die Bewertung vornimmt sowie wie Sie es selbst mit ein paar Befehlen ausführen können.
CrucibleForge ist ein open-source-Benchmark-Tool für Sprachmodelle. Man gibt ein Modell an, das Tool führt eine festgelegte Reihe von Tests durch, bewertet die Antworten und erstellt einen Bericht. MakoBench ist unsere öffentliche Bewertungsplattform – jede Zahl dort stammt aus diesem Tool. Sie können das gleiche Tool auch mit Ihren eigenen Modellen verwenden. Es ist kostenlos und unter der MIT-0-Lizenz verfügbar; es gibt also keine Nutzungsbedingungen.
Zusammenfassung
- Fünf Komponenten: Ihr Modell, eine Setup-Prüfung, die Tests, die Bewertungsmechanismen sowie die Ergebnisse.
- Code wird durch Ausführung bewertet; bei Chat-Antworten kommt ein Bewertungsmodell zum Einsatz, das auf einer Ja/Nein-Checkliste basiert.
- Das Gesamtergebnis setzt sich aus Code- und Chat-Bewertungen zusammen. NSFW-Tests werden separat bewertet und fließen nie in das Gesamtergebnis ein.
- Kompatibel mit jedem OpenAI-ähnlichen Endpunkt: Egal ob lokaler Server oder gehostete API – sofern der API-Schlüssel als Umgebungsvariable hinterlegt ist.
- In etwa zehn Minuten können Sie loslegen: Für die Ausführung wird keine GPU benötigt.
Die fünf Blöcke
Dies ist das gesamte Tool – auf der Ebene, auf der Sie es nutzen müssen. Jeder Block übernimmt eine bestimmte Aufgabe und gibt das Ergebnis an den nächsten Block weiter.

- Ihre Modelle. CrucibleForge kommuniziert mit allen Modellen, die das OpenAI-Chat-Format verstehen – egal ob es sich um einen lokalen Server oder eine gehostete API handelt.
- Konformitätsprüfung. Verschiedene Anbieter erwarten leicht unterschiedliche Anfragen. Vor dem Testlauf prüft CrucibleForge mittels sieben einfachen Aufrufen, ob die Schnittstelle korrekt mit dem Modell kommuniziert: Die Modell-ID wird korrekt übergeben, das Reasoning kommt am richtigen Ort an, Informationen bleiben über mehrere Interaktionen hinweg erhalten, Tool-Aufrufe funktionieren einwandfrei, die Sampler-Einstellungen werden akzeptiert, ein mittellanger Coding-Prompt passt ins Token-Budget – bei gehosteten APIs wird zudem geprüft, ob die offiziellen Dokumentationen in den letzten 120 Tagen aktualisiert wurden. Bei Fehlern wird das Modell nicht getestet, da ein fehlerhaftes Ergebnis eher die Schnittstelle als das Modell bewerten würde.
- Testläufer. Dieser sendet alle Testfälle an das Modell – parallel, sofern der Server dies zulässt – und protokolliert jede Anfrage sowie Antwort.
- Bewertungsmodule. Jede Antwort wird gemäß ihrem Typ bewertet. Weitere Details dazu finden Sie im nächsten Abschnitt.
- Ergebnisse und Ausgabe. Die Einzelbewertungen werden zu den Kategorien Code, Chat sowie dem Gesamtscore zusammengefasst; jeder Score enthält eine Toleranzgrenze. Anschließend erstellt das Tool einen Bericht. Auf unserer Seite wird dieser Bericht im MakoBench-Board angezeigt; bei Ihnen erhalten Sie eine report.html-Datei, die Sie im Browser öffnen können.
Die Tests – in einfachen Worten
Die Gesamtpunktzahl setzt sich aus zwei Teilen zusammen; jeweils zehn Punkte gibt es für eine perfekte Ausführung der Standardtests. Insgesamt ergibt das 20 Punkte. Zusätzliche, schwierigere Aufgaben werden freigeschaltet, wenn ein Modell in einem Teilbereich mindestens 90 % erreicht – das ist die einzige Möglichkeit, über 10 Punkte zu kommen. Jede Testversion hat eine feste Höchstpunktzahl; neue Aufgabenpakete erhöhen diese.
Code: Kann das Modell Programme schreiben und darüber nachdenken?
- Funktionen (5 Punkte). Schreiben Sie eine Python-Funktion anhand einer Beschreibung. Versteckte Unit-Tests werden in einer Sandbox ausgeführt. Teilpunkte erhält man für die Anzahl der erfolgreich bestandenen Testgruppen.
- Vorhersage und Fehlersuche (2,5 Punkte). Bestimmen Sie exakt, was ein kurzes Programm ausgibt, und finden Sie anschließend sowie beheben Sie einen Fehler in einem kleinen Projekt. Die Antworten werden entweder direkt verglichen oder durch Ausführung der Korrektur überprüft.
- Werkzeugeinsatz (2,5 Punkte). In vorgegebenen Gesprächsszenarien muss das Modell Werkzeuge korrekt aufrufen; dabei gibt es Fallstricke wie falsche Werkzeuge oder ungültige Argumente.
Für all dies ist keine Meinung erforderlich – der Code läuft, und er besteht die Tests oder eben nicht.
Chat: Ist das Modell ein guter Gesprächspartner in einer Geschichte?
- Tiefgehendes Rollenspiel (3 Punkte). Lange, detailreiche Szenarien. Merkt sich das Modell zuvor eingeführte Fakten, akzeptiert es Korrekturen und behält dabei die Perspektive der Figur bei?
- Gesprächsfähigkeit (3 Punkte). Ein alltäglicher Dialog, bei dem das Modell über viele Runden hinweg konsistent bleiben muss.
- Charaktergestaltung (2 Punkte). Eine Figur mit mehreren Stimmen und Eigenheiten.
- Kreatives Schreiben (2 Punkte). Gemeinsames Verfassen einer Geschichte unter festgelegten Einschränkungen – etwa hinsichtlich Länge, Zeitform sowie Inhalten, die enthalten oder ausgelassen werden müssen.
Der Chat-Test misst Rollenspiele sowie alltägliche Gespräche. Er bewertet jedoch nicht das bloße Beantworten von Fragen; lesen Sie ihn daher als Maß dafür, wie gut ein Modell in Geschichten funktioniert – nicht als Maß für seine Qualität als Assistent.
NSFW: Absichtlich getrennt
Manche Modelle sind speziell für erotische Inhalte entwickelt; manche Nutzer wünschen sich genau das. Deswegen gibt es dafür eigene Tests. Sie erhalten eine separate Bewertung (NSFW-Score), die nie zur Gesamtpunktzahl hinzugerechnet wird. Alle Figuren in diesen Tests sind Erwachsene. Eine höhere Zahl bedeutet lediglich, dass das Modell weitergehende Inhalte erzeugt – ob das für Ihre Zwecke nützlich ist, hängt vom Anwendungsfall ab.
Wie die Bewertung im Chat-Test funktioniert
Chat-Antworten können nicht ausgeführt werden; daher liest ein Bewertungsmodell sie. Es vergibt keine frei formulierte Bewertung. Jeder Testfall enthält eine Checkliste mit Ja/Nein-Fragen – etwa „Blieb die Figur in der ersten Person?“ Für jede Frage antwortet das Bewertungsmodell mit Ja oder Nein und zitiert den entsprechenden Textabschnitt. Ein „Ja“, für das kein passender Zitatnachweis vorhanden ist, zählt als „Nein“. Zusätzlich gelten textbasierte Regeln – etwa zur Wortanzahl oder zu verbotenen Ausdrücken.
Zwei Mechanismen sorgen dafür, dass das Bewertungsmodell ehrlich bleibt: Jede Checklistenfrage muss exakt eine Sache abfragen. Vor der eigentlichen Nutzung erfolgt außerdem eine Kalibrierungsprüfung, um sicherzustellen, dass das Modell die Aufgabe korrekt ausführt – ohne sie stillschweigend zu ignorieren oder abzuschwächen.
Toleranzgrenzen und Unentschiedenheiten
Jede Punktzahl weist eine ±-Toleranz auf, die durch Bootstrap-Verfahren aus den Testfällen ermittelt wird. Zwei Modelle, deren Punktzahlen innerhalb dieser Grenzen liegen, gelten als gleichwertig – unabhängig von der Reihenfolge in der Tabelle. Vergleiche erfolgen stets nur innerhalb einer bestimmten Testversion; diese ist in jeder Zeile des Berichts vermerkt.
Führen Sie es selbst in zehn Minuten aus
Sie benötigen drei Dinge: ein Modell, das hinter einem OpenAI-ähnlichen Endpunkt getestet werden soll, einen Bewertungsmechanismus sowie einen Rechner mit installiertem uv. Der Rechner benötigt keine GPU – Sie können das Ganze also auch von einem Laptop aus gegen eine gehostete API ausführen. Unter Linux werden die generierten Programme innerhalb von bwrap (Bubblewrap) ausgeführt. Unter Windows und macOS gibt es diese Umgebung nicht; daher müssen Sie entweder das Docker-Image aus der README verwenden oder --allow-unsandboxed vor dem Subbefehl angeben – in diesem Fall wird der vom Modell generierte Code direkt ausgeführt.
1. Installation
git clone https://github.com/LaserLloyd/CrucibleForge.git
cd CrucibleForge
uv sync --python 3.13
uv run crucibleforge config --init
Der letzte Befehl erstellt eine Starter-Datei models.yaml, in der Anbieter wie LM Studio, Ollama, llama.cpp, DeepSeek, OpenRouter, OpenAI und weitere aufgelistet sind. Zunächst wird jedoch nichts ausgeführt – erst nach Aktivierung eines Anbieters beginnt die Ausführung.
2. Geben Sie an, wo Ihr Modell liegt
Öffnen Sie models.yaml. Ein Anbieter gibt dabei an, wo sich der Server befindet; ein Modell-Eintrag nennt anschließend das jeweilige Modell auf diesem Server. Bei einem lokalen Server sieht das so aus:
providers:
  mylocal:
    type: openai
    base_url: http://localhost:8080/v1   # your llama.cpp / LM Studio / StudioForge address

models:
  - name: my-model
    provider: mylocal
    model_id: the-id-your-server-reports
    context_length: 32768
Um die verfügbaren Modell-IDs eines Servers zu erkennen, fragen Sie ihn einfach ab:
uv run crucibleforge models discover mylocal3. Überprüfen Sie die Einrichtung
uv run crucibleforge statusDieser Befehl listet alle Anbieter als „UP“ oder „DOWN“ auf, zeigt an, ob der entsprechende Schlüssel gesetzt ist, welche Modelle verfügbar sind sowie die Anzahl der zu testenden Fälle. Beheben Sie bitte alle Einträge, die als „DOWN“ oder „NOT SET“ gekennzeichnet sind, bevor Sie fortfahren.
4. Planung und Testlauf
Fügen Sie --plan zu jedem Befehl hinzu – dann wird zwar nichts ausgeführt, aber es wird angezeigt, was passieren würde sowie eine Schätzung dazu.
uv run crucibleforge all --models my-model --judge mylocal:my-judge --plan
uv run crucibleforge all --smoke --models my-model --judge mylocal:my-judge --yes
Der Testlauf umfasst einen kleinen, vordefinierten Teil der Gesamtmenge an Tests: Generierung, Bewertung und Erstellung des Berichts. Er beweist, dass Ihre Einrichtung funktioniert. Bei einem gehosteten Modell dauerte dieser Testlauf in unserem Test weniger als zwei Minuten – die Kosten beliefen sich dabei auf etwa zwei Cent. Ein Testlauf liefert jedoch keine Gesamtpunktzahl; er umfasst lediglich einen kleinen Teil der insgesamt 33 zu testenden Fälle. Der Bericht kennzeichnet das Modell daher als „teilweise getestet“ – ohne Gesamtpunktzahl und Rang.
5. Lesen Sie den Bericht
Öffnen Sie results/report.html im Browser oder lesen Sie results/report.md. Daneben finden Sie noch failures.md, report.json sowie eine Aufzeichnung aller Prompts und Antworten jedes Modells. Ein vollständiger Testlauf – also derselbe Befehl ohne --smoke – dauert bei einem lokalen Modell auf einer leistungsstarken GPU inklusive Bewertung etwa 25 bis 30 Minuten. Für eine grafische Oberfläche führen Sie uv run crucibleforge gui aus und öffnen anschließend die angegebene Adresse – standardmäßig hört der Dienst nur auf Ihrem eigenen Rechner zu.
Verbindung zu einem Backend oder einer API
CrucibleForge enthält kein Modell – es handelt sich dabei um einen Client. Alles, was es benötigt, befindet sich in models.yaml; dazu gehören ein Provider, ein Modell sowie ein Bewertungsmodell.
Lokaler Server
Verwenden Sie type: openai sowie die Adresse des Servers. Typische Adressen sind:
- llama.cpp’s
llama-server:http://127.0.0.1:8080/v1 - LM Studio:
http://localhost:1234/v1 - Ollama:
http://localhost:11434/v1 - vLLM:
http://localhost:8000/v1 - StudioForge: dessen Gateway auf Port 1234,
/v1(nicht der Port des Kontrollpanels). Verwenden Sietype: studioforge, wenn CrucibleForge eine GPU anmieten und Modelle über den Server laden soll.
Falls der Server nach einem Schlüssel fragt, benennen Sie die Umgebungsvariable mit api_key_env. Geben Sie den Schlüssel dabei nicht direkt in die Datei ein.
Gehostete API
providers:
  deepseek:
    type: openai
    base_url: https://api.deepseek.com/v1
    api_key_env: DEEPSEEK_API_KEY
    concurrency: 8

models:
  - name: deepseek-flash
    provider: deepseek
    model_id: deepseek-flash
    context_length: 131072
export DEEPSEEK_API_KEY=... # your own key, set in your shell
uv run crucibleforge statusDie Startdatei enthält bereits Einträge für DeepSeek, OpenAI, OpenRouter und andere. Auch Claude funktioniert direkt: Anthropic stellt ein OpenAI-kompatibles Endpunkt bereit; daher genügt ein Provider mit type: openai, base_url: https://api.anthropic.com/v1 sowie Ihrem Anthropic-Schlüssel. Anbieter ohne OpenAI-ähnlichen Endpunkt lassen sich meist über OpenRouter erreichen. Gehostete Ausführungen kosten Geld – daher sollten Sie zuerst --plan verwenden und einen Testlauf durchführen. Geben Sie für ein gehostetes Modell einen price-Wert an (Dollar pro Million eingehender/ausgehender Tokens); im Bericht erscheint dann eine Spalte „Run cost“ – also die Kosten für einen Standardlauf der Code- und Chat-Tests. Bei einem Flat-Plan gibt es keine Abrechnung pro Token; in diesem Fall schreiben Sie basis: list in den Preisblock – die Kosten werden dann als Schätzung basierend auf dem Listenpreis angegeben. Bei einem Modell auf Ihrer eigenen Hardware wird ein Bindestrich angezeigt. CrucibleForge warnt und startet nicht, falls für ein gehostetes Modell kein Preis angegeben ist.
Manche Provider verwenden einen Inhaltsfilter, der Antworten blockieren kann. CrucibleForge erfasst solche Fälle in jedem Bericht, kennzeichnet die jeweilige Zeile mit „blocked“ sowie einem Hinweis und bewertet blockierte Antworten mit Null Punkten. Sie müssen dafür nichts weiter einstellen.
Das Bewertungsmodell
Für Chat-Tests wird ein Bewertungsmodell benötigt – dieses darf jedoch nicht das zu testende Modell sein. Es kann sich dabei um ein weiteres Modell auf Ihrem lokalen Server oder ein gehostetes Modell handeln. Geben Sie es pro Lauf mit --judge provider:model_id an, oder listen Sie mögliche Bewertungsmodelle unter judge: in models.yaml. Zwei Dinge sind zu beachten:
- Das Bewertungsmodell beeinflusst die Chat-Ergebnisse. Ihre Chat-Werte stimmen nur dann mit der MakoBench-Übersicht überein, wenn Sie dasselbe Bewertungsmodell verwenden. Bei Code-Tests ist das nicht relevant, da diese direkt ausgeführt werden.
- Die meisten gehosteten Bewertungsmodelle lehnen oder „entschärfen“ explizite Inhalte. Dies erkennt der Kalibrierungstest. Der Rest der Chat-Tests wird dennoch bewertet; Einträge mit unangemessenen Inhalten bleiben solange als „unjudged“ markiert, bis Sie sie mit einem geeigneten Modell bewerten.
Weiterführende Informationen
crucibleforge conform --models my-modelführt die sieben Setup-Prüfungen eigenständig aus.crucibleforge cases verifyberechnet alle „Gold-Lösungen“ erneut offline – als Selbsttest.crucibleforge reporterstellt den Bericht erneut anhand der gespeicherten Ergebnisse.- Die Ergebnisse befinden sich in
results/, neben Ihrer Dateimodels.yaml; sie bleiben somit auf Ihrem Rechner.
Die README-Datei enthält Anweisungen zur Verwendung von Docker, zum Ausführen der Tests unabhängig vom Hauptprozess, dazu, wie man eigene Tests privat hält sowie wie man neue Testfälle hinzufügt. Möchten Sie nur die Zahlenwerte? Auf dem MakoBench-Dashboard finden Sie diese für die von uns getesteten Modelle; außerdem können Sie uns auftragen, Ihr Modell zu testen. Für eine ausführliche Erklärung zur Interpretation der Scores siehe Wie MakoBench funktioniert. Ein Installationsguide samt Beispielausgaben finden Sie unter CrucibleForge mit eigenen Modellen ausführen.