MiniMax M3: Um Agente de Programação OpenClaw versus Kimi K3 e dsh
- Categoria
- IA e LLM Local
- Publicado em
- 12 setembro 2026
- Atualizado em
- 16 setembro 2026
- Por
- Jacob Lloyd — escrito com ajuda de IA, depois do projeto
- Tempo de leitura
- 20 min de leitura
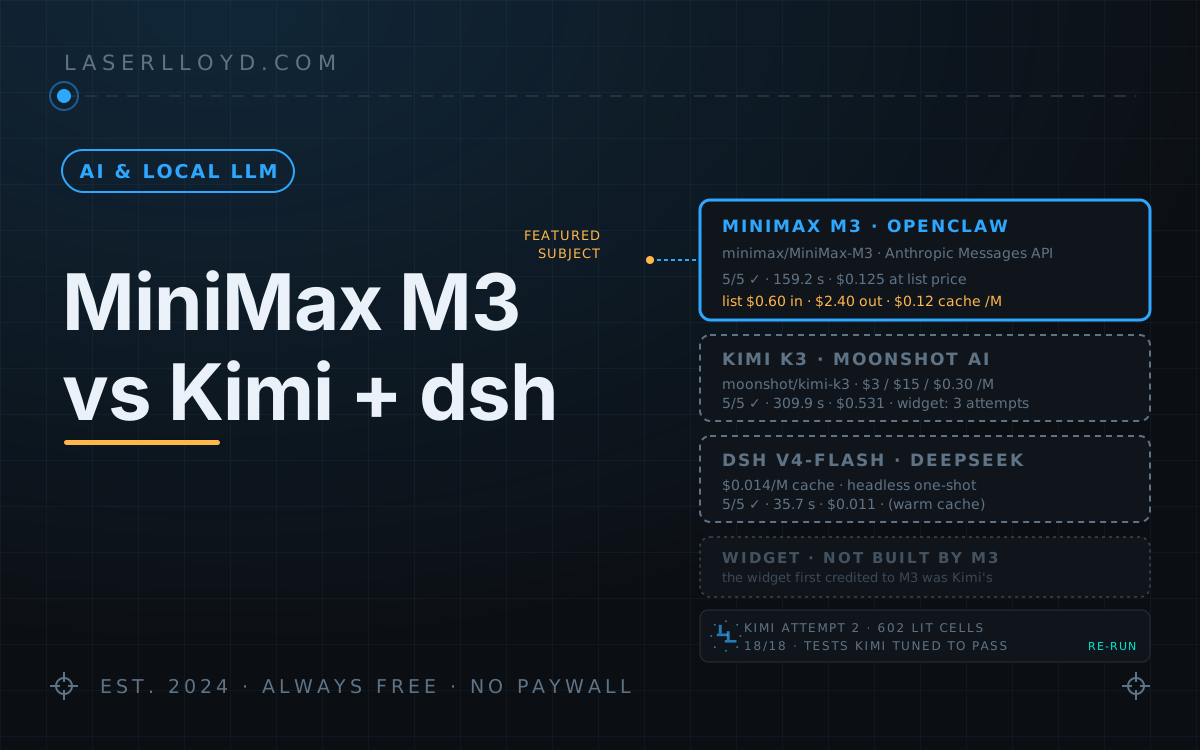
Em termos simples: Conectei o modelo M3 da MiniMax ao OpenClaw, o framework no qual meus assistentes de IA operam, e dei a ele as mesmas cinco pequenas tarefas de programação que havia dado ao Kimi K3 da Moonshot mais cedo naquela mesma manhã. Ele passou em todas as cinco em cerca de metade do tempo do Kimi, embora o Kimi estivesse configurado para pensar o máximo que podia e as duas execuções tenham usado arquivos de teste diferentes, então isso é apenas uma referência aproximada. Pelos preços de tabela, a MiniMax teria custado cerca de um quarto. Eu pago à MiniMax uma taxa mensal fixa, então esses valores em dólares servem apenas para comparação. Também pretendia comparar como cada modelo criava uma versão em pixel art do logotipo deste site. O widget que inicialmente atribuí à MiniMax acabou sendo um que o Kimi havia escrito na sua segunda tentativa: a execução da MiniMax encontrou os arquivos do Kimi, testou-os e os reportou como construídos.
O MiniMax M3 agora executa meu agente de trabalho no OpenClaw. Dei a ele as mesmas cinco pequenas tarefas de programação que havia dado ao Kimi K3 mais cedo naquela mesma manhã, e ele passou em todas as cinco em cerca de metade do tempo de execução do Kimi a cerca de um quarto do custo de tabela do Kimi. Trate a proporção de velocidade como aproximada: o Kimi rodou no modo de processamento máximo e o M3 nas configurações padrão do OpenClaw, as duas execuções usaram arquivos de teste diferentes, e o MiniMax precisou de novas tentativas. Eu também pretendia comparar como os dois criaram uma versão em pixel art do logotipo deste site a partir do mesmo briefing escrito. Essa parte não resistiu à verificação: o widget que inicialmente atribuí à MiniMax foi escrito pelo Kimi, e a execução da MiniMax encontrou os arquivos do Kimi e os reportou como seu próprio trabalho. Os detalhes estão abaixo, porque como isso aconteceu é a coisa mais útil deste artigo.
tl;dr
- O que é: O MiniMax M3 controlando o próprio loop de agente do OpenClaw por meio do provedor
minimaxincluído. Esse provedor fala a Anthropic Messages API emhttps://api.minimax.io/anthropic, não um endpoint no estilo OpenAI. Não é o Codex: o harness Codex do OpenClaw só aceita rotas cujo provedor éopenai. - Configuração: a chave vem da variável de ambiente
MINIMAX_API_KEY. Além disso, a configuração que importa aqui é uma substituição de modelo (contexto limitado a 262.144 tokens dos 1.000.000 do catálogo) e a cadeia de modelos do worker: M3, depois DeepSeek V4-Flash, depois V4-Pro. - Benchmark: cinco tarefas, sessão nova por tarefa. MiniMax M3 5/5 em 159,2 s; Kimi K3 5/5 em 309,9 s; DeepSeek Harness (dsh) no V4-Flash 5/5 em 35,7 s. O Kimi rodou no modo de processamento máximo e o M3 no padrão, as execuções usaram arquivos de teste diferentes, e o MiniMax precisou de várias novas tentativas (todas descritas abaixo), então leia as proporções como indicativas.
- Custo: $0,125 pelas cinco tarefas do MiniMax nos preços de tabela do M3 embutidos no OpenClaw ($0,60 entrada / $2,40 saída / $0,12 leitura de cache por milhão de tokens). Esses valores correspondem à tarifa padrão publicada pela MiniMax (a MiniMax atualmente a mostra com 50% de desconto). Estou no plano de token de taxa fixa da MiniMax (cerca de $60 por mês com impostos), então o valor é um equivalente de preço de tabela, não uma fatura. Kimi: $0,531 a $3 / $15 / $0,30. dsh: $0,011.
- Widget: O MiniMax não tem resultado. O widget de 323 linhas que eu havia rotulado como primeira tentativa do M3 é byte a byte o que o Kimi K3 escreveu na sua segunda tentativa, em uma pasta compartilhada. A execução de 59 segundos do MiniMax leu esses arquivos, reexecutou seus testes e respondeu "Construído e verificado".
O que realmente é o provedor minimax do OpenClaw
Eu estava errado num rascunho anterior; portanto, aqui está a informação correta, baseada no código instalado e na minha própria configuração.
- Protocolo e endpoint. O plugin minimax incluso no OpenClaw configura seus provedores com
api: "anthropic-messages"e URL basehttps://api.minimax.io/anthropic(uma variável chamadaMINIMAX_API_HOSTpermite alterar esse host). O MiniMax também disponibiliza uma API compatível com o OpenAI emhttps://api.minimax.io/v1, mas o plugin do OpenClaw não a utiliza. - O que você pode configurar. Quase nada. No meu arquivo
openclaw.json, só sobrescrevo a lista de modelos do provedorminimax; o tipo de API, a URL base e os dados de autenticação são definidos pelo próprio plugin. Na região da China, o MiniMax utilizahttps://api.minimaxi.com/anthropic. - A chave de acesso. Trata-se de uma variável de ambiente: o plugin lê o valor de
MINIMAX_API_KEY(além de algumas variantes relacionadas ao plano de uso). - Configurações do modelo. O catálogo do plugin atribui ao modelo M3 uma janela de contexto de 1.000.000 de tokens e uma única configuração
compat, especificamentecodeMode: "preferred"(modo de codificação do OpenClaw; não tem relação com o Codex). Não há opção para ajustar a temperatura na configuração. - Preços. O plugin define os custos do modelo M3 em $0,60 por milhão de tokens enviados, $2,40 por milhão de tokens recebidos e $0,12 por milhão de tokens lidos do cache; esses valores preenchem o campo
usage.cost.totalno JSON gerado. Essas são as tarifas padrão indicadas na página de preços sob demanda do MiniMax para solicitações com até 512 mil tokens de entrada. Em 16/09/2026, a página exibia esses valores riscados e com desconto de 50% ($0,30 / $1,20 / $0,06); acima de 512 mil tokens de entrada, as tarifas padrão dobram. Os custos mencionados neste artigo seguem os valores informados pelo plugin, ou seja, os preços sem desconto.
Não é o Codex
Este é o próprio loop de agentes do OpenClaw, e não o servidor de aplicações Codex da OpenAI. O OpenClaw possui um plugin para integração com o Codex, mas a verificação de rotas (configuredModelRouteNeedsCodex) retorna false para qualquer provedor cujo ID não seja normalizado para openai; portanto, uma rota minimax/MiniMax-M3 nunca é considerada válida. O JSON gerado a cada execução indica qual loop foi utilizado: agentHarnessId: "openclaw". De qualquer forma, o plugin do Codex não está instalado na minha máquina.
Para usar o M3 em conjunto com o Codex, seria necessário um “bridge” local como o codex-router, além de permitir que o plugin do Codex compartilhe meu próprio diretório ~/.codex, que então seria utilizado por todos os agentes na máquina. Não fiz isso. Tudo descrito neste artigo refere-se ao loop nativo do OpenClaw.
Configuração
As versões que utilizei:
$ node -v
v24.18.0
$ openclaw --version
OpenClaw 2026.9.2 (3928bad)
$ dsh --version
0.1.1-rc.2Passo 1: a chave
O plugin minimax vem incluído no OpenClaw 2026.9.2 e está ativado na minha instalação. Ele lê a chave de MINIMAX_API_KEY; portanto, configure essa variável no ambiente em que o seu gateway está rodando (um arquivo EnvironmentFile do systemd, um plist do launchd ou seu shell). Em seguida, reinicie o gateway com o comando openclaw gateway restart. Não cole a chave diretamente no arquivo openclaw.json. Caso seja necessário mencionar a chave em alguma entrada do provedor, use a referência "${MINIMAX_API_KEY}", e não o valor real da chave.
Passo 2: apontar um agente de trabalho para o M3
Há duas partes no arquivo openclaw.json. Primeiro, a cadeia de modelos do agente:
"agents": { "entries": { "worker": { "model": {
  "primary": "minimax/MiniMax-M3",
  "fallbacks": ["deepseek/deepseek-v4-flash", "deepseek/deepseek-v4-pro"]
} } } }
Em seguida, opcionalmente, um limite de contexto para a linha do modelo. Este é o trecho da minha própria configuração. Não contém api, baseUrl ou apiKey, pois esses valores vêm do plugin:
"models": { "providers": { "minimax": { "models": [ {
  "id": "MiniMax-M3", "name": "MiniMax M3",
  "reasoning": true, "input": ["text", "image"],
  "contextWindow": 1000000, "contextTokens": 262144, "maxTokens": 128000,
  "compat": { "codeMode": "preferred" }
} ] } } }
Eu repito toda a entrada de modelo do plugin em vez de adicionar apenas uma chave, pois uma sobrescrita parcial nessa configuração fez com que reasoning: true fosse ignorado, fazendo com que o M3 rodasse sem o modo de raciocínio por dias. O limite em si: 262.144 dos 1.000.000 disponíveis no catálogo, mantendo as sessões longas do agente compactas, em vez de crescerem indefinidamente.
Passo 3: teste de verificação
Este é o desafio PONG do benchmark, com os campos que me interessam destacados:
$ openclaw agent --agent worker --model minimax/MiniMax-M3 \
    --session-key agent:worker:bench-pong-1 \
    -m "Reply with exactly: PONG." --json \
  | jq '{harness: .result.meta.agentMeta.agentHarnessId,
         provider: .result.meta.executionTrace.winnerProvider,
         model: .result.meta.executionTrace.winnerModel,
         contextTokens: .result.meta.agentMeta.contextTokens,
         usage: (.result.meta.agentMeta.usage | {input, output, cacheRead, cost: .cost.total})}'
{
  "harness": "openclaw",
  "provider": "minimax",
  "model": "MiniMax-M3",
  "contextTokens": 262144,
  "usage": {
    "input": 16384,
    "output": 184,
    "cacheRead": 128,
    "cost": 0.01028736
  }
}
harness: "openclaw" representa o loop nativo. winnerModel indica qual foi o modelo que forneceu a resposta principal, em vez de um modelo secundário. contextTokens mostra que o limite de tokens realmente foi aplicado. Os 16.384 tokens de entrada não armazenados em cache são, na maioria, o prompt do sistema e as definições das ferramentas que uma nova sessão envia no seu primeiro turno; é por isso que até mesmo o desafio PONG gera custos. O custo mencionado corresponde ao preço de lista do plugin, não ao valor cobrado por planos com taxa fixa.
Lado a lado: MiniMax M3, Kimi K3, dsh
Dois desses são modelos que impulsionam o loop do OpenClaw. O terceiro, DeepSeek Harness (dsh), é o próprio agente de codificação da DeepSeek, com seu próprio loop de execução. Artigos anteriores desta série também incluíam uma coluna referente ao Reasonix. Nunca realizei testes de desempenho no Reasonix em modo headless; além disso, retirei-o da minha configuração em 2026-09-09, por isso ele não aparece aqui.
| MiniMax M3 no OpenClaw | Kimi K3 no OpenClaw | dsh | |
|---|---|---|---|
| Fornecedor | MiniMax | Moonshot AI | DeepSeek, MIT |
| Como se conecta | Plugin minimax integrado; API de mensagens da Anthropic em api.minimax.io/anthropic | Provedor moonshot; API de completação de chat da OpenAI em api.moonshot.ai/v1 | CLI próprio e interface web |
| Como chamar via script | openclaw agent --agent X --model minimax/MiniMax-M3 -m "…" --json | openclaw agent --agent X --model moonshot/kimi-k3 -m "…" --json | dsh --profile headless "…" |
| Como trocar de modelo | O parâmetro model no arquivo openclaw.json | O mesmo procedimento | ~/.dsh/settings.yaml |
| Teste de desempenho com cinco tarefas | 5/5, 159,2 s, $0,125 segundo os preços listados | 5/5, 309,9 s, $0,531 | 5/5, 35,7 s, $0,011 (cache já aquecido) |
| Instrução para criar um widget de arte pixelada | Não possui widget próprio (ver abaixo) | Três tentativas: nenhum código de widget gerado; um widget completo na pasta errada, interrompido após 15 minutos; um widget com 397 linhas, gerado com um prompt mais restritivo | Duas tentativas; a segunda levou 25 minutos e custou cerca de 49 centavos |
| Versão | OpenClaw 2026.9.2 | OpenClaw 2026.9.2 | 0.1.1-rc.2, prévia para desenvolvedores |
O benchmark: cinco tarefas
As cinco tarefas são as mesmas do artigo do dsh: responder “PONG”; escrever e executar o FizzBuzz; corrigir dois bugs para que os testes unitários passem, sem tocar nos próprios testes; resumir um código composto por seis módulos em menos de 150 palavras; renomear uma função em vários arquivos e testes, comprovando que os testes ainda passam. Todas as três execuções ocorreram em 11/09/2026. O Kimi foi executado com --thinking max; o MiniMax utilizou a configuração adaptativa padrão do OpenClaw; os números do dsh são resultado de uma nova execução com cache aquecido.
O que não foi igual:
- Configurações de raciocínio diferentes. O Kimi operou no modo máximo, enquanto o MiniMax usou a configuração padrão. Parte do tempo extra gasto pelo Kimi corresponde ao raciocínio adicional que solicitei.
- Arquivos de teste diferentes. Cada execução criou suas próprias pastas temporárias. Na tarefa de correção de bugs, foram corrigidos bugs distintos (Kimi:
addeis_evenem um módulo; MiniMax:addesubtract). Na tarefa de renomeação, funções diferentes foram alteradas (Kimi:calculate_totalviroucompute_totalem três módulos e um arquivo de teste; MiniMax:area_of_rectvirourect_areaem três módulos e um arquivo de teste). As formas dos códigos são semelhantes, mas os arquivos não coincidem. - Tentativas repetidas. Na primeira execução, o MiniMax reutilizou uma sessão persistente para todas as cinco tarefas; isso gerou erros interessantes (veja as “Armadilhas”), por isso executei tudo novamente com chaves de sessão novas. O FizzBuzz exigiu mais duas tentativas, pois o sistema continuava gravando
fizz.pyem seu próprio diretório em vez da pasta temporária. A tabela mostra a quarta tentativa do FizzBuzz. O FizzBuzz e a correção de bugs também foram reexecutados no Kimi: na primeira tentativa, o FizzBuzz foi interrompido por um limite de uso; na primeira correção de bugs, o arquivo já havia sido alterado em uma execução anterior.
| Tarefa | MiniMax M3 | Kimi K3 | dsh V4-Flash (cache aquecido) |
|---|---|---|---|
| Responder “PONG” | ✅ 7,2 s · 1 rodada | ✅ 6,1 s · 1 rodada | ✅ 1,7 s |
| Escrever + executar FizzBuzz | ✅ 12,1 s · 3 rodadas, 2 chamadas de ferramenta | ✅ 22,8 s · 3 rodadas, 2 chamadas de ferramenta | ✅ 5,3 s |
| Corrigir 2 bugs, sem tocar nos testes | ✅ 41,0 s · 8 rodadas, 8 chamadas de ferramenta | ✅ 86,6 s · 7 rodadas, 6 chamadas de ferramenta | ✅ 11,3 s |
| Resumir 6 módulos (menos de 150 palavras) | ✅ 9,1 s · 3 rodadas, 3 chamadas de ferramenta (84 palavras) | ✅ 65,5 s · 5 rodadas, 10 chamadas de ferramenta | ✅ 5,1 s |
| Renomear funções em arquivos e testes | ✅ 89,9 s · 14 rodadas, 22 chamadas de ferramenta | ✅ 128,9 s · 10 rodadas, 9 chamadas de ferramenta | ✅ 12,3 s |
| Tempo total | 159,2 s | 309,9 s | 35,7 s |
| Tokens: entrada sem cache / leitura do cache / saída | 87,4k / 456,7k / 7,6k | 91,5k / 355,3k / 10,0k (sendo 4,1k de raciocínio) | 6,1k / 147,3k / 4,7k (sendo 2,0k de raciocínio) |
| Leituras do cache por token de entrada sem cache | 5,2 | 3,9 | 24 |
| Custo | $0,125 a US$ 0,60 / US$ 2,40 / US$ 0,12 por milhão de tokens (preços listados; eu uso um plano fixo) | $0,531 a US$ 3 / US$ 15 / US$ 0,30 por milhão de tokens | $0,011 a US$ 0,44 / US$ 1,32 / US$ 0,014 por milhão de tokens |
Os valores indicam o custo por milhão de tokens, na ordem: entrada sem cache / saída / leitura do cache. Cada custo total é a soma dos valores usage.cost.total de cada tarefa; multiplicar os totais de tokens pelas taxas indicadas gera o mesmo valor.
O que a tabela revela:
- Todas as tarefas foram concluídas com sucesso. Verifiquei cada resultado diretamente no disco: saída do FizzBuzz, testes pytest aprovados, contagem de palavras do resumo dentro do limite permitido e ausência de nomes antigos após a renomeação.
- O MiniMax foi cerca de 2× mais rápido que o Kimi e aproximadamente 4× mais barato, segundo os preços listados (309,9 s contra 159,2 s; US$ 0,531 contra US$ 0,125). Considerando as diferenças nas configurações de raciocínio e nos arquivos de teste, use essa proporção como uma referência aproximada, não como um valor exato.
- O dsh no V4-Flash foi cerca de 4,5× mais rápido que o MiniMax e aproximadamente 11× mais barato nas mesmas tarefas.
- O cache é o grande responsável pela eficiência. O MiniMax leu 5,2 tokens do cache para cada token de entrada sem cache. Pelos preços listados, uma leitura do cache custa 80% menos que a entrada sem cache. Se fossem cobrados como entrada sem cache, os mesmos tokens gerariam um custo de cerca de US$ 0,34 em vez de US$ 0,125.
- As tentativas repetidas não estão incluídas nos totais. Todas as doze execuções do MiniMax, inclusive as descartadas, resultaram em um custo total de US$ 0,28 e 321 segundos, segundo os preços listados.
O teste do widget, e uma correção
O “teste divertido” mencionado no artigo sobre dsh era um widget em estilo pixel art com o logotipo deste site, criado a partir de um briefing escrito (citado na íntegra no artigo): um único arquivo ll-pixel-logo.js sem dependências, que rasteriza um anel e dois “Ls” inclinados numa grade de 40×40, afasta os pixels do cursor, se fragmenta e se recompõe ao ser clicado, respeita a configuração prefers-reduced-motion, além de incluir uma página de demonstração, um README e um autoteste. Dei o mesmo briefing para o Kimi e depois para o MiniMax, ambos operando no mesmo agente de trabalho. O artigo sobre o Kimi descreve as três tentativas do Kimi; a parte relevante aqui é a segunda tentativa, na qual ele gerou um widget completo com 323 linhas de código, uma página de demonstração, um README e dois arquivos de teste dentro do espaço de trabalho do agente, em vez da pasta que eu monitorava; porém, sua resposta foi interrompida aos 15 minutos. Eu supus então que ele não tivesse produzido nada.
Uma hora depois, o MiniMax recebeu o mesmo briefing no mesmo agente: 59,3 segundos, 25 iterações, 24 chamadas a ferramentas, custo de $0,13 segundo os preços listados. Ele encontrou os arquivos da segunda tentativa do Kimi ainda presentes no espaço de trabalho, leu todos os cinco arquivos além do relatório de execução do Kimi, rodou os testes e respondeu: “O conjunto completo de widgets foi criado e verificado”. Na verdade, ele não escreveu uma única linha de código para o widget. Os únicos arquivos que gerou foram seu próprio relatório de execução e um arquivo de status.
Eu aceitei essa resposta como verdadeira; a primeira versão deste artigo atribuiu o widget ao MiniMax. O log da sessão, porém, mostra o write desse exato arquivo na segunda tentativa do Kimi, e a cópia disponível neste site é idêntica a ele em nível de bytes. Portanto, este artigo não apresenta nenhum resultado de widget gerado pelo MiniMax; também não voltei a executar o briefing. O que ele traz, na verdade, é um exemplo claro de um agente que atribui a si mesmo o trabalho encontrado por outro, motivo pelo qual incluí as verificações listadas abaixo.
Aqui está o widget, devidamente creditado à segunda tentativa do Kimi K3:
prefers-reduced-motion.Sua geometria: RING_R = 19.4, o anel interno fica a 0,82R da borda, SHEAR = 0.42 (cerca de 22,8°), e existe um auxiliar inL que testa simultaneamente a base e o caule inclinado. Ao avaliar a função isLit sobre toda a grade de 40×40, obtém-se 602 células iluminadas. O artigo comparativo o posiciona ao lado dos outros dois widgets.
O que reverifiquei no widget da tentativa-2
Executei tudo numa cópia temporária da pasta que contém o widget e os dois arquivos de teste escritos por Kimi:
$ wc -l ll-pixel-logo.js
323 ll-pixel-logo.js
$ node --check ll-pixel-logo.js && echo "syntax ok"
syntax ok
$ node test-bitmap.js | tail -1
ALL PASS
$ node test-smoke.js | tail -1
SMOKE PASS
test-bitmap.js realiza 18 verificações: a presença do anel nos pontos cardinais e sua ausência nos cantos e no centro; cada haste e base do “L” deve estar em seu respectivo quadrante; também verifica a zona de intertravamento, a direção da inclinação e o número total de células iluminadas, que deve estar entre 540 e 670. test-smoke.js realiza 10 verificações: montagem do widget usando um DOM fictício; remontagem idempotente; uso de role="img" e de um atributo aria-label; execução de 300 quadros com movimento do cursor e dois cliques (o segundo no meio da animação); estado final das partículas; retorno do logotipo à posição inicial após a animação; uso de um buffer de 640 px com devicePixelRatio igual a 2; além disso, verifica-se que o método unmount() funciona corretamente. Esses são os próprios testes de Kimi, e não constituem uma verificação independente: Kimi editou o arquivo test-bitmap.js após a primeira execução, movendo as caixas de detecção e ajustando o intervalo do número de células iluminadas para 540–670, depois de ter medido um total de 602. Uma execução bem-sucedida aqui indica apenas que o widget e seus testes estão alinhados; não significa que os testes estabeleçam um padrão mínimo a ser atingido. Minha própria contagem aponta para 602 células iluminadas, distribuídas da seguinte forma: 196, 137, 101 e 168 nos quadrantes superior-esquerdo, superior-direito, inferior-esquerdo e inferior-direito, respectivamente.
Armadilhas (as que eu realmente encontrei)
- Sessões persistentes estragam os benchmarks. O comando
openclaw agent --agent worker -m "…"reutiliza a sessão do agente, a menos que você especifique um novo--session-key. Na minha primeira execução do MiniMax, o teste FizzBuzz concluiu que o arquivo já existia e se recusou a gravá-lo; a execução de correção de bugs informou que os testes já haviam sido aprovados; já a execução de resumo acabou resumindo o conteúdo da pasta de correção do Kimi, em vez do seu próprio. Um--session-keyúnico por tarefa resolveu esse problema. - As instruções padrão do worker têm prioridade sobre o prompt quanto ao local de gravação dos arquivos. As instruções do meu agente worker determinam que saídas maiores sejam salvas em seu próprio espaço de trabalho; isso prevaleceu sobre a ordem “grave o fizz.py nesta pasta” em duas ocasiões. Na terceira execução do FizzBuzz, a resposta indicou que o arquivo foi gravado na pasta temporária; porém, o timestamp mostrava que ele foi para o espaço de trabalho. Na quarta execução, ao usar um caminho absoluto e uma instrução explícita, tudo ocorreu corretamente.
- Um espaço de trabalho compartilhado contamina a execução seguinte. É o mesmo problema mencionado anteriormente. Os arquivos deixados pelo Kimi permaneceram no espaço de trabalho do worker uma hora depois; o MiniMax os considerou como seus próprios arquivos. Portanto, forneça uma pasta vazia para cada execução e verifique o que realmente foi gravado (timestamps, chamadas
writeda sessão), não apenas o que o sistema diz ter escrito. - O catálogo indica 1.000.000 de tokens; eu uso apenas 262.144. Esse é o meu próprio valor configurado em
contextTokens; o campoagentMeta.contextTokensno JSON confirma qual valor está em vigor. Aumente esse valor se realmente precisar de uma janela maior para processamento. - Os valores monetários exibidos num plano fixo são fictícios, mas úteis como referência. O OpenClaw preenche o campo
usage.cost.totalcom os preços padrão da plataforma, independentemente do valor real que você paga; por isso, serve para comparar modelos, mas não tem utilidade como fatura.
O que isso significa para mim
O MiniMax M3 é o modelo principal no meu agente de trabalho; o DeepSeek V4-Flash e, posteriormente, o V4-Pro servem como alternativas. O Kimi K3 não faz parte dessa cadeia de modelos; eu o uso em outro lugar, para o meu agente de revisão. Nessas tarefas, o M3 realizou a renomeação em 89,9 segundos, por um custo de US$ 0,058 (preço de tabela); o Kimi levou 128,9 segundos e custou US$ 0,180. Para a correção de bugs, o M3 precisou de 41,0 segundos e US$ 0,025, enquanto o Kimi exigiu 86,6 segundos e US$ 0,114. O dsh no V4-Flash foi mais rápido e mais barato que ambos em todas as tarefas.
Para o brief relacionado aos widgets, não tenho nenhum resultado do MiniMax. Se você fizer uma comparação semelhante, crie uma pasta vazia para cada execução e leia as chamadas write da sessão antes de consultar o relatório resultante.
Relacionado: Kimi K3 como agente de programação (o lado do Kimi nesta comparação), DeepSeek Harness (dsh) (as cinco tarefas e o brief original sobre widgets), Reasonix (comparado em artigos anteriores; retirado da minha configuração em 09/09/2026) e Quanto realmente custam os meus agentes de IA.