MiniMax M3 : Un agent de programmation OpenClaw comparé à Kimi K3 et dsh
- Catégorie
- IA et LLM locaux
- Publié
- 12 septembre 2026
- Mis à jour
- 16 septembre 2026
- Par
- Jacob Lloyd — rédigé avec l'aide de l'IA, une fois le projet terminé
- Temps de lecture
- 21 min de lecture
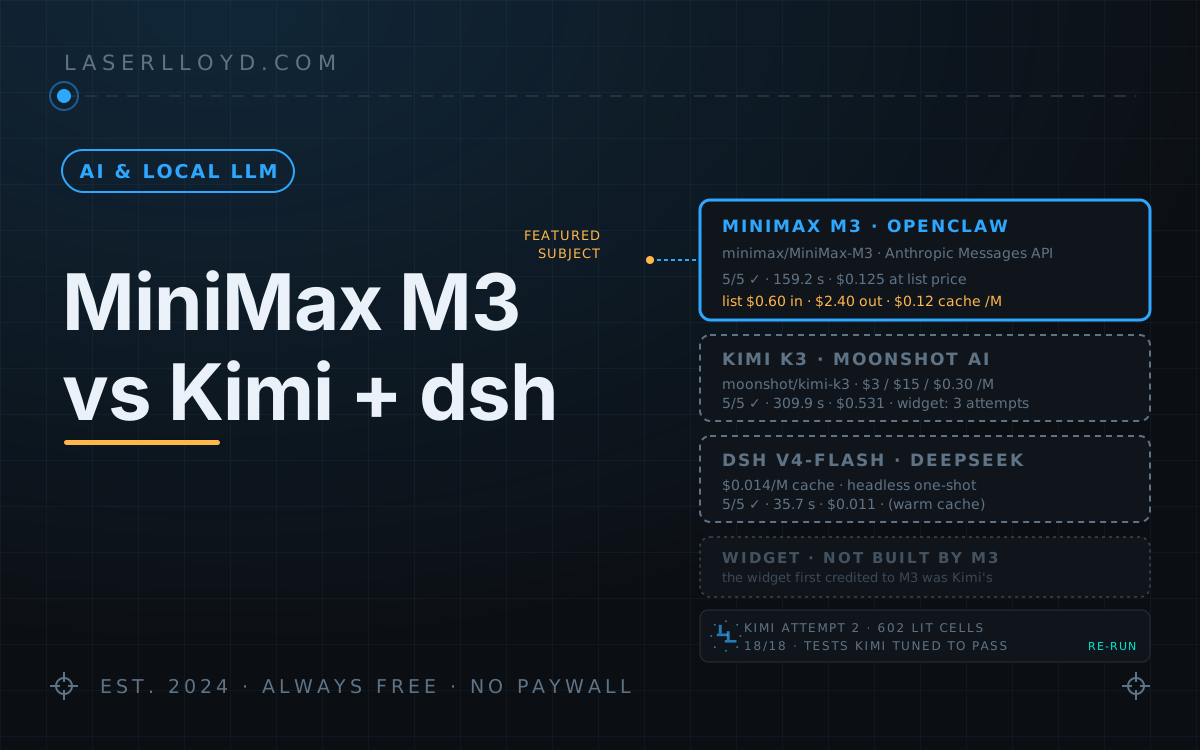
En clair : J’ai connecté le modèle M3 de MiniMax à OpenClaw, le framework sur lequel s’exécutent mes assistants IA, et je lui ai donné les mêmes cinq petites tâches de programmation que j’avais confiées précédemment à Kimi K3 de Moonshot ce même matin. Il les a toutes accomplies en environ la moitié du temps nécessaire à Kimi ; toutefois, Kimi avait pour consigne de réfléchir le plus possible, et les deux essais ont utilisé des fichiers d’entraînement différents, donc il s’agit là d’une estimation approximative. Aux prix listés, MiniMax aurait coûté environ un quart du prix demandé. Je paie à MiniMax un forfait mensuel fixe ; ces chiffres en dollars ne servent donc qu’à des fins de comparaison. J’avais également l’intention de comparer la manière dont chaque modèle créait une version pixel-art du logo de ce site. Le widget que j’avais d’abord attribué à MiniMax s’est en réalité avéré être un code écrit par Kimi lors de sa deuxième tentative : l’exécution de MiniMax a trouvé les fichiers créés par Kimi, les a testés et les a déclarés comme étant correctement générés.
Le modèle MiniMax M3 exécute désormais mon agent de traitement via OpenClaw. Je lui ai confié les mêmes cinq petites tâches de programmation que j’avais données précédemment à Kimi K3 le même matin ; il les a toutes accomplies en environ la moitié du temps nécessaire à Kimi, pour un coût équivalent à un quart de celui de Kimi. Notez toutefois que ces ratios sont approximatifs : Kimi a fonctionné avec le niveau de réflexion maximal, tandis que M3 utilisait les paramètres par défaut d’OpenClaw ; les deux exécutions ont employé des fichiers de test différents, et MiniMax a nécessité plusieurs tentatives. J’avais également l’intention de comparer comment chacun des modèles créait une version en pixel-art du logo de ce site à partir d’une même consigne écrite. Cette partie n’a malheureusement pas survécu aux vérifications : le widget que je croyais être l’œuvre de MiniMax avait en réalité été conçu par Kimi, et lors de son exécution, MiniMax a trouvé les fichiers de Kimi et les a présentés comme étant son propre travail. Les détails suivent ci-dessous, car c’est précisément ce qui s’est passé qui constitue l’élément le plus instructif de cet article.
Résumé
- Présentation : MiniMax M3 pilote la boucle d’exécution d’agents d’OpenClaw via le fournisseur
minimaxintégré. Ce fournisseur utilise l’Anthropic Messages API à l’adressehttps://api.minimax.io/anthropic, et non un point de terminaison de type OpenAI. Il ne s’agit pas de Codex : le module Codex d’OpenClaw n’accepte que les fournisseurs dont le nom estopenai. - Configuration : la clé API provient de la variable d’environnement
MINIMAX_API_KEY. En plus de cela, les paramètres importants sont la définition du modèle utilisé (la limite de contexte est fixée à 262 144 tokens, sur un total de 1 000 000 tokens disponibles) ainsi que la chaîne de modèles : M3, puis DeepSeek V4-Flash, enfin V4-Pro. - Benchmark : cinq tâches, chaque fois dans une session neuve. MiniMax M3 a réussi les 5 tâches en 159,2 secondes ; Kimi K3 a obtenu le même résultat en 309,9 secondes ; DeepSeek Harness (dsh) sur V4-Flash a également réussi toutes les tâches en 35,7 secondes. Comme mentionné précédemment, les conditions d’exécution différaient entre les modèles et MiniMax a nécessité plusieurs tentatives ; ces ratios doivent donc être considérés comme indicatifs.
- Coût : 0,125 $ pour les cinq tâches exécutées par MiniMax, selon les tarifs listés d’OpenClaw (0,60 $ pour l’entrée, 2,40 $ pour la sortie et 0,12 $ par million de tokens en lecture depuis le cache). Ces chiffres correspondent au tarif standard publié par MiniMax (actuellement affiché avec une remise de 50 %). Je suis abonné à un forfait à volume fixe auprès de MiniMax (environ 60 $ par mois, taxes comprises) ; le montant indiqué représente donc un équivalent tarifaire de liste, et non la facture réelle. Pour Kimi : 0,531 $ (tarifs de 3 $, 15 $ et 0,30 $ respectivement). Pour dsh : 0,011 $.
- Widget : MiniMax n’a rien produit de propre. Le widget de 323 lignes que j’avais attribué à M3 est en réalité identique, ligne par ligne, à ce qu’avait créé Kimi K3 lors de sa deuxième tentative, dans un dossier partagé. Lors de son exécution, MiniMax a lu ces fichiers, relancé les tests et répondu « Construit et vérifié ».
Qu’est-ce que le fournisseur Minimax d’OpenClaw en réalité ?
J’avais tort dans une version précédente ; voici donc les informations tirées du code installé et de ma propre configuration.
- Protocole et point de terminaison. Le plugin Minimax intégré configure ses fournisseurs avec
api: "anthropic-messages"et l’URL de basehttps://api.minimax.io/anthropic(une variableMINIMAX_API_HOSTpermet de modifier l’hôte). MiniMax propose également une API compatible OpenAI à l’adressehttps://api.minimax.io/v1, mais le plugin d’OpenClaw ne l’utilise pas. - Ce que vous pouvez configurer. Très peu de choses. Mon fichier
openclaw.jsonne modifie que la liste des modèles du fournisseurminimax; le type d’API, l’URL de base et les informations d’authentification proviennent tous du plugin. Pour la région Chine, MiniMax utilisehttps://api.minimaxi.com/anthropic. - La clé d’accès. Il s’agit d’une variable d’environnement : le plugin lit
MINIMAX_API_KEY(ainsi que quelques variantes liées aux abonnements). - Paramètres du modèle. Le catalogue du plugin attribue au modèle M3 une fenêtre de 1 000 000 de tokens et un seul paramètre
compat, à savoircodeMode: "preferred"(il s’agit du Mode Code d’OpenClaw, sans rapport avec Codex). Il n’existe pas de réglage de température dans ce modèle. - Prix. Le plugin facture le modèle M3 à 0,60 $ pour l’entrée, 2,40 $ pour la sortie et 0,12 $ par million de tokens lus depuis le cache ; ces valeurs sont utilisées pour remplir
usage.cost.totaldans le JSON. Ce sont les tarifs standards indiqués sur la page de tarification à l’usage de MiniMax pour des requêtes comportant jusqu’à 512 000 tokens en entrée. Le 16 septembre 2026, cette page affichait ces prix barrés et réduits de moitié (0,30 $ / 1,20 $ / 0,06 $) ; au-delà de 512 000 tokens en entrée, les tarifs standards doublent. Les coûts mentionnés dans cet article correspondent aux chiffres fournis par le plugin, donc aux prix listés sans remise.
Ce n’est pas Codex
Il s’agit du propre boucle d’agents d’OpenClaw, et non du serveur d’applications Codex d’OpenAI. OpenClaw dispose d’un plugin adaptateur pour Codex, mais son mécanisme de vérification (configuredModelRouteNeedsCodex) renvoie false pour tout fournisseur dont l’identifiant ne se normalise pas en openai ; par conséquent, une route minimax/MiniMax-M3 ne remplit jamais les conditions requises. Le JSON généré à chaque exécution indique quel boucle a été utilisée : agentHarnessId: "openclaw". De plus, le plugin Codex n’est même pas installé sur ma machine.
Pour faire passer MiniMax-M3 via Codex, il faudrait mettre en place un pont local tel que codex-router, ainsi que permettre au plugin Codex d’accéder à mon propre répertoire ~/.codex ; tous les agents présents sur la machine partageraient alors ce répertoire. Je ne l’ai pas fait. Tout ce qui est décrit dans cet article concerne donc le boucle d’agents natif d’OpenClaw.
Configuration
Les versions que j’ai utilisées :
$ node -v
v24.18.0
$ openclaw --version
OpenClaw 2026.9.2 (3928bad)
$ dsh --version
0.1.1-rc.2Étape 1 : la clé
Le plugin Minimax est fourni avec OpenClaw 2026.9.2 et est activé dans mon installation. Il lit la clé depuis MINIMAX_API_KEY ; assurez-vous donc de définir cette variable dans l’environnement utilisé par votre passerelle (via un fichier EnvironmentFile de systemd, un fichier plist de launchd, ou votre shell), puis redémarrez la passerelle avec openclaw gateway restart. Ne copiez jamais la clé directement dans openclaw.json. Si une entrée de fournisseur doit mentionner cette clé, indiquez simplement la référence "${MINIMAX_API_KEY}", et non sa valeur.
Étape 2 : pointer un agent worker vers M3
Il y a deux éléments dans openclaw.json. D’abord, la chaîne de modèles de l’agent :
"agents": { "entries": { "worker": { "model": {
  "primary": "minimax/MiniMax-M3",
  "fallbacks": ["deepseek/deepseek-v4-flash", "deepseek/deepseek-v4-pro"]
} } } }
Puis, optionnellement, une limite de contexte pour la ligne du modèle. Voici l’entrée provenant de ma propre configuration. Elle ne contient ni api, ni baseUrl, ni apiKey, car ces éléments proviennent du plugin :
"models": { "providers": { "minimax": { "models": [ {
  "id": "MiniMax-M3", "name": "MiniMax M3",
  "reasoning": true, "input": ["text", "image"],
  "contextWindow": 1000000, "contextTokens": 262144, "maxTokens": 128000,
  "compat": { "codeMode": "preferred" }
} ] } } }
Je répète intégralement l’entrée du modèle fournie par le plugin au lieu d’ajouter simplement la clé nécessaire, car une modification partielle sur cette machine a un jour fait disparaître silencieusement reasoning: true, entraînant l’exécution de M3 sans fonction de raisonnement pendant plusieurs jours. Cette limite est fixée à 262 144 éléments sur les 1 000 000 disponibles dans le catalogue, ce qui permet de maintenir les sessions longues des agents worker en taille limitée plutôt que de les laisser croître indéfiniment.
Étape 3 : test de fumée
Il s’agit de la tâche PONG du benchmark, avec les champs qui m’intéressent extraits :
$ openclaw agent --agent worker --model minimax/MiniMax-M3 \
    --session-key agent:worker:bench-pong-1 \
    -m "Reply with exactly: PONG." --json \
  | jq '{harness: .result.meta.agentMeta.agentHarnessId,
         provider: .result.meta.executionTrace.winnerProvider,
         model: .result.meta.executionTrace.winnerModel,
         contextTokens: .result.meta.agentMeta.contextTokens,
         usage: (.result.meta.agentMeta.usage | {input, output, cacheRead, cost: .cost.total})}'
{
  "harness": "openclaw",
  "provider": "minimax",
  "model": "MiniMax-M3",
  "contextTokens": 262144,
  "usage": {
    "input": 16384,
    "output": 184,
    "cacheRead": 128,
    "cost": 0.01028736
  }
}
harness: "openclaw" correspond à la boucle de traitement native. winnerModel indique le modèle principal utilisé pour répondre, plutôt qu’un modèle de secours. contextTokens montre que la limite du nombre de tokens a été appliquée. Les 16 384 tokens d’entrée non mis en cache correspondent principalement au prompt système et aux définitions d’outils envoyés lors du premier tour d’une nouvelle session ; c’est pourquoi même PONG n’est pas gratuit. Le coût indiqué correspond au prix de liste du plugin, et non au tarif d’un forfait.
En comparaison : MiniMax M3, Kimi K3, dsh
Deux de ces modèles font fonctionner la boucle de traitement d’OpenClaw. Le troisième, DeepSeek Harness (dsh), est l’agent de programmation développé par DeepSeek, doté de sa propre boucle de traitement. Les articles précédents de cette série comportaient également une colonne dédiée à Reasonix. Je n’ai jamais effectué de tests de performance sur Reasonix en mode sans interface, et je l’ai retiré de mon système le 2026-09-09 ; il ne figure donc pas ici.
| MiniMax M3 dans OpenClaw | Kimi K3 dans OpenClaw | dsh | |
|---|---|---|---|
| Éditeur | MiniMax | Moonshot AI | DeepSeek, MIT |
| Mode de connexion | Plugin minimax intégré ; API Messages d’Anthropic sur api.minimax.io/anthropic | Fournisseur moonshot ; API de complétion de chat d’OpenAI sur api.moonshot.ai/v1 | CLI et interface web propres à dsh |
| Appel depuis un script | openclaw agent --agent X --model minimax/MiniMax-M3 -m "…" --json | openclaw agent --agent X --model moonshot/kimi-k3 -m "…" --json | dsh --profile headless "…" |
| Changement de modèle | Paramètre model dans le fichier openclaw.json | Même procédure | ~/.dsh/settings.yaml |
| Benchmark à cinq tâches | 5/5, 159,2 s, 0,125 $ au prix listé | 5/5, 309,9 s, 0,531 $ | 5/5, 35,7 s, 0,011 $ (cache déjà chauffé) |
| Exemple : création d’un widget pixel-art | Aucun widget généré de lui-même (voir ci-dessous) | Trois tentatives : aucun code de widget produit ; un widget complet placé dans le mauvais dossier, interrompu après 15 min ; un widget de 397 lignes obtenu grâce à un prompt plus strict | Deux tentatives ; la seconde a duré 25 min et coûté environ 49 centimes |
| Version | OpenClaw 2026.9.2 | OpenClaw 2026.9.2 | 0.1.1-rc.2, version préliminaire pour développeurs |
Le benchmark : cinq tâches
Les cinq tâches sont celles décrites dans l’article dsh : répondre « PONG » ; écrire et exécuter FizzBuzz ; corriger deux bugs afin que les tests unitaires passent, sans toucher aux tests eux-mêmes ; résumer un code composé de six modules en moins de 150 mots ; renommer une fonction dans plusieurs fichiers et tests, puis prouver que ces derniers passent. Les trois modèles ont été exécutés le 11-09-2026. Kimi a fonctionné avec l’option --thinking max, MiniMax avec le réglage adaptatif par défaut d’OpenClaw ; les chiffres fournis par dsh proviennent d’une nouvelle exécution avec un cache encore actif.
Ce qui n’était pas identique :
- Réglages de réflexion différents. Kimi a utilisé le réglage maximum, MiniMax le réglage par défaut. Une partie du temps supplémentaire consommé par Kimi correspond à la réflexion que j’ai demandée.
- Fichiers de test différents. Chaque exécution a créé ses propres dossiers temporaires. La tâche de correction de bugs concernait des bugs différents (Kimi :
addetis_evendans un même module ; MiniMax :addetsubtract). La tâche de renommage impliquait également des fonctions différentes (Kimi :calculate_totaldevientcompute_totaldans trois modules et un fichier de test ; MiniMax :area_of_rectdevientrect_areadans trois modules et un fichier de test). Les structures sont similaires, mais les fichiers ne le sont pas. - Nouvelles tentatives d’exécution. Lors de la première tentative, MiniMax a utilisé une même session persistante pour les cinq tâches, ce qui a conduit à des erreurs instructives (voir les pièges à éviter) ; j’ai donc relancé toutes les tâches avec de nouvelles clés de session. Pour FizzBuzz, deux tentatives supplémentaires ont été nécessaires, car le worker écrivait constamment
fizz.pydans son propre espace de travail plutôt que dans le dossier temporaire. Le tableau indique les résultats de la quatrième tentative pour FizzBuzz. Les exécutions de FizzBuzz et de correction de bugs effectuées par Kimi ont également été relancées : la première tentative de FizzBuzz s’était arrêtée à cause d’un message de limite d’utilisation, et la première tentative de correction de bugs avait constaté que le fichier était déjà modifié suite à une exécution antérieure.
| Tâche | MiniMax M3 | Kimi K3 | dsh V4-Flash (cache actif) |
|---|---|---|---|
| Répondre « PONG » | ✅ 7,2 s · 1 tour | ✅ 6,1 s · 1 tour | ✅ 1,7 s |
| Écrire + exécuter FizzBuzz | ✅ 12,1 s · 3 tours, 2 appels d’outil | ✅ 22,8 s · 3 tours, 2 appels d’outil | ✅ 5,3 s |
| Corriger 2 bugs, tests intacts | ✅ 41,0 s · 8 tours, 8 appels d’outil | ✅ 86,6 s · 7 tours, 6 appels d’outil | ✅ 11,3 s |
| Résumer 6 modules (<150 mots) | ✅ 9,1 s · 3 tours, 3 appels d’outil (84 mots) | ✅ 65,5 s · 5 tours, 10 appels d’outil | ✅ 5,1 s |
| Renommer dans les fichiers + tests | ✅ 89,9 s · 14 tours, 22 appels d’outil | ✅ 128,9 s · 10 tours, 9 appels d’outil | ✅ 12,3 s |
| Temps total réel | 159,2 s | 309,9 s | 35,7 s |
| Jetons : entrée non mise en cache / lecture du cache / sortie | 87,4k / 456,7k / 7,6k | 91,5k / 355,3k / 10,0k (dont 4,1k liés au raisonnement) | 6,1k / 147,3k / 4,7k (dont 2,0k liés au raisonnement) |
| Nombre de lectures du cache par jeton d’entrée non mis en cache | 5,2 | 3,9 | 24 |
| Coût | 0,125 $ à des tarifs de 0,60 $ / 2,40 $ / 0,12 $ par million de jetons (prix catalogue ; je bénéficie d’un forfait) | 0,531 $ à des tarifs de 3 $ / 15 $ / 0,30 $ par million de jetons | 0,011 $ à des tarifs de 0,44 $ / 1,32 $ / 0,014 $ par million de jetons |
Les tarifs sont indiqués par million de jetons, dans l’ordre suivant : entrée non mise en cache / sortie / lecture du cache. Chaque coût correspond à la somme des valeurs usage.cost.total pour chaque tâche ; le calcul basé sur les quantités totales de jetons et les tarifs indiqués donne le même résultat.
Ce que montre le tableau :
- Toutes les tâches ont été réussies. J’ai vérifié chaque résultat sur disque : sortie de FizzBuzz, tests pytest validés, nombre de mots du résumé conforme aux exigences, absence de noms obsolètes après le renommage.
- MiniMax s’est avéré environ 2× plus rapide que Kimi et 4× moins cher selon les prix catalogue (159,2 s contre 309,9 s ; 0,125 $ contre 0,531 $). Compte tenu des différences de réglages de réflexion et de fichiers de test, ce ratio de vitesse doit être considéré comme une indication approximative plutôt qu’une mesure précise.
- dsh sur V4-Flash a été environ 4,5× plus rapide que MiniMax et 11× moins cher pour ce type de tâches.
- Le cache joue un rôle crucial. MiniMax effectue 5,2 lectures du cache pour chaque jeton d’entrée non mis en cache. Aux prix catalogue, une lecture du cache coûte 80 % de moins qu’une entrée non mise en cache. Si ces jetons avaient été facturés comme entrées non mises en cache, le coût aurait atteint environ 0,34 $ au lieu de 0,125 $.
- Les nouvelles tentatives d’exécution ne sont pas incluses dans les totaux. Les douze exécutions du benchmark par MiniMax, y compris celles abandonnées, ont coûté 0,28 $ au prix catalogue et nécessité 321 secondes.
Le test du widget, et une correction
L’« test amusant » décrit dans l’article sur dsh consistait en un widget en pixel art représentant le logo de ce site, créé à partir d’un cahier des charges écrit (reproduit intégralement dans le concours) : il s’agissait d’un fichier ll-pixel-logo.js ne nécessitant aucune dépendance, capable de dessiner un anneau ainsi que deux « L » inclinés sur une grille 40×40, d’éloigner les pixels du pointeur de la souris, de se briser et de se reconstituer au clic, de respecter l’option prefers-reduced-motion, le tout accompagné d’une page de démonstration, d’un fichier README et d’un autotest. J’ai donné le même cahier des charges à Kimi, puis à MiniMax, tous deux via le même agent de travail. L’article sur Kimi décrit les trois tentatives effectuées par ce dernier ; la partie pertinente ici est la deuxième tentative, au cours de laquelle Kimi a généré un widget complet comptant 323 lignes, une page de démonstration, un README ainsi que deux fichiers de test, et les a placés dans l’espace de travail propre à l’agent de travail plutôt que dans le dossier que je surveillais. La réponse de Kimi s’est interrompue au bout de 15 minutes. Je pensais donc qu’il n’avait rien produit.
Une heure plus tard, MiniMax a reçu le même brief concernant le même travailleur : 59,3 secondes, 25 tours d’exécution, 24 appels d’outils, soit un coût de 0,13 $ au prix catalogue. Il a constaté que les fichiers de l’essai-2 de Kimi se trouvaient toujours dans cet espace de travail ; il les a tous les cinq lus, ainsi que le rapport d’exécution de Kimi, a exécuté les tests prévus par Kimi, puis a répondu : « J’ai construit et vérifié l’ensemble des widgets ». Or, MiniMax n’a jamais écrit une seule ligne de code relatif aux widgets. Les seuls fichiers qu’il a créés étaient son propre rapport d’exécution et son fichier d’état.
J’ai pris la réponse au pied de la lettre ; la première version de cet article présentait le fichier en tant que widget de MiniMax. Le journal de session montre la write de ce même fichier lors de la session « attempt-2 » de Kimi, et la copie sur ce site est identique octet par octet. Par conséquent, cet article ne présente aucun résultat lié au widget de MiniMax, et je n’ai pas relancé l’exécution de la tâche. Ce qu’il contient en revanche, c’est un exemple clair d’un agent qui déclare comme sien un travail qu’il a en réalité trouvé, d’où les vérifications décrites ci-dessous dans la section « pièges à éviter ».
Voici le widget, crédité correctement à la deuxième tentative de Kimi K3 :
prefers-reduced-motion.Sa géométrie : RING_R = 19.4, anneau intérieur à 0,82R, SHEAR = 0.42 (soit environ 22,8°), ainsi qu’un aide inL qui teste à la fois le pied et la tige déformée. L’évaluation de sa propriété isLit sur une grille 40×40 donne 602 cellules éclairées. Le showdown le place aux côtés des deux autres widgets.
Ce que j’ai re-vérifié sur le widget de la tentative 2
Exécutez le tout dans une copie temporaire du dossier contenant le widget ainsi que les deux fichiers de test écrits par Kimi :
$ wc -l ll-pixel-logo.js
323 ll-pixel-logo.js
$ node --check ll-pixel-logo.js && echo "syntax ok"
syntax ok
$ node test-bitmap.js | tail -1
ALL PASS
$ node test-smoke.js | tail -1
SMOKE PASS
test-bitmap.js effectue 18 vérifications : présence d’un anneau aux points cardinaux et absence aux coins ainsi qu’au centre ; chaque tige et pied du « L » se trouve dans son quadrant respectif ; vérification de la zone d’interlock, de la direction de l’inclinaison, et du nombre total de cellules allumées, qui doit être compris entre 540 et 670. test-smoke.js effectue 10 tests : montage du widget via un DOM simulé, remontage idempotent, utilisation de role="img" ainsi qu’un attribut aria-label ; 300 frames avec un déplacement du pointeur et deux clics (le second au milieu d’une animation) ; état fini des particules ; retour du logo à sa position initiale après les tests ; utilisation d’un buffer de 640 px avec un devicePixelRatio de 2 ; enfin, un appel propre à unmount(). Il s’agit des tests créés par Kimi ; ils ne constituent pas une vérification indépendante : Kimi a modifié test-bitmap.js après son premier exécution, en déplaçant les zones de détection et en fixant la plage du nombre de cellules allumées à 540–670 une fois que la valeur mesurée fut de 602, jusqu’à ce que tous les tests soient réussis. Un résultat positif ici indique simplement que le widget et ses tests sont cohérents, mais ne signifie pas que ces tests fixent un standard à respecter. Mon propre décompte donne 602 cellules allumées, réparties en 196 / 137 / 101 / 168 dans les quadrants supérieur-gauche, supérieur-droite, inférieur-gauche et inférieur-droite.
Pièges courants (ceux que j’ai réellement rencontrés)
- Les sessions persistantes gâchent les benchmarks. La commande
openclaw agent --agent worker -m "…"réutilise la session de l’agent sauf si vous spécifiez un nouveau--session-key. Lors de ma première exécution avec MiniMax, le test FizzBuzz a jugé que le fichier existait déjà et a refusé de l’écrire ; l’exécution de correction de bug a indiqué que les tests étaient déjà réussis ; enfin, l’exécution de synthèse a pris en compte le dossier de correction de bug issu de l’exécution Kimi plutôt que le sien. Un--session-keyunique par tâche a résolu le problème. - Les instructions permanentes du worker prennent le pas sur le prompt concernant l’emplacement des fichiers. Les instructions de mon agent worker stipulent qu’il doit placer les sorties longues dans son propre espace de travail ; cela a primé sur l’ordre "écrivez fizz.py dans ce dossier" à deux reprises. Dans la troisième exécution FizzBuzz, la réponse indiquait que le fichier avait été écrit dans le dossier temporaire ; en réalité, l’horodatage du fichier montre qu’il se trouve dans l’espace de travail. La quatrième exécution, avec un chemin absolu et une instruction explicite pour l’utiliser, s’est déroulée correctement.
- Un espace de travail partagé contamine la prochaine exécution. C’est ce qui s’est produit dans l’exemple ci-dessus. Une heure plus tard, les fichiers orphelins de Kimi étaient toujours présents dans l’espace de travail du worker, et MiniMax les a considérés comme siens. Il faut donc attribuer à chaque exécution un dossier vide, puis vérifier ce qu’elle a réellement écrit (horodatages, appels
writede la session) plutôt que ce qu’elle prétend avoir écrit. - Le catalogue indique 1 000 000 de tokens ; j’utilise 262 144. Il s’agit de mon propre réglage
contextTokens; le champagentMeta.contextTokensdans le fichier JSON confirme quel paramètre est effectivement utilisé. Augmentez cette valeur si vous avez vraiment besoin d’une fenêtre de contexte plus large. - Les montants en dollars indiqués dans le forfait sont fictifs, mais des fictions utiles. OpenClaw remplit
usage.cost.totalen se basant sur ses tarifs prédéfinis, quelle que soit la somme réellement payée ; c’est donc utile pour comparer les modèles, mais sans valeur en tant que facture.
Où cela me mène
Le modèle MiniMax M3 est le modèle principal utilisé par mon agent de traitement ; DeepSeek V4-Flash et V4-Pro servent de solutions de secours. Kimi K3 ne fait pas partie de cette chaîne de modèles ; je l’utilise ailleurs, pour mon agent d’analyse. Pour ces tâches, M3 a effectué le renommage en 89,9 secondes pour un coût de 0,058 $ au prix catalogue, tandis que Kimi a mis 128,9 secondes et coûté 0,180 $. Pour la correction de bugs, M3 a mis 41,0 secondes pour un coût de 0,025 $, contre 86,6 secondes et 0,114 $ pour Kimi. Le modèle dsh sur V4-Flash s’est avéré plus rapide et moins cher que les deux autres sur chaque tâche.
Pour le brief relatif au widget, je n’ai aucun résultat provenant de MiniMax. Si vous effectuez vous-même une comparaison similaire, créez un dossier vide pour chaque exécution et lisez les appels write de la session avant de consulter son rapport.
Voir aussi : Kimi K3 en tant qu’agent de programmation (la partie Kimi de cette comparaison), DeepSeek Harness (dsh) (les cinq tâches et le brief initial relatif au widget), Reasonix (évoqué dans d’autres articles ; retiré de mon système le 09/09/2026) ainsi que Le coût réel de mes agents IA.