MiniMax M3:一个 OpenClaw 编程智能体与 Kimi K3 和 dsh 的对比
- 发布日期
- 2026年9月12日
- 更新日期
- 2026年9月16日
- 作者
- Jacob Lloyd —— 项目完成后,在 AI 协助下撰写
- 阅读时长
- 约 21 分钟阅读
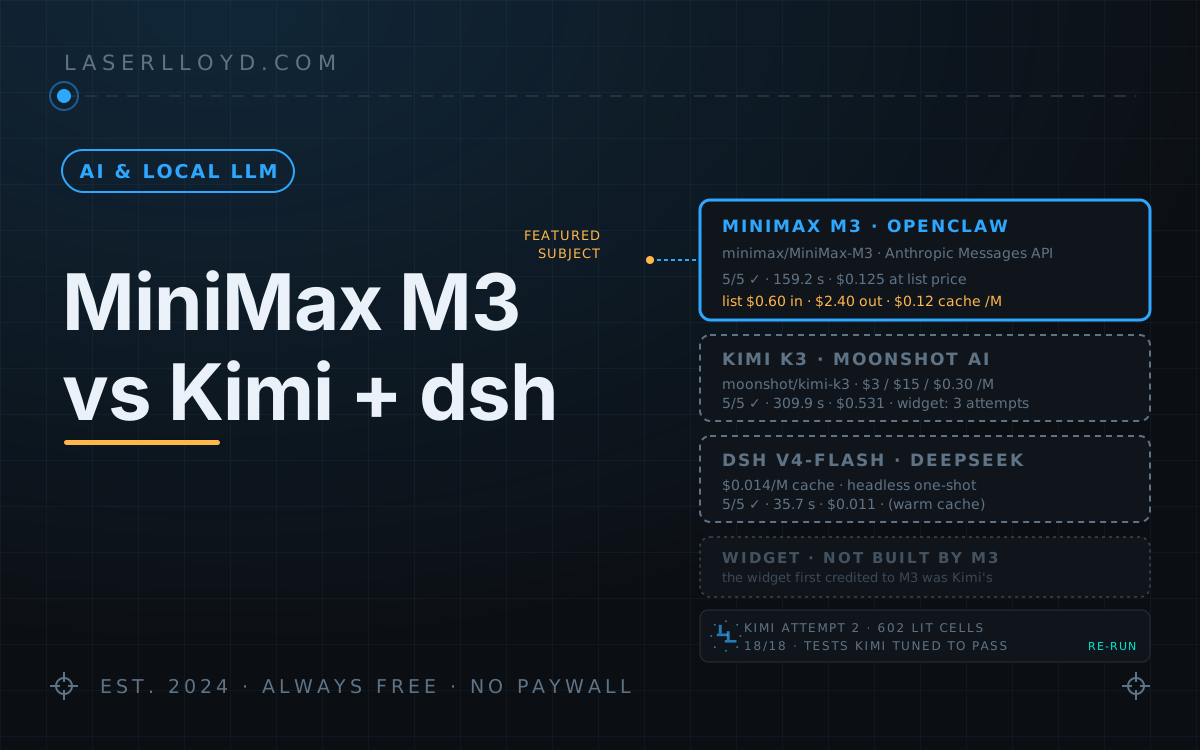
简单来说: 我将 MiniMax 的 M3 模型连接到 OpenClaw——也就是我的 AI 助手们所运行的框架上,然后给它布置了与当天早上我给 Moonshot 的 Kimi K3 相同的五项小型编程任务。它仅用了 Kimi 所需时间的一半左右便全部完成;不过 Kimi 当时被设置为尽最大努力去思考,且两次测试所使用的练习文件也各不相同,因此这只是一个大致的参考值。按官方定价计算,MiniMax 的费用大约只有 Kimi 的四分之一。由于我向 MiniMax 支付的是固定月费,上述费用数据仅作对比之用。我还打算比较一下两个模型各自是如何生成本网站标志的像素艺术版本的。原本我以为是 MiniMax 编写的代码模块,结果却是 Kimi 在第二次尝试时写出来的:MiniMax 的运行过程成功找到了 Kimi 生成的文件,对其进行了测试并确认其符合要求。
现在,MiniMax M3 正通过 OpenClaw 来运行我的工作代理程序。当天早上,我给了它与之前给 Kimi K3 相同的五项小型编程任务;结果它在大约 Kimi 所用时间的一半内完成了全部五项任务,而成本也仅为 Kimi 报价的四分之一左右。需要说明的是,这个速度对比只是大致参考值:Kimi 是以最大思考深度运行的,而 M3 则使用 OpenClaw 的默认设置;两次运行所用的测试文件也不相同,且 MiniMax 还经历了多次重试。我原本还打算比较两者如何根据同一份需求说明来生成本网站标志的像素艺术版本,不过这部分内容未能得到验证:最初被我认定为 MiniMax 生成的代码其实出自 Kimi 之手;而 MiniMax 在运行时读取到了 Kimi 的文件,并将其当作自己的成果上报了。具体细节如下——因为了解其运作机制才是本文最有价值之处。
简而言之
- 功能说明: MiniMax M3 通过内置的
minimax服务提供商来驱动 OpenClaw 自身的代理循环。该提供商调用的是 Anthropic Messages API,其端点为https://api.minimax.io/anthropic,并非类似 OpenAI 风格的接口。它不属于 Codex 范畴:OpenClaw 的 Codex 运行框架仅支持服务提供商标识为openai的请求。 - 配置方式: 所需密钥需通过环境变量
MINIMAX_API_KEY提供。此外,此处重要的配置项还包括模型覆盖设置(上下文长度上限为 262,144 个令牌,而系统目录允许的最大值为 1,000,000);工作代理使用的模型序列依次为:M3、DeepSeek V4-Flash 以及 V4-Pro。 - 基准测试: 共五项任务,每项任务均开启全新会话。MiniMax M3 在 159.2 秒内完成了全部五项任务;Kimi K3 则用了 309.9 秒;而基于 DeepSeek 的 dsh 工具借助 V4-Flash 也在 35.7 秒内达成相同成果。由于 Kimi 以最大思考深度运行、M3 采用默认设置,且各次测试所用文件不同、MiniMax 又需多次重试,上述时间比例仅作参考。
- 成本估算: 按照 OpenClaw 公布的定价标准,完成五项任务所需费用为 0.125 美元(计费规则为输入/输出各 0.60 美元/百万令牌,缓存读取费用为 0.12 美元/百万令牌)。该价格与 MiniMax 官方公布的标准费率相符(目前该服务享受半价优惠)。由于我订阅的是 MiniMax 的固定费率套餐——每月需支付约 60 美元含税费用——因此上述数值仅为标价参考值而非实际账单金额。Kimi 的费用则为 0.531 美元(计费规则为输入 3 美元/百万令牌、输出 15 美元/百万令牌、缓存读取 0.30 美元/百万令牌)。dsh 产生的费用仅为 0.011 美元。
- 代码生成结果: MiniMax 并未产生任何独立成果。此前被我标记为 M3 首次尝试生成的那个包含 323 行代码的模块,其实与 Kimi K3 在第二次尝试时写入共享文件夹的内容完全一致。MiniMax 在 59 秒的运行过程中读取了这些文件、重新执行了相关测试,最终回复称“已成功生成并验证”。
OpenClaw所使用的MiniMax服务提供商究竟是什么?
在之前的草稿中我搞错了,因此现在根据实际安装的代码以及我的配置来说明一下。
- 协议与端点。 随附的MiniMax插件在构建服务提供商时会设置
api: "anthropic-messages",基础URL为https://api.minimax.io/anthropic(通过变量MINIMAX_API_HOST可更改主机地址)。MiniMax还在https://api.minimax.io/v1下提供了与OpenAI兼容的API,但OpenClaw的插件并不会使用它。 - 可配置项。 几乎没有。我的
openclaw.json文件仅用于覆盖minimax服务提供商的模型列表;API类型、基础URL以及认证信息均由插件自动设定。MiniMax的中国地区服务则使用https://api.minimaxi.com/anthropic。 - 密钥设置。 通过环境变量来配置:插件会读取
MINIMAX_API_KEY(以及几个相关的令牌变体)。 - 模型相关设置。 插件目录中显示M3模型的上下文窗口大小为1,000,000个token,还有一个
compat设置项,即codeMode: "preferred"(这是OpenClaw的代码模式,与Codex无关)。该插件并未提供温度参数调节功能。 - 价格信息。 插件给出的M3模型定价为:输入费用0.60美元/百万token、输出费用2.40美元/百万token,缓存读取费用为0.12美元/百万token。这些数值会填入JSON中的
usage.cost.total字段。这些正是 MiniMax的按量付费页面 上针对输入token数量不超过512k时的标准费率。我在2026年9月16日查看时发现这些价格被划掉并打了五折(变为0.30美元/百万token、1.20美元/百万token及0.06美元/百万token);当输入token数量超过512k时,标准费率则会翻倍。本文中所列的费用均基于插件给出的数值,也就是未打折的标价。
并非 Codex
这是 OpenClaw 自身的代理循环机制,并非 OpenAI 的 Codex 应用服务器。虽然 OpenClaw 配备了 Codex 适配插件,但对于那些 ID 无法被规范化为 openai 的服务提供商而言,其路由检查功能 (configuredModelRouteNeedsCodex) 会返回 false;因此像 minimax/MiniMax-M3 这样的服务路径根本不符合条件。每次运行后生成的 JSON 数据都会标明实际运行的循环机制:agentHarnessId: "openclaw"。顺便一提,我的电脑上其实也并未安装 Codex 插件。
若想让 M3 服务通过 Codex 来调用,就需要借助类似 codex-router 这样的本地桥接工具;此外还需允许 Codex 插件共享我本地的 ~/.codex 配置目录,如此的话该机器上的所有代理程序都能共用此配置。不过我并未这么做。本文所描述的一切均属于 OpenClaw 的原生循环机制。
设置步骤
我使用的版本如下:
$ node -v
v24.18.0
$ openclaw --version
OpenClaw 2026.9.2 (3928bad)
$ dsh --version
0.1.1-rc.2步骤1:设置密钥
Minimax插件随OpenClaw 2026.9.2一同发布,在我的安装环境中该插件已启用。它会从 MINIMAX_API_KEY 这个环境变量中读取密钥,因此请将该变量值设置到您的网关运行环境所对应的配置中(比如 systemd的 EnvironmentFile、launchd的plist文件或Shell环境变量),随后执行 openclaw gateway restart 以重启网关。切勿直接将密钥值写入 openclaw.json 文件中。如果某个服务提供商的配置项需要指定该密钥,请填写引用形式 "${MINIMAX_API_KEY}",而非实际的密钥值。
步骤2:将工作节点指向M3
openclaw.json文件中包含两部分内容。首先是代理的模型链配置:
"agents": { "entries": { "worker": { "model": {
  "primary": "minimax/MiniMax-M3",
  "fallbacks": ["deepseek/deepseek-v4-flash", "deepseek/deepseek-v4-pro"]
} } } }
其次,可选地,还可以对模型行设置使用限制。这是我自己配置文件中的示例。其中没有 api、baseUrl 或 apiKey 这些字段,因为它们均由插件提供:
"models": { "providers": { "minimax": { "models": [ {
  "id": "MiniMax-M3", "name": "MiniMax M3",
  "reasoning": true, "input": ["text", "image"],
  "contextWindow": 1000000, "contextTokens": 262144, "maxTokens": 128000,
  "compat": { "codeMode": "preferred" }
} ] } } }
我选择完整复制插件的模型配置项,而非仅添加其中一个键。因为之前在这个配置框中仅做了部分覆盖后,系统悄悄移除了 reasoning: true 这一设置,导致M3在数天内都处于无推理模式运行的状态。所设置的限制值为262,144:在整个包含100万个条目的目录中,只有这么多条目会被处理,从而确保长时间运行的工作节点不会占用过多资源。
步骤3:冒烟测试
这是基准测试中的PONG任务,我提取出了自己关心的相关字段:
$ openclaw agent --agent worker --model minimax/MiniMax-M3 \
    --session-key agent:worker:bench-pong-1 \
    -m "Reply with exactly: PONG." --json \
  | jq '{harness: .result.meta.agentMeta.agentHarnessId,
         provider: .result.meta.executionTrace.winnerProvider,
         model: .result.meta.executionTrace.winnerModel,
         contextTokens: .result.meta.agentMeta.contextTokens,
         usage: (.result.meta.agentMeta.usage | {input, output, cacheRead, cost: .cost.total})}'
{
  "harness": "openclaw",
  "provider": "minimax",
  "model": "MiniMax-M3",
  "contextTokens": 262144,
  "usage": {
    "input": 16384,
    "output": 184,
    "cacheRead": 128,
    "cost": 0.01028736
  }
}
harness: "openclaw" 即原生循环机制。winnerModel 则指明了最终被选中的模型,而非备用模型。contextTokens 表明相关限制确实发挥了作用。那16,384个未经缓存的输入标记大多是新会话在第一轮交互时发送的系统提示与工具定义信息,正因如此即便是PONG任务也并非免费。此处的费用指的是插件的标价,而非套餐计划的统一收费标准。
并列对比:MiniMax M3、Kimi K3与dsh
其中两个模型是用于驱动 OpenClaw 循环系统的核心组件。第三个则是 DeepSeek Harness (dsh),它是 DeepSeek 自主研发的编码工具,拥有独立的运行循环机制。本系列之前的文章中还曾出现过关于 Reasonix 的介绍;不过我从未对 Reasonix 进行过无界面模式的基准测试,且已于 2026年9月9日将其从我的测试环境中移除,因此它并未出现在本次对比中。
| OpenClaw 中的 MiniMax M3 | OpenClaw 中的 Kimi K3 | dsh | |
|---|---|---|---|
| 提供方 | MiniMax | Moonshot AI | DeepSeek、麻省理工学院 |
| 连接方式 | 内置 minimax 插件;通过 api.minimax.io/anthropic 调用 Anthropic Messages API | moonshot 服务提供程序;通过 api.moonshot.ai/v1 调用 OpenAI 聊天接口 | 自带命令行工具与网页界面 |
| 从脚本中调用方式 | openclaw agent --agent X --model minimax/MiniMax-M3 -m "…" --json | openclaw agent --agent X --model moonshot/kimi-k3 -m "…" --json | dsh --profile headless "…" |
| 模型切换方式 | 修改 openclaw.json 文件中的 model 参数即可 | 同上 | 编辑 ~/.dsh/settings.yaml 文件 |
| 五项任务基准测试结果 | 5/5,耗时159.2秒,成本0.125美元(按官方定价计算) | 5/5,耗时309.9秒,成本0.531美元 | 5/5,耗时35.7秒,成本仅0.011美元(缓存已预热的情况下) |
| 像素艺术小部件生成测试 | 无自带小部件生成功能(详见下文) | 共尝试三次:第一次未生成任何代码;第二次生成的完整代码被误存至错误文件夹,且在15分钟后中断;第三次则使用了更严格的提示词,最终生成了包含397行代码的完整小部件 | 共尝试两次;第二次耗时25分钟,成本约为49美分 |
| 版本信息 | OpenClaw 2026.9.2 | OpenClaw 2026.9.2 | 0.1.1-rc.2,开发者预览版 |
基准测试:五项任务
这五项任务均取自 dsh 文章中的示例:回复“PONG”;编写并运行 FizzBuzz程序;在不修改测试代码的前提下修复两个 Bug以使单元测试通过;用150字以内总结一个由六个模块构成的代码库;跨多个文件及测试代码重命名某个函数并验证测试仍能通过。这三次测试均于2026年9月11日执行。Kimi 使用了 --thinking max 模式,MiniMax 则采用 OpenClaw默认的自适应思考模式;dsh提供的数据则是缓存预热后的重新运行结果。
以下为各次测试间的差异:
- 思考设置不同。 Kimi 使用了最大思考时间设置,而 MiniMax 则使用默认设置。Kimi 所使用的额外时间是我特意为其设置的。
- 使用的测试文件不同。 每次运行都会生成独立的临时文件夹。在修复 Bug的任务中,两者修复的Bug也不相同(Kimi:修复了某个模块中的
add与is_even两个错误;MiniMax则修复了add和subtract)。在重命名任务中,两者重命名的函数也不同(Kimi:将calculate_total更名为compute_total,涉及三个模块及一个测试文件;MiniMax则将area_of_rect更名为rect_area,同样涉及三个模块及一个测试文件)。整体结构相似,但具体文件内容不同。 - 存在重试情况。 MiniMax第一次运行时试图通过同一个会话完成全部五项任务,结果出现了一些典型的错误现象(详见“注意事项”部分),因此我随后使用全新的会话密钥重新执行了所有任务。FizzBuzz程序又经历了两次重试——因为系统始终将生成的
fizz.py文件写入自身工作目录而非临时文件夹。表格中展示的是第四次运行的结果。Kimi的FizzBuzz与修复Bug的任务同样经过重新执行:第一次运行FizzBuzz时因速率限制而中断;第一次修复Bug任务则发现相关文件早已被之前的运行修正完毕。
| 任务 | MiniMax M3 | Kimi K3 | dsh V4-Flash(缓存预热后) |
|---|---|---|---|
| 回复“PONG” | ✅ 7.2秒 · 1轮对话 | ✅ 6.1秒 · 1轮对话 | ✅ 1.7秒 |
| 编写并运行FizzBuzz程序 | ✅ 12.1秒 · 3轮对话,调用2次工具 | ✅ 22.8秒 · 3轮对话,调用2次工具 | ✅ 5.3秒 |
| 修复两个Bug且保持测试代码不变 | ✅ 41.0秒 · 8轮对话,调用8次工具 | ✅ 86.6秒 · 7轮对话,调用6次工具 | ✅ 11.3秒 |
| 用150字以内总结六个模块的功能 | ✅ 9.1秒 · 3轮对话,调用3次工具(共84个单词) | ✅ 65.5秒 · 5轮对话,调用10次工具 | ✅ 5.1秒 |
| 跨多个文件及测试代码重命名函数 | ✅ 89.9秒 · 14轮对话,调用22次工具 | ✅ 128.9秒 · 10轮对话,调用9次工具 | ✅ 12.3秒 |
| 总耗时 | 159.2秒 | 309.9秒 | 35.7秒 |
| Token使用量:未缓存输入 / 输出 / 缓存读取 | 87.4k / 456.7k / 7.6k | 91.5k / 355.3k / 10.0k(其中4.1k为推理过程所用) | 6.1k / 147.3k / 4.7k(其中2.0k为推理过程所用) |
| 每单位未缓存输入Token对应的缓存读取次数 | 5.2次 | 3.9次 | 24次 |
| 费用 | $0.125:按每百万Token计费,价格分别为$0.60、$2.40与$0.12(此为官方定价;我使用的是固定套餐) | $0.531:按每百万Token计费,价格分别为$3、$15与$0.30 | $0.011:按每百万Token计费,价格分别为$0.44、$1.32与$0.014 |
上述费用均按每百万Token计算,顺序依次为未缓存输入、输出及缓存读取。各任务的实际费用即 usage.cost.total 数值之和;将Token使用总量乘以对应费率后得出的结果也与该数值相符。
表格所反映的信息如下:
- 所有任务均成功完成。 我逐一检查了磁盘上的输出结果:FizzBuzz程序的输出正常、单元测试全部通过、摘要的单词数符合要求,重命名后也没有出现任何遗留的旧函数名。
- MiniMax的速度约为Kimi的两倍,按官方定价计算其费用也仅为Kimi的四分之一左右(耗时分别为159.2秒与309.9秒;费用则分别为$0.125与$0.531)。鉴于两者在思考设置及测试文件方面存在差异,此速度比仅可作为大致参考,不宜视作精确数值。
- 使用V4-Flash的dsh在这类任务上的表现更为出色:其速度约为MiniMax的4.5倍,费用也仅为后者的约1/11。
- 缓存机制起到了关键作用。 MiniMax每处理一个未缓存的输入Token便会从缓存中读取5.2个Token。按官方定价计算,缓存读取的成本比直接处理未缓存输入要低80%。若将这些Token视作未缓存输入来计算,其费用本应达到约$0.34,而非现在的$0.125。
- 重试产生的费用并未计入总账。 实际上MiniMax共进行了十二次基准测试,即便那些失败或作废的测试也算在内,最终总费用也仅为$0.28、总耗时321秒。
小部件测试,以及一处修正
那篇关于 dsh 的文章中提到的“趣味测试”其实是一个用像素画形式呈现的网站标志小工具。该测试基于一份书面需求说明来设计(该说明全文可见于这篇文章中):这个工具不依赖任何外部库,仅由一个名为 ll-pixel-logo.js 的文件构成;它能在 40×40 的网格上绘制出一个圆环以及两个倾斜的“L”形图案,还能让像素点随鼠标移动而分散开来,点击后又能重新组合成原图案。该工具还兼容 prefers-reduced-motion 设置。此外还有演示页面、README 文档以及自我测试功能。我把同样的需求说明分别发给了 Kimi 和 MiniMax,它们都是在同一个工作代理上运行的。
关于 Kimi 的那篇文章记述了 Kimi 的三次尝试;对我们而言重要的是第二次尝试。那次尝试最终生成了一个包含 323 行代码的完整小工具,还有演示页面、README 文档以及两个测试文件。这些内容被保存在工作代理自身的工作区中,而非我监控的那个文件夹里。不过该过程在运行了15分钟后便中断了,我以为它什么都没生成呢。
一小时后,MiniMax收到了关于同一名工作者的相同任务说明:耗时59.3秒、执行了25轮操作、调用了24次工具,按标价计算费用仅为0.13美元。它发现Kimi留下的两个尝试版本文件仍保存在工作区中,于是读取了全部五个文件以及Kimi的运行报告,随后运行了Kimi的测试程序,并回复称:“已成功构建并验证了整套控件”。但实际上它一行控件代码都没写。它仅生成了自己的运行报告和状态文件而已。
我直接相信了对方的回复。本文的最初版本中,该文件被显示为 MiniMax 的小部件。会话日志显示,在 Kimi 的“尝试-2”会话中确实有对该文件的 write操作,而本网站上的文件内容与原始文件完全一致。因此,这篇文章中并没有出现 MiniMax 的小部件结果,我也没有重新执行相关测试。不过文中倒是有一个很好的示例:某个智能体将它发现的工作成果误当作自己的成果来报告。正因如此,下文才列出了一些需要注意的要点。
这就是那个小部件,它确实是Kimi K3第二次尝试的成果:
prefers-reduced-motion 设置。其几何参数如下:RING_R = 19.4,内环位于0.82R处,SHEAR = 0.42(约22.8°)。还有一个名为 inL 的辅助工具,用于同时测试脚部与发生剪切变形的茎部。在40×40的网格上对 isLit 参数进行评估后,共有 602个被点亮的单元格。这场对决中,该部件与其他两个部件同台竞技。
我在第二次测试中重新检查了哪些内容
请在包含该小部件以及Kimi编写的两个测试文件的文件夹副本中运行测试:
$ wc -l ll-pixel-logo.js
323 ll-pixel-logo.js
$ node --check ll-pixel-logo.js && echo "syntax ok"
syntax ok
$ node test-bitmap.js | tail -1
ALL PASS
$ node test-smoke.js | tail -1
SMOKE PASS
test-bitmap.js 进行了18项检查:确认环形图案出现在四个主要位置,而在角落和中心则不存在;每个“L”形图案的竖杆与横杠都位于各自对应的象限内;还检查了互锁区域、倾斜方向,以及被点亮的像素总数是否在540到670之间。test-smoke.js 则进行了10项检查:包括DOM模拟挂载、可重复多次的重新挂载操作、role="img"属性与aria-label的设置、300帧动画过程中指针的移动及两次点击(第二次点击发生在动画进行中)、粒子状态的稳定性、动画结束后Logo能否正常复位、在devicePixelRatio为2的情况下是否生成了640像素大小的缓冲存储区,以及是否能顺利执行unmount()操作。这些均为Kimi自行编写的测试,但它们并不能作为独立的验证手段:Kimi在首次运行test-bitmap.js后对其进行了修改,调整了检测区域的位置,并在测得被点亮像素数为602之后,将判定范围设定为540–670。此次测试通过仅能说明小部件与测试程序结果一致,并不能证明这些测试本身具有权威性。我自己的统计结果为:共有602个像素被点亮,具体分布为左上、右上、左下和右下四个象限分别有196、137、101和168个。
注意事项(我实际遇到过的问题)
- 持久化会话会破坏基准测试。 执行
openclaw agent --agent worker -m "…"时,除非指定新的--session-key,否则系统会复用同一会话。我第一次运行 MiniMax 时,FizzBuzz 测试判定相关文件已存在因而拒绝写入;修复 bug 的测试则显示所有测试均已通过;而生成摘要的测试又错误地使用了 Kimi 的修复后文件。为每项任务指定唯一的--session-key即可解决此问题。 - 工作节点的预设指令优先级高于提示内容。 我的工作节点代理被设定为将较长的输出结果存入其专属工作区,这一设定两次覆盖了“将 fizz.py 写入当前文件夹”的指令。第三次 FizzBuzz 测试回复称文件已写入临时文件夹,但文件时间戳却显示其位于工作区中;第四次测试则因使用了绝对路径与明确指令而成功写入。
- 共享工作区会导致后续运行出错。 即前文提到的案例:Kimi 生成的孤立文件一小时后仍存在于工作节点的工作区中,MiniMax 误将其视为自己的文件。务必为每次运行创建独立空文件夹,并依据时间戳及会话中的
write调用记录来核查实际写入内容,而非仅依赖程序的自述信息。 - 系统显示最大令牌量为1,000,000,但我仅使用了262,144个。 该数值由我自定义的
contextTokens参数决定;JSON配置中的agentMeta.contextTokens也印证了当前生效的设置值。若确实需要更长的上下文窗口,可相应调高此数值。 - 固定套餐下的费用估算虽为虚拟数据,却颇具参考价值。 OpenClaw 会根据内置定价表计算
usage.cost.total的值,该数值虽不代表实际支付金额,却能有效辅助模型间的横向对比。
这样的结果对我意味着什么
在我的工作代理系统中,MiniMax M3是主要使用的模型;DeepSeek V4-Flash和V4-Pro则作为备用模型。Kimi K3并未被纳入这个使用链中——我将其用于其他场景,比如我的代码审查代理。在这些任务中,M3仅用89.9秒便完成了重命名操作,按标价计算成本为0.058美元;而Kimi则需128.9秒,成本达0.180美元。在修复Bug的任务上,M3耗时41.0秒、成本0.025美元;相比之下Kimi需要86.6秒且成本高达0.114美元。而在所有任务中,基于V4-Flash运行的dsh不仅速度更快,成本也更低。
至于那个小工具开发任务,我暂时没有得到MiniMax的处理结果。如果您打算自行进行类似对比测试,请为每次运行创建一个空文件夹,并在查看报告前先检查一下该会话中的write操作记录。
相关链接:作为代码编写代理的Kimi K3(本次对比中的Kimi部分)、DeepSeek测试工具包(dsh)(包含五项测试任务及原始需求说明)、Reasonix(曾在早期文章中与之对比;该模型已于2026年9月9日从我的系统中停用),以及我的AI代理实际产生的成本:DeepSeek与大型API的对比。