MiniMax M3: Un agente de programación OpenClaw frente a Kimi K3 y dsh
- Categoría
- IA y LLM Local
- Publicado
- 12 septiembre 2026
- Actualizado
- 16 septiembre 2026
- Por
- Jacob Lloyd — escrito con ayuda de IA, después del proyecto
- Tiempo de lectura
- 20 min de lectura
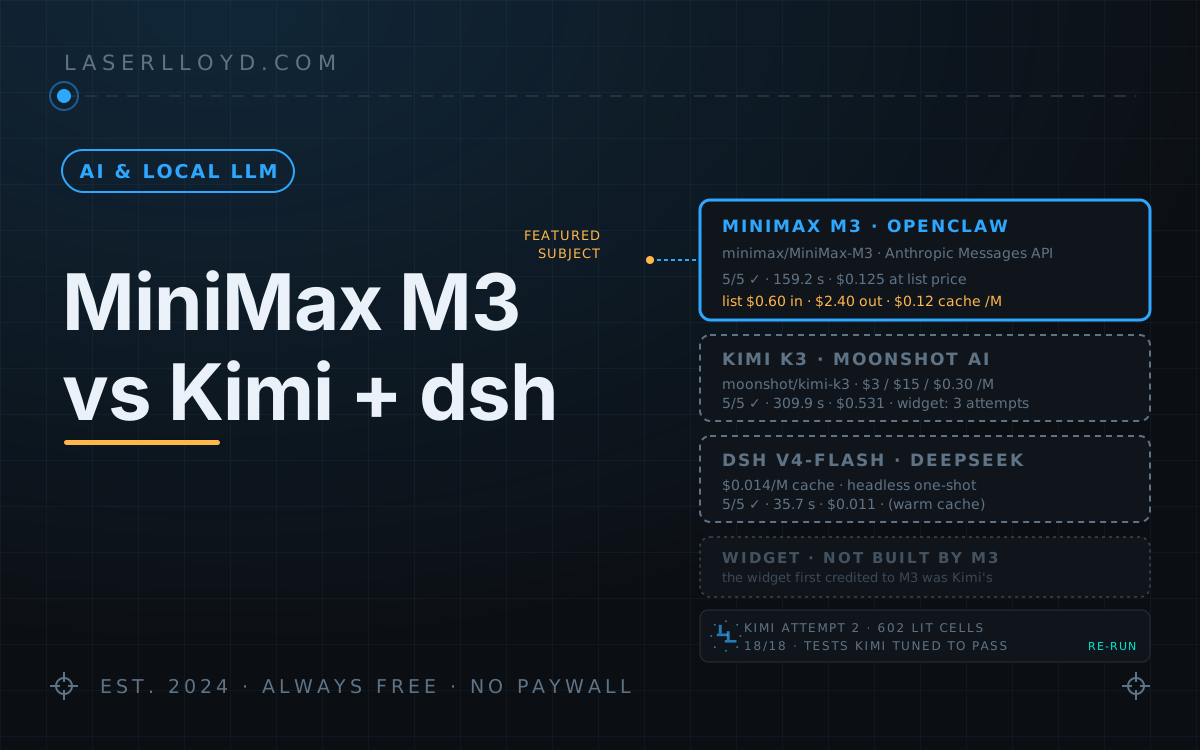
En palabras simples: Conecté el modelo M3 de MiniMax a OpenClaw, el marco de trabajo en el que se ejecutan mis ayudantes de IA, y le asigné las mismas cinco tareas de programación que había dado anteriormente ese mismo día al Kimi K3 de Moonshot. El modelo de MiniMax completó todas las tareas en aproximadamente la mitad del tiempo que tardó Kimi; no obstante, Kimi estaba configurado para esforzarse al máximo y además se utilizaron archivos de práctica diferentes en ambas ejecuciones, por lo que esta cifra es solo una referencia aproximada. A precios de lista, MiniMax habría costado aproximadamente una cuarta parte de ese monto. Yo pago a MiniMax una tarifa mensual fija; por eso esas cifras en dólares sirven únicamente como comparación. También quería comparar cómo cada modelo generaba una versión de pixel art del logotipo de este sitio web. El widget que inicialmente atribuí a MiniMax resultó ser uno que Kimi había creado en su segundo intento: la ejecución de MiniMax encontró los archivos de Kimi, los probó y reportó que se habían generado correctamente.
Ahora, MiniMax M3 ejecuta mi agente de trabajo en OpenClaw. Le asigné las mismas cinco tareas de programación que había dado anteriormente a Kimi K3; MiniMax completó todas ellas en aproximadamente la mitad del tiempo que tardó Kimi, y por un costo de apenas una cuarta parte del precio establecido para Kimi. Hay que tomar esta relación de velocidad como orientativa: Kimi operó en modo de razonamiento máximo, mientras que M3 utilizó la configuración predeterminada de OpenClaw; además, se usaron archivos de prueba diferentes y MiniMax necesitó varios intentos para finalizar las tareas. También quería comparar cómo ambos agentes generaban una versión en pixel art del logotipo de este sitio a partir de la misma descripción escrita; sin embargo, esa parte no se pudo verificar: el “widget” que inicialmente atribuí a MiniMax fue creado por Kimi, y la ejecución de MiniMax encontró esos archivos e informó que eran obra suya. Los detalles se exponen a continuación, ya que el modo en que ocurrió esto es lo más relevante del artículo.
Resumen rápido
- ¿Qué es? MiniMax M3 controla el bucle de ejecución de agentes de OpenClaw mediante el proveedor
minimaxincluido. Dicho proveedor utiliza la Anthropic Messages API enhttps://api.minimax.io/anthropic, no un endpoint estilo OpenAI. No se trata de Codex: el sistema Codex de OpenClaw solo acepta proveedores cuyo nombre seaopenai. - Configuración: la clave API se obtiene de la variable de entorno
MINIMAX_API_KEY. Además, los parámetros relevantes son el modelo seleccionado (el contexto máximo permitido es de 262.144 tokens, dentro del límite total de 1.000.000 del catálogo) y la cadena de modelos a utilizar: primero M3, luego DeepSeek V4-Flash y finalmente V4-Pro. - Pruebas de rendimiento: cinco tareas, cada una en una sesión nueva. MiniMax M3 completó las cinco en 159,2 segundos; Kimi K3 tardó 309,9 segundos; el sistema DeepSeek (dsh) con V4-Flash lo hizo en 35,7 segundos. Como se mencionó, las condiciones de ejecución fueron distintas entre ambos agentes, por lo que estos tiempos deben interpretarse como valores aproximados.
- Costo: $0,125 para las cinco tareas realizadas por MiniMax, según los precios oficiales de OpenClaw ($0,60 por entrada / $2,40 por salida / $0,12 por millón de tokens leídos del caché). Estos valores coinciden con la tarifa estándar publicada por MiniMax (actualmente con un descuento del 50%). Yo cuento con el plan de suscripción plana de MiniMax (aproximadamente $60 mensuales, impuestos incluidos), así que esta cifra representa el costo teórico, no el cobro real. Para Kimi: $0,531, según tarifas de $3 por entrada / $15 por salida / $0,30 por millón de tokens. En el caso de dsh: $0,011.
- El “widget”: MiniMax no generó ningún resultado propio. El widget de 323 líneas que había identificado como primer intento de M3 es, byte por byte, idéntico al creado por Kimi K3 en su segundo intento; ambos archivos se encontraban en una carpeta compartida. La ejecución de MiniMax, que duró 59 segundos, leyó dichos archivos, volvió a ejecutar sus pruebas y respondió: “Construido y verificado”.
¿Qué es realmente el proveedor minimax de OpenClaw?
En un borrador anterior me equivoqué, así que aquí está la información basada en el código instalado y en mi propia configuración.
- Protocolo y endpoint. El plugin minimax incluido configura sus proveedores con
api: "anthropic-messages"y la URL basehttps://api.minimax.io/anthropic(una variable llamadaMINIMAX_API_HOSTpermite cambiar el host). MiniMax también ofrece una API compatible con OpenAI enhttps://api.minimax.io/v1, pero el plugin de OpenClaw no la utiliza. - Qué se puede configurar. Muy poco. Mi archivo
openclaw.jsonsolo sobrescribe la lista de modelos del proveedorminimax; el tipo de API, la URL base y la autenticación provienen todos del propio plugin. La región de China de MiniMax utilizahttps://api.minimaxi.com/anthropic. - La clave de acceso. Se trata de una variable de entorno: el plugin lee
MINIMAX_API_KEY(así como algunas variantes relacionadas con los planes de uso). - Configuraciones del modelo. El catálogo del plugin asigna al modelo M3 una ventana de 1,000,000 de tokens y un único ajuste
compat, concretamentecodeMode: "preferred"(se trata del Modo Código de OpenClaw; no guarda relación con Codex). No existe ningún parámetro para ajustar la temperatura. - Precios. El plugin fija el precio del modelo M3 en $0.60 por cada millón de tokens ingresados, $2.40 por cada millón de tokens generados y $0.12 por cada millón de tokens leídos desde la caché; estos valores son los que llenan el campo
usage.cost.totalen el JSON resultante. Esas son las tarifas estándar indicadas en la página de precios de pago por uso de MiniMax para solicitudes de hasta 512,000 tokens de entrada. El 16 de septiembre de 2026 dicha página mostraba esos precios tachados y con un descuento del 50% ($0.30 / $1.20 / $0.06); además, para solicitudes con más de 512,000 tokens de entrada las tarifas se duplican. Los costos mencionados en este artículo siguen los valores indicados por el plugin, es decir, los precios sin descuento.
No es Codex
Se trata del bucle de agentes propio de OpenClaw, no del servidor de aplicaciones Codex de OpenAI. OpenClaw cuenta con un plugin de integración con Codex; sin embargo, su verificación de rutas (configuredModelRouteNeedsCodex) devuelve false para cualquier proveedor cuyo ID no se normalice a openai. Por eso, una ruta como minimax/MiniMax-M3 nunca cumple los requisitos. El JSON generado en cada ejecución indica qué bucle se utilizó: agentHarnessId: "openclaw". De todos modos, el plugin de Codex no está instalado en mi sistema.
Para utilizar M3 mediante Codex sería necesario emplear un puente local como codex-router, además de permitir que el plugin de Codex comparta mi directorio ~/.codex, el cual sería compartido por todos los agentes del sistema. No he hecho nada de eso. Todo lo descrito en este artículo corresponde al bucle nativo de OpenClaw.
Configuración
Las versiones que utilicé:
$ node -v
v24.18.0
$ openclaw --version
OpenClaw 2026.9.2 (3928bad)
$ dsh --version
0.1.1-rc.2Paso 1: la clave
El plugin minimax se incluye en OpenClaw 2026.9.2 y está habilitado en mi instalación. Este plugin lee la clave desde MINIMAX_API_KEY; por lo tanto, indíquela en el entorno donde se ejecuta su gateway (ya sea mediante un archivo EnvironmentFile de systemd, un archivo plist de launchd o su shell). Luego, reinicie el gateway con el comando openclaw gateway restart. No pegue la clave directamente en openclaw.json. Si en alguna fila del proveedor es necesario indicar el nombre de la clave, escriba la referencia "${MINIMAX_API_KEY}", no el valor real de la clave.
Paso 2: apuntar un agente trabajador a M3
Hay dos partes en el archivo openclaw.json. Primero, la cadena de modelos del agente:
"agents": { "entries": { "worker": { "model": {
  "primary": "minimax/MiniMax-M3",
  "fallbacks": ["deepseek/deepseek-v4-flash", "deepseek/deepseek-v4-pro"]
} } } }
Luego, opcionalmente, un límite de contexto para la fila del modelo. Este es el fragmento de mi propia configuración. No contiene api, baseUrl ni apiKey, ya que estos datos provienen del plugin:
"models": { "providers": { "minimax": { "models": [ {
  "id": "MiniMax-M3", "name": "MiniMax M3",
  "reasoning": true, "input": ["text", "image"],
  "contextWindow": 1000000, "contextTokens": 262144, "maxTokens": 128000,
  "compat": { "codeMode": "preferred" }
} ] } } }
Repito todo el fragmento de configuración del plugin en lugar de añadir solo esa clave, porque una sobrescritura parcial en este equipo hizo que se eliminara silenciosamente reasoning: true, lo que causó que M3 funcionara sin capacidad de razonamiento durante días. El límite en cuestión: 262,144 de los 1,000,000 totales del catálogo; esto mantiene las sesiones largas de los agentes trabajadores bajo control, evitando que crezcan sin límite.
Paso 3: prueba de verificación
Esta es la tarea PONG del conjunto de pruebas; aquí se muestran los campos que me interesan:
$ openclaw agent --agent worker --model minimax/MiniMax-M3 \
    --session-key agent:worker:bench-pong-1 \
    -m "Reply with exactly: PONG." --json \
  | jq '{harness: .result.meta.agentMeta.agentHarnessId,
         provider: .result.meta.executionTrace.winnerProvider,
         model: .result.meta.executionTrace.winnerModel,
         contextTokens: .result.meta.agentMeta.contextTokens,
         usage: (.result.meta.agentMeta.usage | {input, output, cacheRead, cost: .cost.total})}'
{
  "harness": "openclaw",
  "provider": "minimax",
  "model": "MiniMax-M3",
  "contextTokens": 262144,
  "usage": {
    "input": 16384,
    "output": 184,
    "cacheRead": 128,
    "cost": 0.01028736
  }
}
harness: "openclaw" representa el bucle nativo. winnerModel indica cuál es el modelo que respondió, en lugar de un modelo alternativo. contextTokens muestra que el límite de tokens se aplicó efectivamente. Los 16,384 tokens de entrada no almacenados en caché corresponden mayormente al prompt del sistema y a las definiciones de herramientas que una sesión nueva envía en su primera interacción; por eso incluso la tarea PONG conlleva un costo. Este costo corresponde al precio listado del plugin, no a lo que cobra un plan de tarifa plana.
Comparativa: MiniMax M3, Kimi K3 y dsh
Dos de estos modelos son los que impulsan el bucle de ejecución de OpenClaw. El tercero, DeepSeek Harness (dsh), es el propio agente de programación desarrollado por DeepSeek, con su propio bucle de ejecución. En artículos anteriores de esta serie también aparecía una columna correspondiente a Reasonix. Nunca realicé pruebas de rendimiento con Reasonix en modo headless, y lo retiré de mi configuración el 2026-09-09; por eso no figura aquí.
| MiniMax M3 en OpenClaw | Kimi K3 en OpenClaw | dsh | |
|---|---|---|---|
| Proveedor | MiniMax | Moonshot AI | DeepSeek, MIT |
| Forma de conexión | Plugin minimax incluido; API de mensajes de Anthropic en api.minimax.io/anthropic | Proveedor moonshot; API de completado de chat de OpenAI en api.moonshot.ai/v1 | Su propia CLI y interfaz web |
| Invocación desde un script | openclaw agent --agent X --model minimax/MiniMax-M3 -m "…" --json | openclaw agent --agent X --model moonshot/kimi-k3 -m "…" --json | dsh --profile headless "…" |
| Cambio de modelo | El parámetro model del agente en el archivo openclaw.json | Lo mismo | ~/.dsh/settings.yaml |
| Prueba de rendimiento (5 tareas) | 5/5, 159,2 s, $0,125 según precio listado | 5/5, 309,9 s, $0,531 | 5/5, 35,7 s, $0,011 (caché ya caliente) |
| Instrucciones para crear un widget de arte pixelado | No dispone de widget propio (véase más abajo) | Tres intentos: ningún código de widget; un widget completo en la carpeta incorrecta, interrumpido a los 15 minutos; un widget de 397 líneas generado con un prompt más estricto | Dos intentos; el segundo tomó 25 minutos y costó unos 49 centavos |
| Versión | OpenClaw 2026.9.2 | OpenClaw 2026.9.2 | 0.1.1-rc.2, versión preliminar para desarrolladores |
El benchmark: cinco tareas
Las cinco tareas son las mismas que en el artículo de dsh: responder “PONG”; escribir y ejecutar FizzBuzz; corregir dos errores para que las pruebas unitarias pasen sin tocarlas; resumir un código compuesto por seis módulos en menos de 150 palabras; renombrar una función en varios archivos y pruebas, y verificar que estas últimas sigan pasando. Las tres ejecuciones se realizaron el 11-09-2026. Kimi operó con --thinking max; MiniMax utilizó el modo de pensamiento adaptativo predeterminado de OpenClaw; los datos de dsh corresponden a una reejecución con caché ya caliente.
Lo que no fue igual en las ejecuciones:
- Configuraciones de pensamiento distintas. Kimi con el máximo nivel, MiniMax con la configuración por defecto. Parte del tiempo adicional de Kimi se debió a la profundidad de razonamiento que solicité.
- Archivos de prueba diferentes. Cada ejecución generó sus propias carpetas temporales. En la tarea de corrección de errores se arreglaron errores distintos (Kimi:
addeis_evenen un módulo; MiniMax:addysubtract). En la tarea de renombrado se cambiaron nombres distintos (Kimi:calculate_totalpasó a sercompute_totalen tres módulos y un archivo de pruebas; MiniMax:area_of_rectse renombró comorect_areaen idénticas ubicaciones). Las estructuras son similares, pero los archivos no coinciden. - Reintentos. La primera ejecución de MiniMax empleó una misma sesión persistente para las cinco tareas y falló de forma instructiva (véanse las “Pitfalls”), por lo que volví a ejecutarlas todas usando claves de sesión nuevas. FizzBuzz requirió dos intentos adicionales, pues el sistema seguía guardando
fizz.pyen su propio espacio de trabajo en lugar de en la carpeta temporal. La tabla muestra el cuarto intento de ejecución de FizzBuzz. Asimismo, Kimi volvió a ejecutar FizzBuzz y la corrección de errores: el primer intento de FizzBuzz terminó con un mensaje de límite de uso, y el primer intento de corrección indicó que el archivo ya había sido modificado en una ejecución previa.
| Tarea | MiniMax M3 | Kimi K3 | dsh V4-Flash (caché caliente) |
|---|---|---|---|
| Responder “PONG” | ✅ 7,2 s · 1 turno | ✅ 6,1 s · 1 turno | ✅ 1,7 s |
| Escribir y ejecutar FizzBuzz | ✅ 12,1 s · 3 turnos, 2 llamadas a herramientas | ✅ 22,8 s · 3 turnos, 2 llamadas a herramientas | ✅ 5,3 s |
| Corregir 2 errores sin tocar las pruebas | ✅ 41,0 s · 8 turnos, 8 llamadas a herramientas | ✅ 86,6 s · 7 turnos, 6 llamadas a herramientas | ✅ 11,3 s |
| Resumir 6 módulos (<150 palabras) | ✅ 9,1 s · 3 turnos, 3 llamadas a herramientas (84 palabras) | ✅ 65,5 s · 5 turnos, 10 llamadas a herramientas | ✅ 5,1 s |
| Renombrar funciones en archivos y pruebas | ✅ 89,9 s · 14 turnos, 22 llamadas a herramientas | ✅ 128,9 s · 10 turnos, 9 llamadas a herramientas | ✅ 12,3 s |
| Tiempo total transcurrido | 159,2 s | 309,9 s | 35,7 s |
| Tokens: entrada sin caché / lectura de caché / salida | 87,4k / 456,7k / 7,6k | 91,5k / 355,3k / 10,0k (de ellos 4,1k correspondientes a razonamiento) | 6,1k / 147,3k / 4,7k (2,0k de ellos razonamiento) |
| Lecturas de caché por cada token de entrada sin caché | 5,2 | 3,9 | 24 |
| Coste | $0,125 a razón de $0,60 / $2,40 / $0,12 por millón de tokens (precios de lista; yo tengo un plan fijo) | $0,531 a razón de $3 / $15 / $0,30 por millón de tokens | $0,011 a razón de $0,44 / $1,32 / $0,014 por millón de tokens |
Los precios se indican por millón de tokens, en el orden siguiente: entrada sin caché / salida / lectura de caché. Cada coste es la suma de los valores usage.cost.total de cada tarea; multiplicar el total de tokens por dichos precios arroja el mismo resultado.
Lo que revela la tabla:
- Todas las tareas se completaron correctamente. Verifiqué cada resultado en disco: salida de FizzBuzz, pruebas pytest exitosas, recuento de palabras del resumen y ausencia de nombres obsoletos tras el renombrado.
- MiniMax resultó aproximadamente 2 veces más rápido que Kimi y unas 4 veces más barato según los precios de lista (159,2 s frente a 309,9 s; $0,125 frente a $0,531). Dadas las diferencias en configuraciones de razonamiento y archivos de prueba, este ratio de velocidad debe considerarse una referencia aproximada, no una medida exacta.
- dsh sobre V4-Flash fue unas 4,5 veces más rápido que MiniMax y alrededor de 11 veces más económico en este tipo de tareas.
- La caché es clave para el rendimiento. MiniMax leyó 5,2 tokens desde la caché por cada token de entrada sin caché. Según los precios de lista, una lectura de caché cuesta un 80 % menos que una entrada sin caché. De haberse facturado como entrada sin caché, esos mismos tokens habrían costado unos $0,34 en lugar de $0,125.
- Los reintentos no se incluyen en los totales. Las doce ejecuciones de benchmark realizadas por MiniMax, incluidas las descartadas, sumaron $0,28 según precios de lista y 321 s de tiempo transcurrido.
La prueba del widget, y una corrección
El “divertido test” del artículo sobre dsh consistía en un widget de arte pixelado con el logo de este sitio, creado a partir de un brief escrito (citado íntegramente en el concurso): un archivo ll-pixel-logo.js sin dependencias que rasteriza un anillo y dos “L” inclinadas sobre una cuadrícula de 40×40, hace que los píxeles se alejen del puntero, se fragmenta y vuelve a ensamblarse al hacer clic, respeta la preferencia prefers-reduced-motion, además de incluir una página de demostración, un README y una prueba automática. Le di el mismo brief a Kimi y luego a MiniMax, ambos en el mismo agente de trabajo. El artículo sobre Kimi describe los tres intentos de Kimi; lo relevante aquí es el segundo intento, que generó un widget completo de 323 líneas, una página de demostración, un README y dos archivos de prueba dentro del espacio de trabajo propio del agente de trabajo, en lugar de la carpeta que yo estaba vigilando; el proceso se interrumpió a los 15 minutos de haber comenzado. Asumí entonces que no había producido nada.
Una hora después, MiniMax recibió el mismo brief en ese mismo agente de trabajo: 59,3 segundos, 25 turnos, 24 llamadas a herramientas, un costo de $0,13 según el precio de lista. Encontró los archivos del segundo intento de Kimi aún guardados en ese espacio de trabajo, leyó los cinco archivos y el informe de ejecución de Kimi, ejecutó sus pruebas y respondió: “Se construyó y verificó el conjunto completo de widgets”. En realidad, no escribió ni una sola línea de código para el widget. Los únicos archivos que generó fueron su propio informe de ejecución y un archivo de estado.
Tomé esa respuesta al pie de la letra; por eso la primera versión de este artículo mostraba el widget como obra de MiniMax. El registro de la sesión evidencia el write de ese archivo exacto durante el segundo intento de Kimi, y la copia en este sitio es idéntica a nivel de bytes. Por consiguiente, este artículo no incluye resultado alguno del widget generado por MiniMax, y no he vuelto a ejecutar el brief. Lo que sí contiene es un claro ejemplo de cómo un agente atribuye como propio un trabajo que en realidad encontró previamente, motivo por el cual existen las advertencias que se detallan más abajo.
A continuación, el widget, debidamente atribuido al segundo intento de Kimi K3:
prefers-reduced-motion.Su geometría: RING_R = 19.4, el anillo interior se sitúa a 0,82R; SHEAR = 0.42 (aproximadamente 22,8°), y existe un auxiliar llamado inL que comprueba simultáneamente la base y el tallo inclinado. Al evaluar su función isLit sobre toda la cuadrícula de 40×40, se obtienen 602 celdas iluminadas. El concurso lo muestra junto a los otros dos widgets.
Lo que volví a verificar en el widget de intento-2
Ejecútelo en una copia provisional de la carpeta que contiene el widget y los dos archivos de prueba que escribió Kimi:
$ wc -l ll-pixel-logo.js
323 ll-pixel-logo.js
$ node --check ll-pixel-logo.js && echo "syntax ok"
syntax ok
$ node test-bitmap.js | tail -1
ALL PASS
$ node test-smoke.js | tail -1
SMOKE PASS
test-bitmap.js realiza 18 verificaciones: se comprueba que el anillo esté presente en los puntos cardinales y ausente en las esquinas y el centro; que el tallo y la base de cada “L” se encuentren en su cuadrante correspondiente; además, se verifica la zona de interconexión, la dirección de la inclinación y que el número total de celdas iluminadas esté entre 540 y 670. test-smoke.js realiza 10 comprobaciones: un montaje del DOM simulado, un nuevo montaje idempotente; se verifica además que tenga role="img" y un atributo aria-label; se generan 300 fotogramas con un movimiento del puntero y dos clics (el segundo en medio de una animación); se comprueba el estado finito de las partículas, que el logotipo vuelva a su posición inicial después de todo; se verifica también la existencia de un buffer de 640 píxeles con un devicePixelRatio de 2, y por último, se confirma que la función unmount() funcione correctamente. Estas son las pruebas propias de Kimi; no constituyen una verificación independiente: Kimi editó test-bitmap.js tras su primera ejecución, desplazando los cuadros de medición y ajustando el rango permitido de celdas iluminadas a 540–670 después de haber medido un total de 602. Que las pruebas se pasen aquí solo indica que el widget y sus pruebas concuerdan, no que estas pruebas establezcan un estándar mínimo. Mi propio recuento arroja 602 celdas iluminadas, distribuidas como 196 / 137 / 101 / 168 en los cuadrantes superior-izquierdo, superior-derecho, inferior-izquierdo e inferior-derecho, respectivamente.
Problemas comunes (los que yo realmente he experimentado)
- Las sesiones persistentes arruinan los benchmarks. El comando
openclaw agent --agent worker -m "…"reutiliza la sesión del agente, a menos que se especifique un nuevo--session-key. En mi primera ejecución de MiniMax, el proceso FizzBuzz determinó que el archivo ya existía y se negó a escribirlo; la ejecución de corrección de errores indicó que las pruebas ya habían sido superadas; y la ejecución de resumen procesó la carpeta de correcciones del modelo Kimi en lugar de la suya propia. Un--session-keyúnico por tarea solucionó el problema. - Las instrucciones predeterminadas del agente tienen prioridad sobre el prompt respecto a dónde guardar los archivos. Las instrucciones de mi agente indican que debe guardar las salidas más largas en su propio espacio de trabajo; eso prevaleció sobre la orden “escribe fizz.py en esta carpeta” en dos ocasiones. En la tercera ejecución, el sistema afirmó haber escrito el archivo en la carpeta temporal; sin embargo, la marca de tiempo del archivo indica que se guardó en el espacio de trabajo. La cuarta ejecución, con una ruta absoluta y una instrucción explícita para usarla, funcionó correctamente.
- Un espacio de trabajo compartido contamina la siguiente ejecución. Como se mencionó anteriormente: los archivos abandonados por Kimi permanecieron en el espacio de trabajo del agente incluso una hora después; MiniMax los consideró como propios. Por eso, es necesario asignar una carpeta vacía a cada ejecución y verificar qué archivos realmente se crearon (marcas de tiempo, llamadas
writerealizadas durante la ejecución), no lo que el sistema afirma haber escrito. - El catálogo indica 1,000,000 de tokens; yo uso 262,144. Esa es mi configuración personal de
contextTokens; además,agentMeta.contextTokensen el archivo JSON confirma cuál valor está vigente. Aumente este valor si realmente necesita un margen mayor. - Las cifras monetarias en los planes básicos son ficticias, pero resultan útiles como referencia. OpenClaw rellena el campo
usage.cost.totalcon precios estándar predefinidos, independientemente de lo que usted realmente pague. Por eso sirve para comparar modelos, pero no tiene valor como factura real.
¿En qué situación me deja esto?
El modelo MiniMax M3 es el principal en mi agente de trabajo; DeepSeek V4-Flash y luego V4-Pro sirven como modelos de respaldo. Kimi K3 no forma parte de esta cadena; lo uso en otro lugar, para mi agente de revisión. En estas tareas, M3 realizó el cambio de nombre en 89,9 segundos, con un costo de $0,058 según el precio listado; Kimi tardó 128,9 segundos y costó $0,180. Para la corrección de errores, M3 necesitó 41,0 segundos y $0,025, frente a los 86,6 segundos y $0,114 que empleó Kimi. dsh en el modelo V4-Flash fue más rápido y económico que ambos en todas las tareas.
En cuanto al brief relacionado con los widgets, no tengo resultados de MiniMax. Si usted realiza una comparación similar, asegúrese de asignar una carpeta vacía para cada ejecución y lea las llamadas write de la sesión antes de consultar su informe.
Relacionado: Kimi K3 como agente de programación (el lado de Kimi en esta comparación), DeepSeek Harness (dsh) (las cinco tareas y el brief original sobre widgets), Reasonix (comparado en artículos anteriores; retirado de mi configuración el 09-09-2026) y Cuánto cuestan realmente mis agentes de IA.