٤ عيوب في النظام أدت إلى تشويه نتائج اختبارات الأداء للنموذج اللغوي الخاص بي
- تاريخ النشر
- 2 نوفمبر 2026
- تاريخ التحديث
- 2 نوفمبر 2026
- بقلم
- جاكوب لويد — كُتب بمساعدة الذكاء الاصطناعي بعد إنجاز المشروع
- مدة القراءة
- قراءة 2 دقيقة

بعبارة مبسطة: أشار معيار تقييم نماذج اللغوية الخاص بنا إلى أن النموذج الجديد أسوأ من النموذج القديم. وكان تقييمه صحيحًا في الغالب، لكنه غير ذي صلة بالموضوع الفعلي؛ فالمشكلة الحقيقية كانت وجود أربع أخطاء في بيئة الاختبار نفسها. توضح هذه الصفحة تكلفة كل خطأ، وكيفية اكتشافه، بالإضافة إلى مجموعة أدوات بايثون مجانية يمكن استخدامها للتحقق من بيئة الاختبار الخاصة بك قبل الوثوق بأي نتيجة.
في الاختبار الذي أُجري ليلة 2 نوفمبر 2026 وانتهى منتصف الليل، حقق النموذج الجديد تقييماً أقل من النموذج الأقدم: حيث حصل على 13.3 من أصل 20 درجة في اختبار MiniMax-M3.1-Flash، مقابل 14.2 للنموذج MiniMax-M2.5. الجزء من النتائج الذي لم نستطع الوثوق به كان متعلقاً بأداء أداة الاختبار لدينا.
خلاصة الموضوع
- التقييم كان في الغالب صحيحاً؛ لكن الجزء المثير للاهتمام لم يكن كذلك. أظهر التدقيق أن هناك عيبين في أداة الاختبار، وأن ذلك أثر على النتيجة بزيادة تتراوح بين 0.4 و1.7 نقطة؛ وبالتالي فإن التقييم الحقيقي يقع بين 13.7 و14.9 نقطة؛ والفارق عن النماذج الأفضل يعود إلى جودة النموذج نفسه.
- ثلاثة سلوكيات في أداة الاختبار تجعل النموذج يبدو ضعيفاً. أحدها هو التخلي عن عملية الاستدلال المنطقي؛ ففي اختبار مماثل، لم يتذكر النموذج أي إجابة من أصل 10 بدون ذلك، بينما تذكر 8 إجابات معه. كما أن صفوف “نفاد الرموز” كانت فارغة دائماً (13 من أصل 13، و10 من أصل 10 في جميع السجلات المخزنة)، ولم تكن هناك حالات جزئية أبداً. قائمة النماذج مجرد قائمة، وليست وعداً؛ فثلاثة نماذج تم إيقافها لا تزال مدرجة في القائمة، وكل محاولة للاتصال بها تؤدي إلى خطأ 404.
- سؤال واحد طُرح على النموذج كان يتضمن أربعة أسئلة في آن واحد. وبما أن نظام التقييم يعتمد على إجابات من نوع “نعم/لا”، فإن أي رد يصف الموقف لكنه يغفل عن إجابة واحدة يُعتبر رداً خاطئاً كلياً، ويؤثر ذلك على التقييم الإجمالي.
- الحل الصحيح من الناحية النظرية لا يعني بالضرورة أنه مقياس دقيق. نطاق الخطأ في التقييم يتراوح بين 0.8 و1.8 نقطة، لكن التصحيح المنطقي الذي تم إجراؤه لم يغير التقييم الإجمالي بقدر ذلك؛ فحالة برمجية واحدة نجحت في الاختبار بتاريخ 1 نوفمبر 2026، لكنها فشلت في الاختبار بتاريخ 2 نوفمبر 2026 تحت نفس أداة الاختبار.
ما الذي ستحصل عليه في النهاية
أداة مجانية بصيغة ZIP، وهي llm-conform 1.0، تقوم بالإجابة على سؤال واحد لكل نموذج تختبره: هل واجهة البرمجة الخاصة بي تتوافق مع بروتوكول هذا النموذج؟ يتم إجراء ست عمليات تحقق عبر مسار الطلبات الخاص بك؛ أي حوالي 21 طلب API لكل وضع إعادة تشغيل، ويتم حفظ الأدلة المتعلقة بكل عملية تحقق بجانبها.
$ python3 llm_conform.py --config my-config.toml

MODEL my-model  (https://api.example.com/v1)
  c1   PASS  served; endpoint reports model 'my-model'
  c2   PASS  reasoning arrives via 'reasoning_content'; answer text is clean
  c3   FAIL  your replay mode loses this model's reasoning: 'content-only' recalled 0/3
              but 'reasoning_content' recalled 3/3 - use reasoning_content
  c4   WARN  tool round trip ok (lookup_record -> result -> answer); an unanswered tool call
              is tolerated by the endpoint, but it must still be answered or removed
  c5   PASS  the sampler was accepted
  c6   PASS  a medium task fits in max_tokens=4096 (finish_reason=stop)

  VERDICT FAIL  (1 fail, 1 warn, 4 pass, 0 info)
تكون قيمة كود الخروج 0 عند نجاح جميع عمليات التحقق، و1 في حالة وجود تحذير، و2 في حالة الفشل؛ مما يسمح بدمج الأداة في أنظمة التكامل المستمر (CI). لا توجد حزم برمجية أو موردون إضافيون؛ فالأمثلة تستخدم https://api.example.com/v1، وmy-model، و$MY_API_KEY.
ما هي العيوب الأربعة التي أخفاها اختبار تقييم نموذج اللغة الخاص بنا؟
الجدول بعد التصحيحات. الرمز ± الموجود بعد كل درجة يمثل نصف فترة الثقة بنسبة 90% المحسوبة من خلال طريقة “البووتستراب”. يعتبر الجدول أن صفين متطابقين عندما تحتوي فترة الثقة بنسبة 90% لفرق درجاتهما على الرقم 0، وليس عندما تتداخل أشرطة الخطأ الخاصة بهما.

| النموذج | قبل التصحيحات | بعد التصحيحات | الدرجة بعد إعادة تشغيل الصفوف خارج الميزانية |
|---|---|---|---|
| MiniMax-M3.1-Flash | 13.3 | 13.5 ± 1.6 | 14.3 |
| MiniMax-M3 | 13.4 | 14.4 ± 1.6 | 15.3 |
| MiniMax-M2.5 | 14.2 | 11.7 ± 1.8 | = |
| MiniMax-M2.5-highspeed | 12.8 | 14.0 ± 0.8 | = |
| MiniMax-M2.7-highspeed | 13.8 | 13.5 ± 1.1 | = |
| MiniMax-M2.7 | 12.6 | 12.6 ± 1.8 | = |
| deepseek-flash | 19.2 | 19.2 ± 0.8 | — |
| deepseek-pro | 17.5 | 17.5 ± 0.8 | — |
“قبل التصحيحات” يشير إلى الجدول المسجل بتاريخ 2026-11-02 صباحًا؛ أما “بعد التصحيحات” فيشير إلى الجدول الذي تم إعادة بنائه في الساعة 20:18 ثم تحديثه مرة أخرى في الساعة 20:55 بعد إعادة تشغيل صفين. الدرجة بعد إعادة تشغيل الصفوف خارج الميزانية هي الدرجة الناتجة عن إعادة تشغيل تلك الصفوف؛ أكبر انخفاض في الدرجات كان لدى نموذج MiniMax-M2.5 الذي تراجعت درجته بمقدار 2.5 نقطة؛ حيث انخفضت درجته في فئة البرمجة من 5.0 إلى 3.1، وهي درجة لا يمكن للتصحيحات أن تؤثر عليها.
1. أزال النظام منطق الاستدلال من الردود
قام برنامج الاختبار الخاص بنا بإرسال النص المرئي فقط من ردود المساعد الذكي. لكن وثائق MiniMax تتطلب العكس: إرسال الرد الكامل، بما في ذلك reasoning_content، ضمن سجل المحادثة. طلب الاختبار رقمًا عشوائيًا مكونًا من ستة أرقام ضمن منطق الاستدلال فقط، وكان الرد "ok"؛ ثم طُلب في الخطوة التالية تحديد هذا الرقم.
| النموذج | تم حذف منطق الاستدلال | تم إعادة إرسال منطق الاستدلال |
|---|---|---|
| MiniMax-M3 | 1 من أصل 10 | 7 من أصل 10 |
| MiniMax-M3.1-Flash | 0 من أصل 10 | 8 من أصل 10 |
| MiniMax-M2.5 | 2 من أصل 10 | 6 من أصل 10 |
عندما تم حذف منطق الاستدلال، أنتج النموذج استدلالًا في جولة واحدة فقط من أصل 12 جولة في الحالة التي قمنا بقياسها (RD4-kettle-saddle)؛ أما عند إعادة إرسال منطق الاستدلال، فقد حدث ذلك في 6 إلى 12 جولة من أصل 12. أي أن النظام قمع منطق الاستدلال ولم يفقده بالفعل. الحل هو تفعيل خيار خاص لكل مزود خدمة؛ يكون هذا الخيار مفعلاً بشكل افتراضي للمزودين الذين يستخدمون واجهة برمجة MiniMax، ومعطلاً لبقية المزودين، بالإضافة إلى وجود حقل طلب خاص لضمان وصول منطق الاستدلال عبر القناة نفسها. أما المحادثات التي يتم تقييمها فتبقى تحتوي على النص المرئي فقط؛ حيث يُعتبر منطق الاستدلال جزءًا من السياق وليس إجابة في حد ذاته.

كان هناك تسرب آخر في دورة الأدوات المستخدمة: تم إضافة رد من المساعد الذكي دون ذكر استدعاء الأداة ونتائجه، مما أدى إلى اعتباره استدعاءً ثانيًا، وهو ما يخالف القواعد المتوقعة التي تفترض وجود استدعاء واحد فقط. في جميع المحادثات المسجلة، تم حذف 45 استدعاء أداة؛ كما تم إعادة إرسال 3 من أصل 3 استدعاءات كانت مخالفة للقواعد المتوقعة.
2. عبارة “نفدت الرموز” تعني أن النتيجة كانت فارغة، وليست جزئية
عمل اللوح الخاص بنا باستخدام 16,384 رمزًا للإخراج. أما القيمة الموصى بها من قبل المورد للطرازين الكبيرين فهي 131,072، أي ثماني مرات أكثر. كل الصفوف التي تم اقتطاعها كانت فارغة، ولم تكن تحتوي على إجابات جزئية؛ فمن بين جميع النصوص المسجلة، كانت نسبة النتائج الفارغة 100% في كل من MiniMax-M3 وMiniMax-M3.1-Flash، بينما لم تحدث أي حالات اقتطاع في الطرازين الأصغر، حيث كانت إجاباتهم أقصر بكثير. أما بالنسبة للعمليات التي تم تنفيذها على اللوح نفسه، فقد كان هناك صفان مقتطعان وفارغان في حالة WR1-ninth-string بالنسبة لطراز MiniMax-M3، بينما لم يحدث أي اقتطاع في طراز MiniMax-M3.1-Flash. تلك الحالة هي الوحيدة التي لا تزال تؤثر على النتيجة النهائية؛ حيث يمكن أن تضيف ما يصل إلى +0.574 نقطة لطراز M3 (ولا شيء لطراز M3.1-Flash)، وقد تكون النقاط صفرًا أيضًا، لأن إجابة غير فارغة قد تفشل في اجتياز الفحوصات.
عند إعادة تشغيل الحالات التي فشلت باستخدام الميزانية الموصى بها، تحولت النتائج الفارغة إلى إجابات كاملة؛ ففي إحدى الحالات التي كانت تُظهر finish=length وكان قد تم استهلاك 16,383 من أصل 16,384 رمزًا في التفكير دون ظهور أي نص، أعطى التشغيل باستخدام الميزانية الموصى بها نتيجةً عبارة عن دالة بايثون مكونة من 8,897 حرفًا؛ وفي حالة أخرى كانت النتيجة عبارة عن نص مكون من 4,466 حرفًا. وقد تم إزالة هاتين الحالتين لاحقًا من اللوح، وبالتالي لم تُحتسب لهما أي نقاط. ولهذا السبب يحتفظ اللوح بعمود “Room”؛ فبدونه، تعني عبارة “ميزانية متساوية” في الواقع “ميزانية متساوية بالإضافة إلى صفر صامت لطراز الذي يحتاج لأطول وقت في التفكير”.
٣. قائمة النماذج كانت قديمة/غير محدثة
تم وسم ثلاثة معرفات نماذج في سجل البائع على أنها “تقاعدت”، لكن نقطة النهاية الخاصة بالنماذج لدى البائع ما زالت تعرضها؛ وكل طلب يتم إرساله يعيد رمز الحالة HTTP 404 مع رسالة “لم يعد متاحًا” والرمز 2069. قائمة النماذج هي مجرد قائمة، وليست وعودة: يجب اختبار النموذج الذي تنوي استخدامه – بطلب واحد فقط – واعتبار عرضه في قائمة النماذج مجرد تلميح، وليس دليلًا قاطعًا. تحقق من أن c1 يقوم بذلك، كما أنه يكتشف حالات التسمية المتعددة للنموذج.

ينطبق نفس القاعدة في الخطوة السابقة أيضًا. تقول الأسئلة الشائعة الخاصة بالبائع أن عائلتي النماذج M2.5 وM2.7 ستتقاعدان في تاريخ 2026-11-18، وأن الطلبات الموجهة إليهما عبر خطة M أو خطة الرموز Token Plan تم تحويلها تلقائيًا إلى نموذج M3.1 Flash منذ تاريخ 2026-10-19. قمنا باختبار ذلك في تاريخ 2026-11-02؛ فالواجهة البرمجية ما زالت تُرجع معرفات النماذج المطلوبة، وباستخدام reasoning_split: false يعيد نموذج M3.1-Flash رمز الحالة HTTP 400 بينما تعيد معرفات M2.5 وM2.7 رمز 200 دون أي تفاصيل إضافية. من الخارج، لا يمكنك معرفة أي نموذج يُستخدم فعليًا. لذا، إذا كانت الأسئلة الشائعة تنطبق على هذا الحساب، فإن أربعة من أصل ستة نماذج في قائمة MiniMax هي في الحقيقة نموذج M3.1-Flash بأسماء مختلفة؛ وتباين قيمها (من 11.7 إلى 14.0) هو مجرد تغير طبيعي بين عمليات تشغيل النموذج، وليس مؤشرًا على ترتيبه.
٤. سؤال واحد طُرح على الحكم ليتحقق من أربعة أمور في نفس الوقت
عنصر التقييم هو إجابة بنعم/لا، والقيمة “لا” تشير إلى أن الجانب المطلوب لم يتم الوفاء به. في إحدى جلسات اختبار الأدوار البالغة، طُلب من الحكم التأكد من أربعة أمور في آن واحد: هل الفعل مذكور في النص، وكيف تم تمثيله، وهل وصل الشخصية إلى ذروة الحدث، وهل تم ذكر اسم الشخصية الأخرى. أي رد يؤكد كل شيء باستثناء الاسم يُعتبر ردًا خاطئًا، ويؤدي ذلك إلى خفض درجة التقييم؛ كما يتم فحص الاسم بشكل منفصل، مما يعني أن نفس التفصيل يتم تقييمه مرتين.
<pوبالنظر إلى البيانات المسجلة: من أصل ١٧ سطرًا تم تقييمها وفقًا لهذا العنصر المركب، فشل ١٠ منها. درجة التقييم لكل سطر هي مجموع نسب النجاح في فحوصات التوضيح بالإضافة إلى نقطة واحدة تمثل تقييم الحكم العام للوضوح؛ لذا فإن أي إجابة خاطئة تخفض الدرجة بمقدار ربعها. كما أن الجلسات الفردية تُظهر تقلبات كبيرة: في أول حالة اختبار، حصل كلا النموذجين على درجة ٠.٧٣، مما يجعل من المستحيل التمييز بينهما؛ أما في الحالة الثانية، فقد تفوق نموذج MiniMax-M3 بدرجة ٠.٨٩ مقابل ٠.٤٤؛ وفي حالة أخرى، انقلب الترتيب (٠.٠ لنموذج M3 مقابل ٠.٩١ لنموذج M3.1-Flash). لذا فإن جلسة تقييم واحدة لكل حالة تمثل عينة فقط، وليست تصنيفًا نهائيًا.
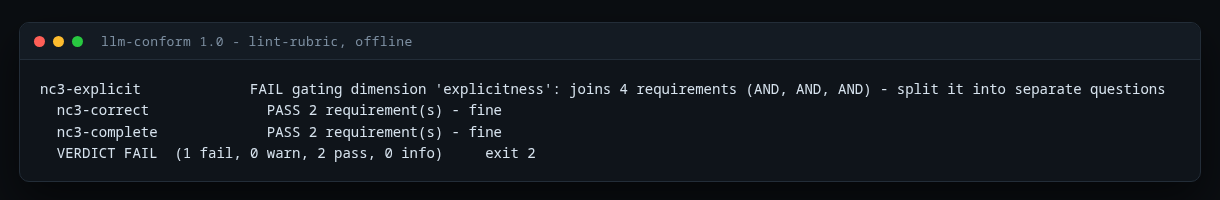
<pالحل المقترح يقسم هذا العنصر إلى سؤالين منفصلين: أحدهما عن محتوى النص والآخر عن طريقة التمثيل؛ كما يتم تقييم الاسم مرة واحدة فقط، ويتم إعادة تقييم النصوص المسجلة بدلًا من إعادة إنشائها. بالإضافة إلى ذلك، تم إضافة قاعدة تحقق: أي عنصر تقييم يجمع أكثر من متطلبين في سؤال واحد يُعتبر خطأً؛ مع الاحتفاظ بنص التصحيح كجزء من الاختبارات الرجعية. وقد نجحت جميع الحالات في اختبار هذه القاعدة: ٤٦٣ عنصر تقييم عبر ٣٩٣ حالة. كان هناك سطر واحد فقط فشل في الإجابة على كلا السؤالين؛ درجة التقييم له كانت ٠.٧٥، ودرجة الحالة بأكملها ٠.٦٢. هذا الحل أزال تقييمًا غير عادل، لكنه لم ينقذ نموذجًا لم يستطع أداء المهمة المطلوبة.
5. الحل الصحيح لا يؤدي إلى تحريك اللوحة رغم ذلك
الحل المنطقي صحيح بلا شك: نفس الاختبار أظهر تحسنًا من 0 من أصل 3 إجابات صحيحة إلى 3 من أصل 3، في كل مرة، خلال ثلاث تجارب منفصلة باستخدام ألغاز مختلفة. كما أن اللوحة تحركت مسافة أقل من هامش الخطأ المتوقع: فقد تحسن أداء اختبار “السلسلة المصغرة” من 0 إلى 3، وزادت نتيجة جزء “Deep RP” بمقدار 0.2 إلى 0.4 نقطة على طرازي M3، بينما لم يتغير المؤشر الكلي إلا بمقدار أقل من هامش الخطأ المتوقع. يتجاهل برنامج MiniMax معلمة seed، لذا فإن كل صف في نتائج MiniMax يمثل عينة واحدة؛ ففي حالتين من حالات الاختبار، تم إجراء خمس تجارب متطابقة في كل حالة، وأظهرت نتائج تباينًا في معدلات الإجابات بلغ 0.250 و0.500 على التوالي.
هناك حالة برمجية نجحت في الاختبار بتاريخ 2026-11-01، لكنها فشلت في 2026-11-02 تحت نفس الظروف والإعدادات؛ وهما تجربتان صادقتان أعطتا نتائج متضادة. عند التحقق من الأمر، اكتشفنا خللاً آخر: كان هناك تدفق بيانات ينتهي بعد مرحلة الاستنتاج دون أي سبب واضح للإنهاء، ومع ذلك تم اعتباره إجابة فارغة مكتملة وحاز على درجة صفر. الآن يتم التعامل مع هذا التدفق كتدفق تم إسقاطه ويتم إعادة تنفيذه. لذا فإن ترتيب الخطوات هو ما يجب الالتزام به: تحقق من صحة البروتوكول، ثم أعد تشغيل الجلسة قبل أن تصدق أن هناك تحركًا يؤدي إلى تغيير بنقطة واحدة فقط.
السبب الجذري، والفحص الذي يكتشفه
لم يكن أي من العيوب الأربعة عيبًا في النموذج أو في كود التقييم، وليس لها جميعًا نفس السبب؛ فقائمة النماذج القديمة تعود لمسؤولية المورد، وعنصر التقييم المركب يرتبط بتصميم الحالة الاختبارية، أما حدود استخدام الرموز فهي خيار تكويني. إذًا، هناك أربعة أسباب جذرية:
- تم افتراض بروتوكول الطلب الخاص بكل مزود ونموذج، دون التحقق منه مقارنةً بسلوك النموذج أو وثائق المورد.
- لا يوجد ما يثبت، بالنسبة لكل نموذج، أن المحادثة التي يرسلها البرنامج الاختباري هي محادثة يمكن للنموذج التعامل معها.
- لم تسجل الصفوف بروتوكول الطلب الذي أنتجها، لذا لم يتمكن أي تعديل في البرنامج الاختباري من تحديد الصفوف التي أصبحت قديمة.
- لم يكتشف فاحص الأخطاء الأسئلة المركبة المتعلقة بالشروط.
الحل هو إجراء سلسلة من الفحوصات قبل كل اختبار، وليس مجرد حالة خاصة في برنامج التشغيل؛ حيث يتم إجراء ستة فحوصات لكل نموذج — أي حوالي 21 طلب API لكل وضع تشغيل — عبر مسار الطلبات الخاص بالبرنامج الاختباري نفسه، ولا يتم استخدام طلبات يدوية أبدًا، لأن ذلك لا يثبت شيئًا بخصوص صحة عمل البرنامج. كما أن السجل الذي يتم إنشاؤه يحتوي على بصمة بروتوكولية، مما يسمح باكتشاف أي تغييرات في البرنامج الاختباري.
الحزمة المتاحة للتنزيل تمثل هذه الخطوة بالذات، وهي مصممة لتعمل مع أي نقطة نهاية متوافقة مع OpenAI؛ فهي تشتمل على نفس الستة فحوصات، ونفس ملفات الأدلة، وفاحص الأخطاء، بالإضافة إلى مجموعة اختبارات غير متصلة بالشبكة تتكون من 44 اختبارًا ضد نقطة نهاية محلية وهمية. إنها حزمة للتنزيل فقط، ولا تتطلب اشتراكًا. لكنها لن تخبرك أي نموذج هو الأفضل؛ فهذه مسؤوليتك أنت، والنسخة الصادقة من النتائج تتطلب إجراء اختبارات متكررة وتحديد هامش الخطأ بشكل رسمي.
ما الذي يترتب على ذلك؟
ستتوقف عائلات المنتجات M2.5 وM2.7 عن العمل في تاريخ 18 نوفمبر 2026؛ وهذا يشمل أربعة من أصل ستة خطوط إنتاج MiniMax. ومن المخطط نقل حركة المرور المتعلقة بها إلى طراز آخر، لذا يجب اتخاذ قرار بشأن تلك الخطوط قبل ذلك التاريخ. يوجد أمر crucibleforge conform وقد كشف عن وجود خلل في المنطق المستخدم؛ والخطوة التالية هي جعل أداة القياس ترفض أي طراز لا يستوفي المعايير، لكن ذلك لم يتم بعد. لا نزال بحاجة إلى عدد كافٍ من الاختبارات المتكررة لتصنيف النماذج ضمن نطاق محدد؛ وهذا النطاق هو الإجابة الصحيحة فعلاً.
مرتبط: أداة القياس نفسها (276 حالة اختبار، منها 166 صعبة)، تكلفة استخدام وكلائنا الذكاء الاصطناعي فعليًا، MiniMax M3 كوكيل برمجي، وStudioForge.
التنزيلات
مجاني للاستخدام الشخصي. إذا وفّر لك عصرًا كاملًا من الوقت، فزر القهوة قريب منك.