4 Defeitos que distorceram as minhas pontuações nos testes de benchmark do LLM
- Categoria
- IA e LLM Local
- Publicado em
- 2 novembro 2026
- Atualizado em
- 2 novembro 2026
- Por
- Jacob Lloyd — escrito com ajuda de IA, depois do projeto
- Tempo de leitura
- 13 min de leitura

Em termos simples: Nosso benchmark de LLM indicou que um novo modelo era pior do que um modelo mais antigo. Na maioria dos casos, isso estava correto; porém, era irrelevante: o verdadeiro problema eram quatro falhas no próprio ambiente de teste. Esta página mostra quanto cada falha custou, como identificá-la e também um kit gratuito em Python que verifica seu próprio ambiente de teste antes que você confie nos resultados obtidos.
Na execução noturna que terminou à meia-noite de 02/11/2026, um novo modelo hospedado obteve uma pontuação abaixo da do seu antecessor: 13,3 de 20 para o MiniMax-M3.1-Flash, contra 14,2 para o MiniMax-M2.5. A parte do número que não pudemos considerar confiável foi a resultante dos defeitos no nosso “harness” de teste.
Resumindo
- A pontuação era, em grande parte, real; o interessante é que não era. Uma auditoria apontou que os dois defeitos no “harness” adicionaram aproximadamente de +0,4 a +1,7 pontos à pontuação; a pontuação real ficaria entre 13,7 e 14,9. A diferença em relação aos modelos líderes era fruto da qualidade real do modelo.
- Três comportamentos do “harness” fazem um modelo parecer ruim. Um deles é a eliminação do raciocínio lógico: o mesmo teste obteve 0 de 10 sem essa funcionalidade, mas 8 de 10 com ela. As linhas marcadas como “esgotaram os tokens” estavam vazias (13 de 13 casos, 10 de 10 em todos os registros); nunca houve respostas parciais. Uma lista de modelos é apenas uma lista, não uma garantia: três IDs desativados ainda constavam na lista, e todas as chamadas a eles retornaram erro 404.
- Uma pergunta avaliada pedia quatro respostas ao mesmo tempo. Cada elemento de avaliação exige uma resposta sim/não; portanto, uma resposta que descrevia a cena mas omitia um dos itens foi considerada totalmente errada, e o fator de “complexidade” também foi afetado.
- Um correção teoricamente correta ainda não é uma medida válida. A margem de erro é de 0,8 a 1,8 pontos; a correção feita no raciocínio do modelo alterou a pontuação em menos que isso. Um caso de codificação foi aprovado em 01/11/2026 e falhou em 02/11/2026, sob o mesmo “harness” de teste.
O que você obtém no final
Um arquivo zip gratuito, llm-conform 1.0, que responde a uma pergunta por modelo que você testa: o meu harness consegue seguir o protocolo deste modelo? São seis verificações realizadas através do seu próprio caminho de requisição — cerca de 21 solicitações à API por modo de replay — com as evidências salvas ao lado de cada uma delas.
$ python3 llm_conform.py --config my-config.toml

MODEL my-model  (https://api.example.com/v1)
  c1   PASS  served; endpoint reports model 'my-model'
  c2   PASS  reasoning arrives via 'reasoning_content'; answer text is clean
  c3   FAIL  your replay mode loses this model's reasoning: 'content-only' recalled 0/3
              but 'reasoning_content' recalled 3/3 - use reasoning_content
  c4   WARN  tool round trip ok (lookup_record -> result -> answer); an unanswered tool call
              is tolerated by the endpoint, but it must still be answered or removed
  c5   PASS  the sampler was accepted
  c6   PASS  a medium task fits in max_tokens=4096 (finish_reason=stop)

  VERDICT FAIL  (1 fail, 1 warn, 4 pass, 0 info)
O código de saída é 0 quando todas as verificações são aprovadas; 1 indica um aviso, e 2 indica uma falha, permitindo a integração com sistemas de CI. Não são necessários pacotes ou ferramentas adicionais: os exemplos utilizam https://api.example.com/v1, my-model e $MY_API_KEY.
Quais quatro defeitos o nosso benchmark de LLM ocultou?
O quadro após as correções. O símbolo ± após uma pontuação representa metade do intervalo bootstrap de 90% para os casos analisados. O quadro considera duas linhas como empatadas quando o intervalo de 90% da diferença entre elas inclui o valor 0; não quando as barras individuais se sobrepõem.

| Modelo | Antes | Após as correções | Espaço |
|---|---|---|---|
| MiniMax-M3.1-Flash | 13,3 | 13,5 ± 1,6 | 14,3 |
| MiniMax-M3 | 13,4 | 14,4 ± 1,6 | 15,3 |
| MiniMax-M2.5 | 14,2 | 11,7 ± 1,8 | = |
| MiniMax-M2.5-highspeed | 12,8 | 14,0 ± 0,8 | = |
| MiniMax-M2.7-highspeed | 13,8 | 13,5 ± 1,1 | = |
| MiniMax-M2.7 | 12,6 | 12,6 ± 1,8 | = |
| deepseek-flash | 19,2 | 19,2 ± 0,8 | — |
| deepseek-pro | 17,5 | 17,5 ± 0,8 | — |
“Antes” refere-se ao quadro de resultados de 2022-11-02 pela manhã; “depois” refere-se ao quadro reconstruído às 20:18 e atualizado às 20:55, após duas linhas terem sido executadas novamente. Sala indica a pontuação obtida após as linhas fora do orçamento serem executadas novamente. A maior queda foi no MiniMax-M2.5, que perdeu 2,5 pontos: sua pontuação secundária “Func” caiu de 5,0 para 3,1; o código de uma única etapa não permite corrigir esse valor.
1. O “harness” descartou o raciocínio lógico
Nosso executor de múltiplas iterações retornou apenas o texto visível da resposta do assistente. A documentação do MiniMax exige o oposto: a resposta completa, reasoning_content inclusa, no histórico da conversa. O teste solicitou um número aleatório de seis dígitos apenas no raciocínio e que a resposta fosse “ok”; na próxima iteração, foi pedido qual era esse número.
| Modelo | Raciocínio descartado | Raciocínio reproduzido |
|---|---|---|
| MiniMax-M3 | 1 de 10 | 7 de 10 |
| MiniMax-M3.1-Flash | 0 de 10 | 8 de 10 |
| MiniMax-M2.5 | 2 de 10 | 6 de 10 |
Com o raciocínio desativado, o modelo produziu raciocínio em apenas 1 de cada 12 tentativas no caso que medimos, RD4-kettle-saddle; ao reproduzir os testes, o resultado foi 6 a 12 de 12 tentativas. O mecanismo de restrição suprimiu o processo de raciocínio, mas não o eliminou por completo. A correção consiste numa opção específica para cada provedor: ativada por padrão para o provedor que aponta para a API da MiniMax e desativada para todos os demais provedores. Além disso, foi adicionado um campo na requisição para que o raciocínio seja enviado pelo mesmo canal. A conversa avaliada permanece visível apenas como texto: o raciocínio é parte do contexto, não a resposta propriamente dita.

Um segundo vazamento ocorreu no ciclo de ferramentas: um assistente foi adicionado sem que houvesse uma chamada à ferramenta correspondente; como resultado, outra chamada foi feita, falhando numa verificação que esperava apenas uma. Nos transcritos armazenados, 45 chamadas de ferramentas foram descartadas; além disso, nos 3 casos em que se esperava “1 chamada de ferramenta”, uma nova chamada foi feita.
2. “Esgotaram-se os tokens” significava vazio, não parcial
Nossa placa processou 16.384 tokens de saída. O valor recomendado pelo fornecedor para os dois modelos maiores é 131.072 — oito vezes mais. Cada linha cuja resposta foi truncada estava vazia; não havia respostas parciais. Em todas as transcrições armazenadas, houve 13 casos de linhas vazias para o MiniMax-M3 e 10 para o MiniMax-M3.1-Flash — ou seja, 100% dos casos, enquanto nos dois modelos menores, cujas respostas são bem mais curtas, não houve nenhum caso assim. A própria execução na placa resultou em um número muito menor de casos: o MiniMax-M3 teve 2 linhas truncadas-vazias, ambas do caso WR1-ninth-string; já o MiniMax-M3.1-Flash não teve nenhum. Esse é o único caso que ainda influencia na pontuação final: no máximo +0,574 pontos para o M3 (e nada para o M3.1-Flash); porém essa pontuação pode ser zero, pois uma resposta não vazia ainda pode falhar nas verificações.
Ao executar novamente os casos que falharam, com o orçamento recomendado, os resultados mudaram completamente: um caso que anteriormente retornava finish=length, com 16.383 dos seus 16.384 tokens gastos em raciocínio e zero caracteres visíveis, agora retornou 131.072 tokens, resultando numa função Python completa de 8.897 caracteres; outro caso gerou um código com 4.466 caracteres. Ambos esses casos já foram removidos da lista, portanto não custaram nenhum ponto ao sistema. Por isso, o sistema mantém uma coluna chamada Room — sem ela, “orçamento igual” significaria “orçamento igual mais um valor zero silencioso para o modelo que demorou mais tempo para processar”.
3. A lista de modelos estava desatualizada
Três IDs no registro do fornecedor foram marcados como “aposentados”, mas o próprio endpoint de modelos do fornecedor ainda os listava; cada chamada feita retornava HTTP 404 com a mensagem “não está mais disponível” e o código 2069. Uma lista de modelos é apenas uma lista, não uma garantia: teste o modelo que você pretende avaliar — basta uma única chamada simples — e considere o fato de o endpoint o listar como um mero indício, nunca como prova concreta. Veja como c1 faz isso, além de detectar também situações de “aliasing”.

A mesma regra se aplica um passo antes. O próprio FAQ do fornecedor diz que as famílias M2.5 e M2.7 serão descontinuadas em 18 de novembro de 2026; além disso, no Plano M/Plano de Tokens, as solicitações destinadas a essas famílias foram automaticamente redirecionadas para o M3.1 Flash desde 19 de outubro de 2026. Verificamos isso em 2 de novembro de 2026: a API ainda retorna o ID solicitado; com reasoning_split: false, o ID do M3.1-Flash gera um erro HTTP 400, enquanto os IDs M2.5 e M2.7 retornam código 200 sem qualquer explicação. Do lado de fora, não é possível saber qual modelo está sendo utilizado. Portanto, se o FAQ se aplicar a esta conta, quatro dos seis registros do MiniMax correspondem ao M3.1-Flash sob outros nomes; sua variação (de 11,7 a 14,0) representa apenas a flutuação normal de um mesmo modelo, e não um ranking.
4. Uma pergunta avaliada pedia quatro coisas ao mesmo tempo
Um elemento “juiz” é algo do tipo “sim/não”; as letras maiúsculas indicam a dimensão que ele controla. Em um teste de role-play para adultos, um dos elementos “juízes” foi solicitado a confirmar quatro coisas ao mesmo tempo: se a ação estava descrita no texto, como ela foi encenada, se o personagem teve um clímax e se o nome do outro personagem foi mencionado. Uma resposta que incluía tudo, exceto o nome, recebeu um “não” como resposta; além disso, o fator de “intensidade emocional” também foi considerado negativo. O nome, por sua vez, era verificado separadamente, de modo que o mesmo detalhe acabou sendo avaliado duas vezes.
Medições feitas nas linhas armazenadas: dos 17 registros avaliados em relação àquele elemento composto, 10 não passaram na avaliação. O “fator de calor” de uma linha corresponde à soma das verificações de explicitidade que ela passou, mais um ponto adicional pela pontuação geral de explicitidade atribuída pelo juiz; portanto, um “não” reduz esse valor em um quarto. Além disso, as avaliações individuais são instáveis: no primeiro caso envolvendo adultos, ambas as linhas MiniMax obtiveram pontuação de 0,73, o que impossibilitou a distinção entre os “irmãos”; no segundo caso, o MiniMax-M3 obteve 0,89 contra 0,44. Em outro caso com adultos, a ordem se inverteu (0,0 para M3 contra 0,91 para M3.1-Flash). Uma única avaliação por caso serve apenas como amostra, não como um ranking.
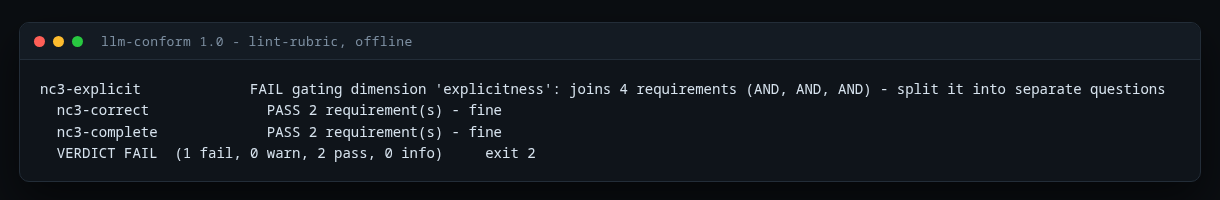
A correção divide o elemento em uma pergunta sobre a página e outra sobre o estágio de processamento; avalia o nome apenas uma vez e reavaliar os transcritos armazenados, em vez de gerá-los novamente. Também foi adicionado um verificador de regras: qualquer elemento cuja pergunta envolva mais de dois requisitos agora é considerado um erro; o texto pré-correção foi mantido como um ponto de referência para testes. Todo o conjunto de casos passa nesse verificador: 463 elementos de avaliação em 393 casos. Uma linha foi avaliada sob ambas as perguntas e falhou em ambas — realmente não cumpriu os requisitos — com fator de dificuldade de 0,75 e pontuação do caso de 0,62. A correção eliminou uma penalidade injusta; porém não “salvou” um modelo que simplesmente não cumpriu sua função.
5. Uma correção adequada ainda não move o tabuleiro
A correção lógica é comprovadamente correta: a mesma sonda passou de 0 de 3 itens recordados para 3 de 3, em todas as vezes, em três execuções separadas com quebra-cabeças diferentes. Além disso, o tabuleiro se moveu menos do que o permitido pela sua margem de erro: a sonda de cadeia mínima passou de 0 para 3; a pontuação da parte Deep RP aumentou de 0,2 para 0,4 pontos nos dois modelos M3. O valor geral também variou menos do que o permitido pela margem de erro. O MiniMax ignora o parâmetro seed, portanto cada linha do MiniMax representa uma amostra: dois casos do banco de códigos, com cinco execuções idênticas cada, resultaram em variações na taxa de acerto de 0,250 e 0,500.
Um caso de codificação foi aprovado em 01/11/2026 e reprovado em 02/11/2026, sob o mesmo ambiente de teste e com o mesmo prompt — duas execuções legítimas, mas com resultados opostos. A análise revelou outro problema: um fluxo de dados que terminou após o raciocínio, sem nenhum motivo explícito para término, foi considerado como uma resposta vazia concluída e recebeu nota zero. Agora esse caso é tratado como um fluxo interrompido e será reexecutado. Portanto, a ordem das operações é o que realmente importa: verifique o protocolo e depois repita a sessão antes de considerar que houve um movimento válido.
A causa raiz e a verificação que a detecta
Nenhum dos quatro defeitos era um erro no modelo ou no código de pontuação; além disso, eles não têm todos a mesma causa: a lista de modelos desatualizada é um problema do lado do fornecedor, o elemento de avaliação composto é uma questão de design do caso de teste, e o limite de tokens é uma escolha de configuração. Quatro causas raiz:
- O protocolo de solicitação para cada fornecedor e modelo foi assumido, mas nunca verificado em relação ao comportamento do modelo ou à documentação do fornecedor.
- Nada comprovava, para cada modelo, que a conversa enviada pelo “harness” era algo que o modelo pudesse processar.
- As linhas dos registros não indicavam qual protocolo as gerou, de modo que uma correção no “harness” não conseguia identificar quais linhas estavam desatualizadas.
- O verificador de caso de teste não detectava questões compostas que exigiam múltiplas condições para serem avaliadas.
A correção consiste em uma etapa de conformidade antes de cada teste de desempenho; não se trata de um caso especial no “runner”. São seis verificações por modelo — cerca de 21 solicitações à API por modo de execução — feitas através do próprio caminho de solicitação do “harness”; nunca são utilizadas solicitações criadas manualmente, pois isso tornaria a verificação inútil. O registro gerado contém uma “impressão digital” do protocolo utilizado, permitindo assim detectar qualquer alteração no “harness”.
O kit disponível para download representa essa etapa de verificação; ele foi extraído para funcionar em qualquer endpoint compatível com a OpenAI: as mesmas seis verificações, os mesmos arquivos de evidência, o verificador de rubricas e um conjunto de 44 testes offline contra um endpoint local fictício. Trata-se de um download gratuito, não de uma assinatura. O que ele não faz é indicar qual modelo é melhor — isso é tarefa sua; para obter uma avaliação honesta, são necessárias repetições e a definição de uma margem de erro.
O que isso significa para nós
As famílias de produtos M2.5 e M2.7 serão descontinuadas em 18 de novembro de 2026 — quatro das seis linhas de produtos MiniMax. O tráfego planejado para essas linhas será redirecionado para outro modelo; portanto, é preciso tomar uma decisão a respeito delas antes dessa data. O comando crucibleforge conform já existe e detectou o defeito no raciocínio lógico; o próximo passo é fazer com que o benchmark rejeite modelos que não atendam aos critérios, mas isso ainda não foi feito. Ainda nos falta o número necessário de repetições para classificar qualquer coisa dentro de uma faixa de um ponto — e essa faixa representa a resposta correta.
Relacionado: a própria ferramenta de benchmark (276 casos, 166 considerados difíceis), quanto nossos agentes de IA realmente custam, MiniMax M3 como agente de programação e StudioForge.
Downloads
Gratuito para uso pessoal. Se isso te economizar uma tarde, o botão do café está logo ali.