4 Defectos en el entrenamiento que distorsionaron mis puntuaciones de referencia para el LLM
- Categoría
- IA y LLM Local
- Publicado
- 2 noviembre 2026
- Actualizado
- 2 noviembre 2026
- Por
- Jacob Lloyd — escrito con ayuda de IA, después del proyecto
- Tiempo de lectura
- 13 min de lectura

En palabras simples: Nuestro punto de referencia para LLM indicó que un modelo nuevo era peor que uno anterior. En general, tenía razón; pero eso era en gran medida irrelevante: lo importante eran cuatro errores en el propio entorno de pruebas. Esta página muestra cuánto costaba cada error, cómo detectarlo y un kit gratuito en Python que permite verificar su propio entorno de pruebas antes de confiar en cualquier puntuación.
En la ejecución nocturna que finalizó a medianoche del 2 de noviembre de 2026, un nuevo modelo alojado obtuvo una puntuación inferior a la de su predecesor: 13,3 de 20 para el MiniMax-M3.1-Flash, frente a 14,2 para el MiniMax-M2.5. La parte de la puntuación en la que no podíamos confiar provenía de nuestro sistema de medición.
Resumen
- La puntuación era en su mayoría real; lo interesante no lo era. Una auditoría determinó que dos defectos en el sistema de medición añadían entre +0,4 y +1,7 puntos; la puntuación real se situaría entre 13,7 y 14,9. La diferencia con los modelos líderes era consecuencia de la verdadera calidad del modelo.
- Tres comportamientos erróneos hacen que un modelo parezca “tonto”. Uno de ellos es omitir el razonamiento: la misma prueba arrojó 0 de 10 sin ese componente, y 8 de 10 con él. Las filas marcadas como “Se agotaron los tokens” estaban vacías en todos los casos (13 de 13, 10 de 10 en todos los registros); nunca hubo resultados parciales. Una lista de modelos no es una garantía: tres identificadores retirados seguían apareciendo en ella, y todas las consultas devolvían error 404.
- Una pregunta evaluada pedía cuatro cosas a la vez. Un elemento de evaluación debe ser un simple “sí” o “no”; por eso una respuesta que describía correctamente la escena pero omitía uno de los puntos requeridos se consideró un fallo total, lo cual afectó también al factor de “calor”.
- Una solución teóricamente correcta no equivale a una medición válida. El margen de error es de 0,8 a 1,8 puntos; la corrección aplicada al razonamiento del modelo apenas influyó en la puntuación global. Un caso de codificación aprobó el 1 de noviembre de 2026 pero falló el 2 de noviembre bajo el mismo sistema de medición.
¿Qué obtienes al final?
Un archivo zip gratuito, llm-conform 1.0, que responde a una pregunta por cada modelo que sometas a prueba: ¿mi entorno de pruebas es compatible con el protocolo de este modelo? Se realizan seis verificaciones a través de tu propia ruta de solicitud; en total, unas 21 solicitudes a la API por cada modo de reproducción. Las pruebas y sus resultados se guardan junto a cada una.
$ python3 llm_conform.py --config my-config.toml

MODEL my-model  (https://api.example.com/v1)
  c1   PASS  served; endpoint reports model 'my-model'
  c2   PASS  reasoning arrives via 'reasoning_content'; answer text is clean
  c3   FAIL  your replay mode loses this model's reasoning: 'content-only' recalled 0/3
              but 'reasoning_content' recalled 3/3 - use reasoning_content
  c4   WARN  tool round trip ok (lookup_record -> result -> answer); an unanswered tool call
              is tolerated by the endpoint, but it must still be answered or removed
  c5   PASS  the sampler was accepted
  c6   PASS  a medium task fits in max_tokens=4096 (finish_reason=stop)

  VERDICT FAIL  (1 fail, 1 warn, 4 pass, 0 info)
El código de salida es 0 cuando todas las verificaciones se superan; 1 indica una advertencia y 2 indica un fallo, por lo que puede integrarse fácilmente en sistemas de integración continua. No se requieren paquetes ni proveedores externos: los ejemplos utilizan https://api.example.com/v1, my-model y $MY_API_KEY.
¿Qué cuatro defectos ocultó nuestro benchmark de LLM?
El tablero tras las correcciones. El símbolo ± que aparece junto a cada puntuación representa la mitad del intervalo bootstrap del 90% calculado sobre los casos analizados. El tablero considera que dos filas están empatadas cuando el intervalo del 90% de sus diferencias incluye el valor 0; no cuando las barras de error se solapan visualmente.

| Modelo | Antes | Después de las correcciones | Margen posible |
|---|---|---|---|
| MiniMax-M3.1-Flash | 13,3 | 13,5 ± 1,6 | 14,3 |
| MiniMax-M3 | 13,4 | 14,4 ± 1,6 | 15,3 |
| MiniMax-M2.5 | 14,2 | 11,7 ± 1,8 | = |
| MiniMax-M2.5-highspeed | 12,8 | 14,0 ± 0,8 | = |
| MiniMax-M2.7-highspeed | 13,8 | 13,5 ± 1,1 | = |
| MiniMax-M2.7 | 12,6 | 12,6 ± 1,8 | = |
| deepseek-flash | 19,2 | 19,2 ± 0,8 | — |
| deepseek-pro | 17,5 | 17,5 ± 0,8 | — |
“Antes” se refiere al estado del tablero el 2 de noviembre de 2026 por la mañana; “después” indica el tablero reconstruido a las 20:18 y actualizado a las 20:55, tras volver a ejecutar dos filas. El valor en la columna Margen posible representa la puntuación máxima que se podría obtener si se volvieran a ejecutar las filas fuera del presupuesto asignado. El mayor cambio fue el descenso de 2,5 puntos en MiniMax-M2.5: su puntuación en la categoría de codificación bajó de 5,0 a 3,1; un dato que la corrección no logró modificar.
1. El entorno de pruebas descartaba el razonamiento del modelo
Nuestro sistema de ejecución multi-turno enviaba únicamente el texto visible generado por el asistente. Sin embargo, la documentación de MiniMax exige enviar toda la respuesta completa, reasoning_content incluido, en el historial de conversación. La prueba solicitaba un número aleatorio de seis dígitos solo dentro del razonamiento y que el modelo respondiera “ok”; luego se preguntaba cuál era ese número.
| Modelo | Razonamiento descartado | Razonamiento reenviado |
|---|---|---|
| MiniMax-M3 | 1 de 10 | 7 de 10 |
| MiniMax-M3.1-Flash | 0 de 10 | 8 de 10 |
| MiniMax-M2.5 | 2 de 10 | 6 de 10 |
Cuando el razonamiento se descartaba, el modelo generaba respuestas basadas en ese razonamiento en solo 1 de cada 12 turnos evaluados; al reenviarlo, lo hacía en entre 6 y 12 de cada 12 turnos. El entorno de pruebas suprimía el razonamiento, pero no lo eliminaba. La solución implementada consiste en un interruptor por proveedor: activado por defecto para el API de MiniMax y desactivado para todos los demás; además se añadió un campo en las solicitudes para que el razonamiento llegue al mismo canal. El contenido evaluado sigue siendo solo el texto visible: el razonamiento es contexto, no respuesta.

Otro fallo residía en el bucle de herramientas: un turno del asistente se añadía sin su correspondiente llamada a la herramienta, lo cual generaba una segunda llamada; esto incumplía una comprobación que exige una sola llamada. En los registros analizados, 45 llamadas a herramientas se perdieron; además, en 3 de 3 casos donde se esperaba una única llamada, el sistema volvió a enviarla.
2. “Se agotaron los tokens” significaba respuesta vacía, no parcial
Nuestro tablero utilizaba un límite de 16.384 tokens para las respuestas generadas. El proveedor recomienda un valor ocho veces mayor, 131.072 tokens, para sus dos modelos más grandes. Todas las filas truncadas resultaron estar vacías, sin ninguna respuesta parcial: en los registros analizados, el 100% de las filas correspondientes a MiniMax-M3 y MiniMax-M3.1-Flash quedaron vacías; en cambio, los modelos más pequeños, cuyo razonamiento es mucho más breve, no presentaron este problema. En la propia ejecución del tablero, MiniMax-M3 tuvo 2 filas truncadas y vacías (ambas correspondientes al caso WR1-ninth-string); MiniMax-M3.1-Flash no tuvo ninguna. Este único caso sigue influyendo en las puntuaciones: aporta un máximo de +0,574 puntos para M3 (y nada para M3.1-Flash), aunque podría ser cero, ya que una respuesta no vacía podría aún incumplir las comprobaciones exigidas.
Al volver a ejecutar los casos problemáticos con el presupuesto recomendado, las respuestas vacías se transformaron en respuestas completas: un caso que originalmente devolvía finish=length con 16.383 de sus 16.384 tokens dedicados al razonamiento y ningún carácter visible, ahora generaba una función Python de 8.897 caracteres; otro caso arrojó 4.466 caracteres. Ambos casos ya fueron retirados del tablero, por lo que no afectan las puntuaciones globales. Por eso el tablero incluye la columna Margen posible: sin ella, “igual presupuesto” equivaldría a “igual presupuesto más un cero silencioso para el modelo que más piensa”.
3. La lista de modelos estaba desactualizada
Tres identificadores en el registro del proveedor aparecían marcados como retirados; sin embargo, su propio endpoint de modelos los seguía mostrando y toda solicitud devolvía HTTP 404 con el mensaje “ya no disponible” y el código 2069. Una lista de modelos es solo un registro, no una garantía: hay que probar el modelo que se va a evaluar mediante una simple llamada; considerar que “el endpoint lo lista” como una pista, nunca como prueba definitiva. La herramienta c1 realiza esta comprobación y también detecta posibles alias.

La misma regla se aplica un paso antes. El FAQ del proveedor indica que las familias M2.5 y M2.7 se retirarán el 18 de noviembre de 2026; además, en los planes M y Token, desde el 19 de octubre de 2026, las solicitudes dirigidas a esos modelos se redirigen automáticamente a MiniMax-M3.1-Flash. Nosotros lo comprobamos el 2 de noviembre de 2026: el API seguía devolviendo los identificadores solicitados; con reasoning_split: false, el identificador de M3.1-Flash generaba HTTP 400, mientras que los de M2.5 y M2.7 devolvían código 200 sin incluir razonamiento alguno. Desde fuera no se puede saber cuál modelo atiende realmente la solicitud. Por tanto, si el FAQ es aplicable a esta cuenta, cuatro de las seis filas de MiniMax corresponden en realidad a M3.1-Flash bajo otros nombres; su rango de puntuaciones (11,7 a 14,0) refleja simplemente la variabilidad natural entre ejecuciones de un mismo modelo, no un verdadero ranking.
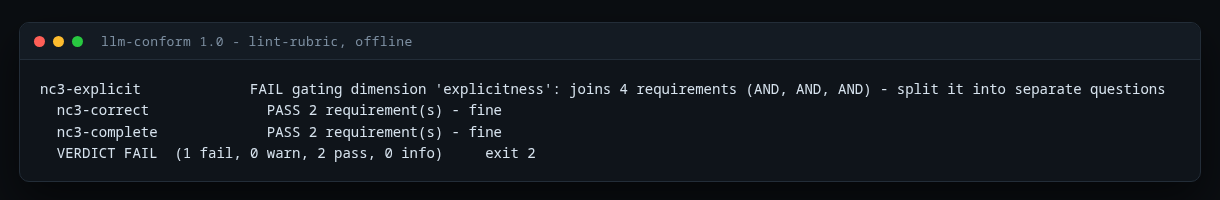
4. Una pregunta evaluada pedía cuatro cosas a la vez
Cada elemento de evaluación debe ser una pregunta binaria (sí/no); además, el texto correspondiente indica qué dimensión se está valorando. En una prueba de juego de roles para adultos, un elemento pedía al evaluador confirmar cuatro aspectos simultáneamente: si la acción aparecía en el texto, cómo se desarrollaba escénicamente, si el personaje alcanzaba el clímax y si se mencionaba el nombre del otro personaje. Una respuesta que incluía todo excepto el nombre obtenía un “no” global; además, el nombre se comprobaba por separado, de modo que ese detalle se valoraba dos veces.
Analizando los registros: de las 17 filas evaluadas según este elemento compuesto, 10 fallaron. El factor de “intensidad” de cada fila se calcula sumando el porcentaje de comprobaciones de claridad superadas más un voto adicional por la valoración global del evaluador; por eso un solo “no” reduce ese factor en una cuarta parte. Además, cada sesión es poco estable: en el primer caso para adultos ambas filas de MiniMax obtuvieron 0,73, imposibilitando diferenciarlas; en otro caso, MiniMax-M3 superó a su hermano con 0,89 frente a 0,44; en un tercer caso, el orden se invirtió (0,0 para M3 contra 0,91 para M3.1-Flash). Una sola sesión por caso no permite establecer un ranking fiable.
La corrección consiste en dividir ese elemento en dos preguntas distintas —una sobre el texto y otra sobre la puesta en escena—, valorar el nombre una sola vez y reevaluar los registros existentes sin necesidad de regenerarlos. También se incorporó un control: cualquier elemento evaluador cuyo enunciado combine más de dos requisitos ahora se considera un error; el texto anterior a la corrección se mantiene como referencia para posibles regresiones. Todo el conjunto de casos pasa este control: 463 elementos evaluadores distribuidos en 393 casos. Una fila fue calificada negativamente en ambas preguntas; realmente omitió ese detalle, con un factor de intensidad de 0,75 y una puntuación final de 0,62. La corrección eliminó un castigo injusto; no “salvó” a un modelo que sencillamente no cumplió con lo requerido.
5. Incluso una corrección correcta apenas mueve el tablero
La corrección del razonamiento es técnicamente correcta: la misma prueba pasó de 0 aciertos a 3 de 3 en tres ejecuciones distintas con rompecabezas diferentes. No obstante, el tablero apenas se movió respecto a su propia barra de error: la prueba en cadena subió de 0 a 3; la parte Deep RP del puntaje aumentó entre 0,2 y 0,4 puntos en ambos modelos M3; el total global varió menos que su margen ±. MiniMax ignora el parámetro seed, por lo que cada fila representa una única muestra; en dos casos de codificación, con cinco ejecuciones idénticas cada uno, las variaciones entre resultados fueron de 0,250 y 0,500 puntos.
Un caso de codificación aprobó el 1 de noviembre de 2026 pero falló al día siguiente bajo el mismo entorno y con el mismo enunciado: dos ejecuciones idénticas, resultados opuestos. Al investigarlo se halló otro fallo: un flujo que terminaba tras el razonamiento, sin motivo de finalización, se consideraba una respuesta vacía completa y se calificaba con cero puntos. Ahora ese caso se trata como un flujo perdido y se vuelve a ejecutar. Por tanto, el orden correcto de operaciones es: verificar primero el protocolo; luego repetir la sesión antes de dar por válido cualquier cambio de un punto en las puntuaciones.
La causa raíz y la comprobación que la detecta
Ninguno de los cuatro defectos era un error en el modelo ni en el código de puntuación; además, no todos tienen la misma causa: la lista de modelos obsoleta depende del proveedor, el elemento de evaluación compuesto es parte del diseño del caso de prueba, y el límite de tokens es una opción de configuración. Cuatro causas raíz:
- Se asumió el protocolo de solicitud para cada proveedor y modelo, sin verificarlo en relación con el comportamiento del modelo o la documentación del proveedor.
- No se comprobó, por modelo, si la conversación que envía el entorno de pruebas es una que el modelo puede procesar.
- Las filas de datos no registraban el protocolo que las generó, por lo que una corrección en el entorno de pruebas no podía determinar qué filas estaban obsoletas.
- El linter de casos de prueba no detectaba preguntas compuestas que requieren condiciones múltiples para ser respondidas.
La solución consiste en realizar una serie de comprobaciones de conformidad antes de cada evaluación, no en implementar casos especiales en el entorno de pruebas: se realizan seis comprobaciones por modelo —unas 21 solicitudes a la API por modo de reproducción— mediante la propia ruta de solicitudes del entorno de pruebas; nunca se utilizan solicitudes manualmente creadas, pues eso haría que dichas comprobaciones no tuvieran validez alguna. El registro que se genera incluye una “huella” del protocolo utilizado, lo cual permite detectar cualquier cambio en el entorno de pruebas.
El paquete disponible para descarga contiene ese proceso de comprobación, adaptado para funcionar con cualquier endpoint compatible con OpenAI: las mismas seis comprobaciones, los mismos archivos de evidencia, el linter correspondiente y un conjunto de 44 pruebas offline que se ejecutan contra un endpoint local ficticio. Se trata de una descarga, no de una suscripción. Lo que este paquete no hará es indicarle qué modelo es mejor; eso depende de usted; además, para obtener resultados fiables se requieren múltiples repeticiones y un margen de error publicado.
¿En qué punto nos dejamos?
Las familias de modelos M2.5 y M2.7 se retirarán el 18 de noviembre de 2026; se trata de cuatro de las seis filas de MiniMax. La planificación del tráfico hacia otros modelos ya está en marcha, por lo que es necesario tomar una decisión respecto a esas filas antes de esa fecha. El comando crucibleforge conform existe y detectó el defecto lógico en tiempo real; el siguiente paso es hacer que el benchmark rechace cualquier modelo que no cumpla con sus requisitos, algo que aún no se ha hecho. Además, todavía nos faltan las repeticiones necesarias para poder clasificar modelos dentro de un rango de un punto; ese rango es, en realidad, la respuesta correcta.
Relacionado: la herramienta de benchmarking en sí (276 casos, 166 difíciles), cuánto cuestan realmente nuestros agentes de IA, MiniMax M3 como agente de programación y StudioForge.
Descargas
Gratis para uso personal. Si te ahorra una tarde, el botón del café está aquí cerca.