4 Défauts de mise en œuvre qui ont faussé mes scores de référence pour les LLM
- Catégorie
- IA et LLM locaux
- Publié
- 2 novembre 2026
- Mis à jour
- 2 novembre 2026
- Par
- Jacob Lloyd — rédigé avec l'aide de l'IA, une fois le projet terminé
- Temps de lecture
- 14 min de lecture

En clair : Notre benchmark de LLM indiquait qu’un nouveau modèle était moins performant qu’un modèle plus ancien. Ce résultat était en grande partie correct, mais aussi en grande partie sans pertinence : le vrai problème provenait de quatre bogues dans l’infrastructure de test elle-même. Cette page détaille le coût de chaque bogue, comment les détecter, ainsi qu’un kit Python gratuit permettant de vérifier votre propre infrastructure avant de faire confiance à un score.
Lors de l’exécution nocturne qui s’est terminée à minuit le 2 novembre 2026, un nouveau modèle hébergé a obtenu un score inférieur à son prédécesseur : 13,3 sur 20 pour MiniMax-M3.1-Flash contre 14,2 pour MiniMax-M2.5. La partie du score dont nous ne pouvions pas être sûrs provenait de notre environnement de test.
En bref
- Le score était pour l’essentiel fiable ; ce qui n’était pas fiable, c’étaient les résultats liés à l’environnement de test. Une vérification a révélé que deux défauts de cet environnement ajoutaient entre +0,4 et +1,7 point au score ; le vrai score se situait donc entre 13,7 et 14,9. L’écart avec les modèles leaders reflétait bien la qualité réelle du modèle.
- Trois comportements de l’environnement de test font paraître un modèle stupide. Le fait de supprimer le raisonnement en est un exemple : la même évaluation n’a donné aucun bon résultat sans ce mécanisme, contre 8 bons résultats sur 10 avec. Les lignes indiquant « plus de tokens disponibles » étaient toutes vides (13 cas sur 13, 10 cas sur 10 dans tous les enregistrements), jamais partiellement remplies. Une liste de modèles n’est qu’une liste, pas une garantie : trois identifiants de modèles retirés de la circulation y figuraient encore, et chaque appel à ces modèles renvoyait une erreur 404.
- Une seule question d’évaluation demandait en réalité quatre choses à la fois. Un élément d’évaluation ne devrait permettre qu’une réponse oui/non ; ainsi, une réponse décrivant correctement la scène mais omettant un détail a été considérée comme une mauvaise réponse, entraînant également une pénalité liée au facteur de complexité.
- Une correction théoriquement valide ne constitue pas pour autant une mesure fiable. La marge d’erreur est comprise entre 0,8 et 1,8 point ; la correction apportée au mécanisme de raisonnement n’a fait varier le score global que de moins que cette marge. Un cas de codage a été validé le 1er novembre 2026 puis rejeté le 2 novembre 2026, toujours dans le même environnement de test.
Résultat final
Un outil zip gratuit, llm-conform 1.0, qui répond à une seule question pour chaque modèle que vous testez : mon harnais respecte-t-il le protocole de ce modèle ? Six vérifications s’effectuent via votre propre chemin de requête – environ 21 requêtes API par mode de relecture – avec les preuves enregistrées à côté de chaque résultat.
$ python3 llm_conform.py --config my-config.toml

MODEL my-model  (https://api.example.com/v1)
  c1   PASS  served; endpoint reports model 'my-model'
  c2   PASS  reasoning arrives via 'reasoning_content'; answer text is clean
  c3   FAIL  your replay mode loses this model's reasoning: 'content-only' recalled 0/3
              but 'reasoning_content' recalled 3/3 - use reasoning_content
  c4   WARN  tool round trip ok (lookup_record -> result -> answer); an unanswered tool call
              is tolerated by the endpoint, but it must still be answered or removed
  c5   PASS  the sampler was accepted
  c6   PASS  a medium task fits in max_tokens=4096 (finish_reason=stop)

  VERDICT FAIL  (1 fail, 1 warn, 4 pass, 0 info)
Le code de sortie vaut 0 si toutes les vérifications sont réussies, 1 en cas d’avertissement et 2 en cas d’échec ; il peut ainsi être intégré à un système CI. Pas de paquets ni de fournisseurs nécessaires : les exemples utilisent https://api.example.com/v1, my-model et $MY_API_KEY.
Quels quatre défauts notre benchmark de LLM a-t-il masqués ?
Le tableau après les corrections. Le symbole ± qui suit un score représente la moitié de l’intervalle de bootstrap à 90 % calculé sur l’ensemble des cas. Le tableau considère deux lignes comme étant à égalité lorsque l’intervalle de 90 % relatif à leur différence contient 0, et non lorsque les barres d’erreur respectives se chevauchent.

| Modèle | Avant | Après les corrections | Score avec réévaluation |
|---|---|---|---|
| MiniMax-M3.1-Flash | 13,3 | 13,5 ± 1,6 | 14,3 |
| MiniMax-M3 | 13,4 | 14,4 ± 1,6 | 15,3 |
| MiniMax-M2.5 | 14,2 | 11,7 ± 1,8 | = |
| MiniMax-M2.5-highspeed | 12,8 | 14,0 ± 0,8 | = |
| MiniMax-M2.7-highspeed | 13,8 | 13,5 ± 1,1 | = |
| MiniMax-M2.7 | 12,6 | 12,6 ± 1,8 | = |
| deepseek-flash | 19,2 | 19,2 ± 0,8 | — |
| deepseek-pro | 17,5 | 17,5 ± 0,8 | — |
« Avant » correspond au tableau du 2 novembre 2026 le matin ; « après » désigne le tableau reconstruit à 20h18 puis mis à jour à 20h55, après avoir relancé deux lignes. Le champ Score avec réévaluation indique les valeurs obtenues après avoir recalculé les scores des lignes sortant du budget initial. La plus grande baisse est observée pour MiniMax-M2.5, qui perd 2,5 points : son sous-score « Func » a chuté de 5,0 à 3,1 ; il s’agit d’un aspect du codage en une seule passe sur lequel la correction n’a aucune prise.
1. Le harnais a supprimé le raisonnement
Notre exécuteur multi-tours ne renvoyait que le texte visible de chaque tour du modèle. La documentation de MiniMax exige pourtant le contraire : la réponse complète, reasoning_content incluse, doit figurer dans l’historique de la conversation. Le test demandait un nombre à six chiffres aléatoire dans le raisonnement uniquement, puis attendait une réponse « ok » ; au tour suivant, il demandait quel était ce nombre.
| Modèle | Raisonnement supprimé | Raisonnement rejoué |
|---|---|---|
| MiniMax-M3 | 1 sur 10 | 7 sur 10 |
| MiniMax-M3.1-Flash | 0 sur 10 | 8 sur 10 |
| MiniMax-M2.5 | 2 sur 10 | 6 sur 10 |
Lorsque le raisonnement était supprimé, le modèle produisait un raisonnement dans 1 cas sur 12 lors de notre test (RD4-kettle-saddle) ; en le rejouant, ce chiffre passait à 6 à 12 cas sur 12. Le harnais a donc simplement supprimé le raisonnement sans le perdre pour autant. La correction consiste en un commutateur spécifique à chaque fournisseur : activé par défaut pour les requêtes adressées à l’API de MiniMax et désactivé pour tous les autres fournisseurs, ainsi qu’en un champ de requête permettant d’envoyer le raisonnement dans le même canal. La conversation évaluée ne contient que du texte visible : le raisonnement sert de contexte, pas de réponse.

Une autre faille se trouvait dans la boucle d’outils : un tour du modèle était ajouté sans son appel d’outil ni son résultat, ce qui donnait l’impression qu’il s’agissait d’un second appel, violant ainsi une vérification exigeant un seul appel. Sur l’ensemble des transcriptions enregistrées, 45 appels d’outil ont été omis ; par ailleurs, sur les 3 cas signalés comme « N appels d’outil, alors qu’un seul était attendu », un nouvel appel a été effectué à chaque fois.
2. « Plus de tokens disponibles » signifie vide, pas partiellement rempli
Notre tableau de résultats prenait en compte 16 384 tokens de sortie. La valeur recommandée par le fournisseur pour les deux grands modèles est de 131 072 — soit huit fois plus. Chaque ligne tronquée était vide, sans aucune réponse partielle : sur l’ensemble des transcriptions enregistrées, on compte 13 cas sur 13 pour MiniMax-M3 et 10 sur 10 pour MiniMax-M3.1-Flash, soit 100 % de résultats vides ; aucun cas vide n’a été observé pour les deux modèles plus petits, dont les raisonnements sont nettement plus courts. La simulation elle-même ne concerne qu’une portion bien plus réduite : MiniMax-M3 présentait 2 lignes tronquées-vides, toutes deux issues du cas WR1-ninth-string ; MiniMax-M3.1-Flash n’en avait aucune. Ce seul cas permet encore d’obtenir des points : au maximum +0,574 point pour M3 (et rien pour M3.1-Flash), mais ce chiffre pourrait aussi être zéro, car une réponse non vide pourrait tout de même échouer aux vérifications.
En relançant les cas qui échouaient avec le budget recommandé, les résultats nuls se sont transformés en réponses concrètes : un cas affichant finish=length, où 16 383 des 16 384 tokens avaient été utilisés pour le raisonnement sans qu’aucun caractère ne soit visible, a donné à 131 072 tokens une fonction Python complète de 8 897 caractères ; un autre cas a produit une réponse de 4 466 caractères. Ces deux cas ont depuis été retirés du tableau de résultats, donc ils ne rapportent plus aucun point. C’est pourquoi le tableau conserve une colonne Room : sans elle, « budget égal » signifierait en réalité « budget égal plus un zéro silencieux pour le modèle qui réfléchit le plus longtemps ».
3. La liste des modèles était obsolète
Trois identifiants dans le registre du fournisseur étaient marqués comme « retirés », mais l’endpoint de modèles du fournisseur les listait toujours ; chaque appel renvoyait un code HTTP 404 accompagné du message « plus disponible » ainsi que le code 2069. Une liste de modèles n’est qu’une liste, pas une garantie : testez le modèle que vous comptez évaluer – un simple appel suffit – et considérez le fait que « l’endpoint le liste » comme un indice, jamais comme une preuve formelle. Vérifiez que c1 effectue ce test, et détecte également les cas d’alias.

La même règle s’applique une étape avant. La FAQ du fournisseur indique que les familles de modèles M2.5 et M2.7 seront retirées le 18/11/2026 ; sur les plans M Plan / Token Plan, les requêtes destinées à ces modèles sont automatiquement redirigées vers M3.1 Flash depuis le 19/10/2026. Nous avons testé cela le 02/11/2026 : l’API indique toujours les identifiants demandés ; avec reasoning_split: false, l’identifiant M3.1-Flash renvoie un code HTTP 400, tandis que les identifiants M2.5 et M2.7 renvoient un code 200 sans aucune réponse de raisonnement. De l’extérieur, on ne peut donc pas savoir quel modèle est servi. Ainsi, si la FAQ s’applique à ce compte, quatre des six entrées MiniMax correspondent en réalité à M3.1-Flash sous d’autres noms ; les valeurs obtenues (de 11,7 à 14,0) ne reflètent que la variabilité naturelle d’un même modèle lors de différents tests, et non un véritable classement.
4. Une question de jugement demandait quatre choses à la fois
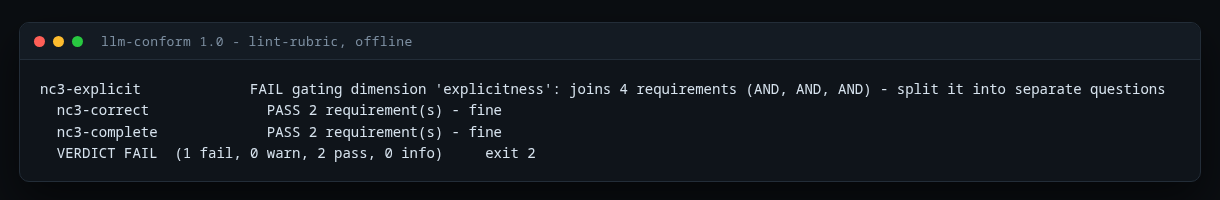
Un élément de jugement est une simple réponse oui/non ; le texte associé indique la dimension qu’il évalue. Dans un test de jeu de rôle pour adultes, un élément demandait au juge de confirmer quatre choses simultanément : si l’acte décrit figurait bien dans le texte, comment il était mis en scène, si le personnage avait atteint son climax, et si le nom de l’autre personnage avait été mentionné. Une réponse donnant toutes les informations sauf le nom recevait la note « non » ; en outre, le nom était vérifié séparément, si bien que ce même détail était évalué deux fois.
D’après les données stockées : sur les 17 lignes ayant été jugées selon cet élément composite, 10 ont échoué. Le « facteur de clarté » d’une ligne correspond à la somme des vérifications réussies plus un point attribué au score global de clarté du juge ; ainsi, une réponse négative fait chuter ce facteur d’un quart. De plus, les sessions isolées donnent des résultats erratiques : dans le premier cas pour adultes, les deux versions MiniMax obtiennent un score de 0,73, empêchant toute distinction entre elles ; dans un autre cas, MiniMax-M3 l’emporte avec 0,89 contre 0,44. Dans un troisième cas, l’ordre s’inverse (0,0 pour M3 contre 0,91 pour M3.1-Flash). Une seule session par cas ne constitue qu’un échantillon, pas un classement.
La correction consiste à diviser cet élément en deux questions distinctes — l’une portant sur le texte et l’autre sur la mise en scène — à ne noter le nom qu’une seule fois, puis à rejuger les transcriptions existantes sans les régénérer. Un contrôle supplémentaire a également été ajouté : tout élément de jugement dont la question regroupe plus de deux exigences est désormais considéré comme erroné ; le texte d’avant correction reste conservé à titre de référence de régression. L’ensemble des cas respecte ce contrôle : 463 éléments de jugement au total, couvrant 393 cas. Une seule ligne a été jugée selon les deux questions et a échoué dans les deux cas — elle ne mentionnait effectivement pas le nom requis ; son facteur de clarté était alors de 0,75 et son score global de 0,62. Cette correction a supprimé une pénalité injuste ; elle n’a toutefois pas permis à un modèle incapable d’accomplir la tâche d’obtenir un meilleur résultat.
5. Une correction correcte ne fait toujours pas bouger le tableau
La correction apportée au raisonnement est prouvément correcte : le même test est passé de 0 sur 3 réponses correctes à 3 sur 3, à chaque fois, lors de trois exécutions distinctes avec des puzzles différents. De plus, le tableau s’est déplacé de moins que sa propre marge d’erreur : le test de chaîne minimale est passé de 0 à 3 ; la partie « Deep RP » du score a augmenté de 0,2 à 0,4 point sur les deux modèles M3. Quant à « Overall », son évolution est inférieure à sa marge d’erreur ±. MiniMax ignore le paramètre seed ; par conséquent, chaque ligne MiniMax représente un seul échantillon : deux cas de codebank, avec cinq exécutions identiques chacun, ont donné des écarts de taux d’élément de 0,250 et 0,500.
Un cas de codage a été validé le 2026-11-01 puis échoué le 2026-11-02, sous le même environnement de test et avec le même prompt — deux exécutions légitimes, mais avec des résultats opposés. Une vérification ultérieure a révélé un second bug : un flux de données se terminant après le raisonnement, sans aucune indication de fin, était considéré comme une réponse vide valide et recevait une note de zéro. Ce flux est désormais traité comme un échec et doit être retenté. L’ordre des opérations est donc l’élément crucial à respecter : vérifiez d’abord le protocole, puis relancez la session avant de croire à un déplacement d’un seul point.
La cause racine et le contrôle qui la détecte
Aucun des quatre défauts n’était un bug dans un modèle ou dans le code de notation ; en outre, ils n’ont pas tous la même cause : la liste des modèles obsolète provient du côté du fournisseur, l’élément de jugement composé relève de la conception du cas d’usage, et le budget de tokens est un choix de configuration. Quatre causes racines :
- Le protocole de requête par fournisseur et par modèle a été supposé, sans jamais être vérifié par rapport au comportement du modèle ou à la documentation du fournisseur.
- Rien ne prouve, pour chaque modèle, que la conversation envoyée par le harnais est utilisable par celui-ci.
- Les lignes de données ne mentionnaient pas le protocole ayant généré ces données, si bien qu’une correction du harnais ne permettait pas d’identifier les lignes obsolètes.
- Le contrôleur de validation des cas d’usage ne détectait pas les questions de type “gating” composées.
La solution consiste en une étape de conformité à effectuer avant chaque benchmark, et non en un traitement spécial dans le programme d’exécution : six contrôles par modèle — soit environ 21 requêtes API par mode de simulation — via le propre mécanisme de requêtes du harnais ; jamais de requêtes manuellement écrites, car cela ne permettrait pas de valider le bon fonctionnement du harnais. Les enregistrements générés contiennent une empreinte du protocole utilisé, ce qui permet de détecter toute modification apportée au harnais.
Le kit téléchargeable correspond à cette étape de contrôle ; il a été conçu pour fonctionner avec n’importe quel endpoint compatible OpenAI : les mêmes six contrôles, les mêmes fichiers de preuves, le contrôleur de validation des cas d’usage et une suite de tests hors ligne comprenant 44 tests effectués sur un endpoint local fictif. Il s’agit d’un téléchargement unique, non d’un abonnement. Ce kit ne vous indiquera pas quel modèle est le meilleur — c’est à vous de le déterminer ; une évaluation honnête exige plusieurs répétitions ainsi qu’une estimation statistique des erreurs.
Où cela nous mène-t-il ?
Les familles de produits M2.5 et M2.7 seront retirées du marché le 18 novembre 2026 — il s’agit de quatre des six gammes MiniMax — et le trafic prévu pour elles sera redirigé vers un autre modèle ; il faut donc prendre une décision concernant ces gammes avant cette date. La commande crucibleforge conform existe déjà et a permis de détecter en temps réel le défaut logique en question ; la prochaine étape consistera à faire en sorte que le benchmark rejette tout modèle ne respectant pas les critères, mais cela n’a pas encore été mis en œuvre. Nous manquons toujours du nombre de répétitions nécessaires pour classer quoi que ce soit dans une plage d’une unité — et cette plage représente la réponse honnête.
Voir aussi : l’outil de benchmark lui-même (276 cas, dont 166 difficiles), le coût réel de nos agents IA, MiniMax M3 en tant qu’agent de programmation, ainsi que StudioForge.
Téléchargements
Gratuit pour un usage personnel. Si ça vous fait gagner un après-midi, le bouton café n'est pas loin.