4 Konstruktionsfehler, die meine Benchmark-Ergebnisse für das LLM verfälscht haben
- Kategorie
- KI & lokale LLMs
- Veröffentlicht
- 2 November 2026
- Aktualisiert
- 2 November 2026
- Von
- Jacob Lloyd — mit KI-Unterstützung geschrieben, im Nachhinein
- Lesezeit
- 12 Min. Lesezeit

Kurz gesagt: Unser LLM-Benchmark ergab, dass ein neues Modell schlechter abschnitt als ein älteres Modell. Das Ergebnis war größtenteils korrekt – doch im Grunde irrelevant: Das eigentliche Problem waren vier Fehler im Testframework selbst. Diese Seite zeigt, welche Folgen jeder Fehler hat, wie man ihn erkennen kann sowie ein kostenloses Python-Tool, mit dem Sie Ihr eigenes Testframework überprüfen können, bevor Sie einem Testergebnis vertrauen.
Beim Übernacht-Testlauf, der am 02.11.2026 um Mitternacht endete, erzielte ein neues gehostetes Modell eine schlechtere Bewertung als sein Vorgänger: 13,3 von 20 Punkten für MiniMax-M3.1-Flash im Vergleich zu 14,2 Punkten für MiniMax-M2.5. Der Teil der Ergebnisse, dem wir nicht trauen konnten, stammte von unserem Testframework.
Zusammenfassung
- Die Bewertung war größtenteils korrekt; das Interessante daran war sie nicht. Eine Überprüfung ergab, dass zwei Fehler im Testframework zu einem Punktezuwachs von etwa +0,4 bis +1,7 führten; der tatsächliche Wert lag also bei ca. 13,7 bis 14,9 Punkten. Die Differenz zu den Spitzenmodellen beruhte auf deren tatsächlicher Qualität.
- Drei Verhaltensweisen des Testframeworks lassen ein Modell dumm erscheinen. Zum Beispiel das Unterdrücken von logischem Denken: Bei derselben Abfrage wurden ohne diese Einschränkung 8 von 10 Antworten richtig gegeben, ohne sie nur 0 von 10. Einträge wie „Keine Tokens mehr verfügbar“ traten nie auf – weder teilweise noch vollständig. Eine Modellliste ist schließlich nur eine Liste, keine Garantie: Drei zurückgezogene Modelle wurden weiterhin aufgeführt; bei jedem Aufruf kam es zu einem 404-Fehler.
- Eine Bewertungsfrage verlangte gleichzeitig vier Antworten. Da ein Bewertungselement nur ein Ja/Nein erlaubt, wurde eine Antwort, die zwar die Situation beschrieb, aber eine der geforderten Antworten verpasste, als vollständiges Misserfolg gewertet – mit entsprechendem negativen Effekt auf die Gesamtbewertung.
- Eine nachweislich korrekte Korrektur ist dennoch keine zuverlässige Messgröße. Die Fehlertoleranz liegt bei 0,8 bis 1,8 Punkten; die „logische Korrektur“ änderte den Gesamtwert jedoch weniger stark. Ein Codierungsfall wurde am 01.11.2026 erfolgreich ausgeführt, am 02.11.2026 hingegen unter demselben Testframework scheiterte.
Was am Ende dabei herauskommt
Ein kostenloses Tool namens llm-conform 1.0, das pro zu testendem Modell eine Frage beantwortet: Entspricht mein Testframework dem Protokoll dieses Modells? Es führt sechs Überprüfungen über den eigenen Anfragepfad durch – etwa 21 API-Anfragen pro Replay-Modus – wobei die Ergebnisse jeweils gespeichert werden.
$ python3 llm_conform.py --config my-config.toml

MODEL my-model  (https://api.example.com/v1)
  c1   PASS  served; endpoint reports model 'my-model'
  c2   PASS  reasoning arrives via 'reasoning_content'; answer text is clean
  c3   FAIL  your replay mode loses this model's reasoning: 'content-only' recalled 0/3
              but 'reasoning_content' recalled 3/3 - use reasoning_content
  c4   WARN  tool round trip ok (lookup_record -> result -> answer); an unanswered tool call
              is tolerated by the endpoint, but it must still be answered or removed
  c5   PASS  the sampler was accepted
  c6   PASS  a medium task fits in max_tokens=4096 (finish_reason=stop)

  VERDICT FAIL  (1 fail, 1 warn, 4 pass, 0 info)
Der Exit-Code beträgt 0, wenn alle Prüfungen erfolgreich sind; 1 bei einer Warnung und 2 bei einem Fehler – somit lässt sich das Tool problemlos in CI-Pipelines integrieren. Es werden keine zusätzlichen Pakete oder externe Dienste benötigt: Die Beispiele verwenden https://api.example.com/v1, my-model sowie $MY_API_KEY.
Welche vier Mängel hat unser LLM-Benchmark verborgen?
Das Board nach den Korrekturen. Das ± hinter einem Wert gibt die Hälfte des 90%-Bootstrap-Intervalls an. Das Board betrachtet zwei Zeilen als unentschieden, wenn das zugehörige 90%-Intervall ihrer Differenz die Zahl 0 enthält – und nicht, wenn die einzelnen Balken sich überschneiden.

| Modell | Vorher | Nach den Korrekturen | Raum |
|---|---|---|---|
| MiniMax-M3.1-Flash | 13,3 | 13,5 ± 1,6 | 14,3 |
| MiniMax-M3 | 13,4 | 14,4 ± 1,6 | 15,3 |
| MiniMax-M2.5 | 14,2 | 11,7 ± 1,8 | = |
| MiniMax-M2.5-highspeed | 12,8 | 14,0 ± 0,8 | = |
| MiniMax-M2.7-highspeed | 13,8 | 13,5 ± 1,1 | = |
| MiniMax-M2.7 | 12,6 | 12,6 ± 1,8 | = |
| deepseek-flash | 19,2 | 19,2 ± 0,8 | — |
| deepseek-pro | 17,5 | 17,5 ± 0,8 | — |
„Vorher“ bezeichnet den Zustand des Boards am Morgen des 02.11.2026; „danach“ bezeichnet das neu erstellte Board um 20:18 Uhr, welches um 20:55 Uhr nach erneutem Ausführen zweier Zeilen aktualisiert wurde. Room ist der Wert, bei dem die erneut ausgeführten, budgetüberschreitenden Zeilen zu einem höheren Ergebnis führen. Die größte Veränderung gibt es bei MiniMax-M2.5 – dessen Wert sank um 2,5 Punkte: Der zugehörige Func-Subwert fiel von 5,0 auf 3,1; der Code für eine einzelne Ausführung kann diesen Wert jedoch nicht korrigieren.
1. Das Harness verwarf die Schlussfolgerungen
Unser mehrstufiger Runner gab nur den sichtbaren Text der Antwort des Assistenten zurück. Die Dokumentation von MiniMax verlangt jedoch das Gegenteil: die vollständige Antwort, einschließlich reasoning_content, muss im Konversationsverlauf enthalten sein. Der Test fragte nach einer zufälligen sechsstelligen Zahl – nur im Bereich „Begründung“ – und erwartete als Antwort „ok“; im nächsten Schritt wurde nach dieser Zahl gefragt.
| Modell | Begründungen weggelassen | Begründungen erneut angezeigt |
|---|---|---|
| MiniMax-M3 | 1 von 10 | 7 von 10 |
| MiniMax-M3.1-Flash | 0 von 10 | 8 von 10 |
| MiniMax-M2.5 | 2 von 10 | 6 von 10 |
Ohne die Denkprozesse aktiviert, lieferte das Modell in unserem Testfall RD4-kettle-saddle in nur 1 von 12 Durchläufen überhaupt eine Begründung. Nach Aktivierung dieser Funktion gelang es dem Modell in 6 bis 12 von 12 Durchläufen, eine Begründung zu liefern – das „Harness“-Tool unterdrückte zwar die Denkprozesse, doch diese gingen nicht verloren. Die Lösung besteht in einem Schalter pro Anbieter: Standardmäßig ist dieser Schalter für den Anbieter aktiviert, der auf MiniMaxs API verweist; bei allen anderen Anbietern bleibt er deaktiviert. Zudem gibt es ein zusätzliches Anfragefeld, damit die Denkprozesse über denselben Kanal übertragen werden. Der bewertete Gesprächsverlauf bleibt rein textbasiert sichtbar – die Begründungen bilden schließlich nur den Kontext, nicht die eigentliche Antwort.

Ein weiteres Problem trat im Tool-Zyklus auf: Ein „Assistant-Turn“ wurde hinzugefügt, ohne dass ein entsprechender Tool-Aufruf erfolgte; das Ergebnis wurde als zweiter Aufruf zurückgegeben – wodurch eine Prüfung fehlschlug, die eigentlich nur einen Aufruf erwartete. In den gespeicherten Transkripten wurden insgesamt 45 Tool-Aufrufe ausgelassen; bei allen drei Fällen, in denen „N Tool-Aufrufe erwartet wurden, aber nur 1 erfolgte“, wurde der Aufruf erneut ausgeführt.
2. „Keine Tokens mehr vorhanden“ bedeutete leer – nicht teilweise gefüllt
Unser Board verarbeitete insgesamt 16.384 Ausgabe-Token. Der vom Hersteller empfohlene Wert für die beiden großen Modelle beträgt 131.072 – das ist achtmal so viel. Jede abgeschnittene Zeile war leer, nicht nur teilweise beantwortet: Bei allen gespeicherten Transkripten gab es bei MiniMax-M3 in 13 von 13 Fällen solche leeren Zeilen; bei MiniMax-M3.1-Flash waren es 10 von 10 Fällen – also 100 %. Bei den beiden kleineren Modellen, deren Antworten deutlich kürzer sind, gab es hingegen keine solchen Fälle. Der eigentliche Testlauf umfasst nur einen viel kleineren Ausschnitt: Bei MiniMax-M3 gab es 2 solcher leerer Zeilen – beide aus dem Fall WR1-ninth-string; bei MiniMax-M3.1-Flash gab es keine. Dieser eine Fall ist der einzige, der noch zum Score beiträgt: Maximal +0,574 Punkte für M3 (und keine Punkte für M3.1-Flash). Es könnte aber auch null sein – schließlich könnte eine nicht-leere Antwort trotzdem die Prüfungen nicht bestehen.
Wenn man die fehlgeschlagenen Fälle erneut mit dem empfohlenen Budget ausführt, verwandeln sich die Nullwerte in tatsächliche Ergebnisse: Ein Fall, bei dem zuvor finish=length angezeigt wurde – wobei von 16.384 Tokens ganze 16.383 für das Nachdenken verwendet wurden und keine sichtbaren Zeichen entstanden waren –, lieferte nun ein Ergebnis von 131.072 sowie eine vollständige Python-Funktion mit 8.897 Zeichen; ein weiterer Fall ergab eine Funktion mit 4.466 Zeichen. Beide Fälle wurden inzwischen aus der Auswertung entfernt – sie kosteten das System also null Punkte. Deswegen behält das System eine „Room“-Spalte: Ohne diese Spalte würde „gleiches Budget“ bedeuten: „gleiches Budget plus ein stillschweigendes Null-Ergebnis für das Modell, das am längsten nachdenkt“.
3. Die Modellliste war veraltet
Drei IDs im Register des Anbieters wurden als „aufgelistet“ markiert – doch der eigene Modell-Endpunkt des Anbieters zeigte sie weiterhin an. Jeder Aufruf an diesen Endpunkt lieferte den HTTP-Status 404 sowie die Meldung „nicht mehr verfügbar“ und den Fehlercode 2069. Eine Modellliste ist lediglich eine Liste – keine Garantie: Überprüfen Sie das Modell, das Sie testen möchten – mit einem einfachen Aufruf. Betrachten Sie die Angabe „der Endpunkt listet es auf“ nur als Hinweis, niemals als Beweis. Schauen Sie sich an, wie c1 dies handhabt – und auch Alias-Behandlungen erkennt.

Dieselbe Regel gilt auch einen Schritt früher. In den eigenen FAQ des Anbieters heißt es, dass die M2.5- und M2.7-Familien am 18.11.2026 auslaufen. Außerdem werden seit dem 19.10.2026 Anfragen im Rahmen des M-Plans bzw. Token-Plans automatisch an M3.1 Flash weitergeleitet. Wir haben dies am 02.11.2026 überprüft: Die API gibt weiterhin die angeforderten IDs zurück; bei reasoning_split: false liefert die ID für M3.1 Flash den HTTP-Status 400, während die IDs für M2.5 und M2.7 den Status 200 zurückgeben – ohne jegliche Begründung. Von außen kann man nicht erkennen, welcher Modelltyp tatsächlich genutzt wird. Falls sich die FAQ auf dieses Konto bezieht, dann sind vier der sechs MiniMax-Einträge in Wirklichkeit M3.1-Flash-Modelle unter anderen Namen; deren Wertebereich (11,7 bis 14,0) stellt lediglich die natürliche Schwankungsbreite eines Modells dar – keine Rangfolge.
4. Eine bewertete Frage stellte vier Dinge gleichzeitig in den Raum
Ein Bewertungselement ist eine einfache Ja/Nein-Antwort – wobei das „Nein“ die Dimension angibt, die bewertet wird. In einer Testsitzung zum Erwachsenen-Rollenspiel wurde ein Element verwendet, bei dem der Bewerter vier Dinge gleichzeitig bestätigen sollte: Ob die Handlung auf der Seite beschrieben war, wie sie inszeniert wurde, ob die Figur einen Höhepunkt erlebte und ob der Name der anderen Figur genannt wurde. Eine Antwort, die alles außer dem Namen enthielt, ergab ein „Nein“ – wodurch auch der „Hitzefaktor“ negativ bewertet wurde. Der Name wurde zudem separat überprüft; somit wurde derselbe Aspekt doppelt bewertet.
Bei den gespeicherten Zeilen ergibt sich folgendes Bild: Von den insgesamt 17 Zeilen, die jeweils anhand dieses Verbindungselements bewertet wurden, sind 10 durchgefallen. Der „Heat-Faktor“ einer Zeile berechnet sich aus dem Anteil der bestandenen Klarheitsprüfungen sowie einem zusätzlichen Punkt für die Gesamtbewertung durch den Bewerter; ein Fehler verringert diesen Wert um ein Viertel. Zudem sind Einzelsitzungen fehleranfällig: Im ersten Fall mit Erwachsenen erzielen beide MiniMax-Zeilen einen Wert von 0,73 – somit können die „Geschwister“-Zeilen nicht voneinander unterschieden werden. Im zweiten Fall liegt MiniMax-M3 mit 0,89 gegenüber 0,44 vor; in einem weiteren Fall kehrt sich die Reihenfolge um (0,0 für M3 gegenüber 0,91 für M3.1-Flash). Eine einzelne Sitzung pro Fall stellt lediglich eine Stichprobe dar – keine Rangliste.
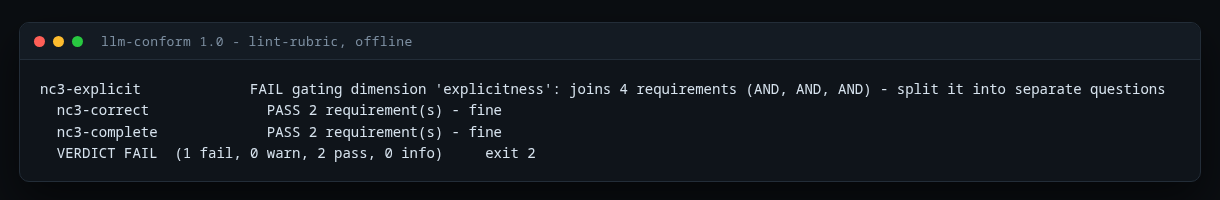
Die Korrektur teilt das Element in eine Frage zur Seite sowie eine Frage zum „Staging“-Prozess auf, bewertet den Namen nur einmal und bewertet anschließend die gespeicherten Transkripte erneut – anstatt sie neu zu generieren. Zudem wurde ein Lint-Prüfmechanismus hinzugefügt: Jedes Gate-Element, dessen Frage mehr als zwei Anforderungen verknüpft, gilt nun als Fehler; der vorherige Text bleibt dabei weiterhin als Referenz erhalten. Das gesamte Testset besteht die Lint-Prüfung: 463 Bewertungselemente über 393 Testfälle. Eine Zeile wurde unter beiden Fragen bewertet – und scheiterte in beiden Fällen; sie hatte diesen Aspekt tatsächlich verpasst. Der „Heat Factor“ lag bei 0,75, der Fall-Score bei 0,62. Die Korrektur beseitigte eine ungerechtfertigte Abwertung; sie rettete jedoch kein Modell, das seine Aufgabe nicht erfüllte.
5. Eine korrekte Behebung bewegt das Brett immer noch nicht
Die Korrektur der Logik ist bewiesenermaßen richtig: Bei drei separaten Durchläufen mit unterschiedlichen Rätseln gelang es demselben Testverfahren jeweils, alle drei möglichen Ergebnisse zu erkennen – also von 0 von 3 erkannten Ergebnissen auf 3 von 3. Zudem bewegte sich das „Board“ weniger als innerhalb seiner Fehlertoleranz: Der Mini-Chain-Test stieg von 0 auf 3; der Wert des Deep RP-Teils der Bewertung erhöhte sich bei den beiden M3-Modellen um 0,2 bis 0,4 Punkte. Insgesamt lag die Abweichung unterhalb der Toleranzgrenze von ±0. MiniMax ignoriert den Parameter seed; daher stellt jede MiniMax-Zeile ein eigenes Beispiel dar. Zwei Codebank-Fälle, bei denen jeweils fünf identische Durchläufe durchgeführt wurden, ergaben Verteilungen der Erfolgsraten von 0,250 bzw. 0,500.
Ein Codierungsfall wurde am 2026-11-01 erfolgreich ausgeführt und am 2026-11-02 unter denselben Bedingungen fehlgeschlagen – zwei „ehrliche“ Ausführungen, aber gegensätzliche Ergebnisse. Bei der Überprüfung stellte sich ein weiterer Fehler heraus: Ein Datenstrom, der nach dem eigentlichen Reasoning endete – ohne Angabe eines Beendigungsgrundes – wurde als vollständige, leere Antwort akzeptiert und mit null Punkten bewertet. Mittlerweile wird dieser Fall als fehlgeschlagene Ausführung betrachtet und erneut versucht. Entscheidend ist also die Reihenfolge der Schritte: Überprüfen Sie zunächst das Protokoll, wiederholen Sie anschließend die Sitzung – erst danach können Sie einem einzelnen Punktergebnis Glauben schenken.
Die Ursachen sowie die Überprüfungen, die sie erkennen
Keiner der vier Fehler war ein Bug im Modell oder im Bewertungscode – außerdem haben sie nicht alle dieselbe Ursache. Die veraltete Modellliste stammt vom Anbieterseite; das „Compound Judge“-Element ist eine Designentscheidung; die Token-Budget-Einstellung hingegen eine Konfigurationswahl. Es gibt also vier Hauptursachen:
- Das Anfrageprotokoll pro Anbieter und Modell wurde angenommen, aber nie gegen das Verhalten des Modells bzw. die Dokumentation des Anbieters überprüft.
- Für kein einziges Modell konnte nachgewiesen werden, dass der vom Testtool gesendete Gesprächsverlauf tatsächlich vom Modell verarbeitet werden kann.
- In den Datensätzen wurde nicht vermerkt, welches Protokoll zu deren Erstellung verwendet wurde; daher konnte man bei einer Korrektur des Testtools nicht erkennen, welche Datensätze veraltet waren.
- Der „Case Lint“-Checker erkannte komplexe Abfragekonstruktionen nicht.
Die Lösung besteht in einer Konformitätsprüfung vor jedem Benchmark – das ist keine Sonderbehandlung im Testtool selbst. Es werden sechs Überprüfungen pro Modell durchgeführt; dabei kommen pro Wiederholungsmodus etwa 21 API-Aufrufe zustande. Diese erfolgen über den eigenen Anfragepfad des Testtools – niemals werden manuell erstellte Anfragen verwendet, denn sonst würde die Überprüfung nichts über das Testtool aussagen. Die erzeugten Protokolle enthalten außerdem ein „Protokoll-Fingerprint“, sodass Änderungen am Testtool erkannt werden können.
Das im Download enthaltene Kit stellt genau diesen Schritt dar – es ist so konzipiert, dass es mit jedem OpenAI-kompatiblen Endpunkt funktioniert: die gleichen sechs Überprüfungen, dieselben Nachweisdateien, der „Rubric Linter“ sowie eine Offline-Testsuite mit 44 Tests gegen einen simulierten lokalen Endpunkt. Es handelt sich dabei um ein Download-Paket – kein Abonnement. Was es allerdings nicht leistet: Es sagt Ihnen nicht, welches Modell besser ist – das müssen Sie selbst herausfinden; dafür sind mehrere Durchläufe sowie eine veröffentlichte Fehlerbreite erforderlich.
Wohin uns das führt
Die M2.5- und M2.7-Familien werden am 18. November 2026 ausgemustert – dabei handelt es sich um vier der insgesamt sechs MiniMax-Board-Reihen. Der Verkehr für diese Reihen soll anschließend auf ein anderes Modell umgeleitet werden; daher ist bis zu diesem Datum noch eine Entscheidung erforderlich. Der Befehl crucibleforge conform existiert bereits und hat den logischen Fehler im System sofort erkannt. Der nächste Schritt besteht darin, dass der Benchmark ein Modell ablehnt, das diesen Test nicht besteht – doch das wurde bisher noch nicht umgesetzt. Zudem fehlen uns weiterhin die notwendigen Wiederholungen, um irgendetwas innerhalb einer ein-Punkt-Bandbreite zu bewerten – und genau diese Bandbreite stellt die „ehrliche“ Antwort dar.
Verwandt: das Benchmark-Tool selbst (276 Testfälle, davon 166 schwierige), wie viel unsere KI-Agenten tatsächlich kosten, MiniMax M3 als Codierungsagent sowie StudioForge.
Downloads
Kostenlos für die private Nutzung. Wenn es dir einen Nachmittag erspart, ist der Kaffee-Button gleich in der Nähe.