私のLLMベンチマークスコアを歪ませた4つのハーネス不具合
- カテゴリ
- AIとローカルLLM
- 公開日
- 2026年11月2日
- 更新日
- 2026年11月2日
- 著者
- Jacob Lloyd — プロジェクト完了後、AIの支援を受けて執筆
- 読了時間
- 約17分で読めます

かんたんに言うと: 私たちのLLMベンチマークによれば、新しいモデルの方が以前のモデルよりも成績が悪いと判定されました。この結果はほぼ正しかったのですが、本当に重要なのはテストハーネス自体に存在した4つの不具合でした。このページではそれぞれの不具合がどれくらいスコアに影響したか、見つけ方、そしてスコアを信頼する前に自分のハーネスをチェックできる無料のPython用ツールキットについて解説します。
2026年11月2日の真夜中に終了した一晩中のテストでは、新しく導入されたホスト型モデルのスコアが以前のバージョンよりも低くなっていました。MiniMax-M3.1-Flashの得点は20点満点中13.3点で、一方MiniMax-M2.5は14.2点を記録しました。ただし、信頼できない値が含まれていたのはテスト用ハーネスのデータ部分です。
要約
- スコア自体はほぼ正確でしたが、興味深い点は別にありました。 精査の結果、2つのハーネス上の不具合により得点がおよそ+0.4から+1.7点上乗せされていたことが判明し、実際のスコアは13.7点から14.9点程度と推定されます。上位モデルとの差は純粋にモデルの性能によるものでした。
- ハーネスの不適切な運用がモデルの能力を低く見せてしまうケースが3つありました。 例えば、推論機能を無効化すると同じテストでも正答率が10問中0問になり、有効化すれば8問正解となります。「トークン切れ」と記載された行は全て空欄でした(保存されている全記録13件、10件とも同様)。またモデルリストはあくまでリストであり保証ではないため、廃止済みの3つのIDも記載されており、それらへのアクセスは全て404エラーとなりました。
- ある評価用質問では一度に4つの事柄が尋ねられていました。 評価基準は単純な「はい/いいえ」のみですから、状況説明はできたものの1項目を逸した回答は完全な不正解と判定され、その影響が全体スコアにも及びました。
- 理論上正しい修正法も実際の測定値にはなり得ません。 誤差範囲が0.8点から1.8点に及ぶ中で、推論機能の改善による全体スコアの変動幅はそれ以下でした。2026年11月1日には正常に通過したプログラミングテストが、同じハーネス環境下の11月2日には失敗するという現象も見られました。
最終的に得られるもの
無料で利用できるzipファイル、llm-conform 1.0です。これを使うとベンチマーク対象の各モデルに対して一つの質問が可能になります。すなわち「私が用意したハーネスはそのモデルのプロトコルに対応しているか?」という問いです。自身のリクエストパスを通じて6回のチェックが行われ、リプレイモードごとに約21回のAPIリクエストが実行されます。各チェック結果の証拠もそれぞれの場所に保存されます。
$ python3 llm_conform.py --config my-config.toml

MODEL my-model  (https://api.example.com/v1)
  c1   PASS  served; endpoint reports model 'my-model'
  c2   PASS  reasoning arrives via 'reasoning_content'; answer text is clean
  c3   FAIL  your replay mode loses this model's reasoning: 'content-only' recalled 0/3
              but 'reasoning_content' recalled 3/3 - use reasoning_content
  c4   WARN  tool round trip ok (lookup_record -> result -> answer); an unanswered tool call
              is tolerated by the endpoint, but it must still be answered or removed
  c5   PASS  the sampler was accepted
  c6   PASS  a medium task fits in max_tokens=4096 (finish_reason=stop)

  VERDICT FAIL  (1 fail, 1 warn, 4 pass, 0 info)
すべてのチェックに合格した場合は終了コード0となり、警告がある際は1、失敗した場合は2となります。そのためCI環境でも問題なく利用できます。パッケージや外部ライブラリも不要で、サンプルコードでは https://api.example.com/v1、my-model および $MY_API_KEY が使用されています。
私たちのLLMベンチマークでは、どのような4つの欠陥が見逃されていたのでしょうか?
修正後のボードの様子です。スコアの後ろに記載されている ± の値は、各ケースにおける90%ブートストラップ区間の半分に相当します。また、2つの行が同点と判定されるのは、それらの差の90%区間に0が含まれる場合であり、個々のバーの重なり具合によって決まるわけではありません。

| モデル名 | 修正前 | 修正後 | 推論に必要なメモリ量 |
|---|---|---|---|
| MiniMax-M3.1-Flash | 13.3 | 13.5 ± 1.6 | 14.3 |
| MiniMax-M3 | 13.4 | 14.4 ± 1.6 | 15.3 |
| MiniMax-M2.5 | 14.2 | 11.7 ± 1.8 | = |
| MiniMax-M2.5-highspeed | 12.8 | 14.0 ± 0.8 | = |
| MiniMax-M2.7-highspeed | 13.8 | 13.5 ± 1.1 | = |
| MiniMax-M2.7 | 12.6 | 12.6 ± 1.8 | = |
| deepseek-flash | 19.2 | 19.2 ± 0.8 | — |
| deepseek-pro | 17.5 | 17.5 ± 0.8 | — |
「変更前」は2026年11月2日の午前時点のボード状態です。「変更後」は2つの行が再実行された後、20時18分にボードが再構築され、20時55分に更新された状態です。「Room」というのは予算超過した行が再実行された際のスコア値となります。最も大きな変動が見られたのはMiniMax-M2.5で、スコアが2.5ポイント減少しました。これに伴い、その「Func」サブスコアも5.0から3.1へと低下しており、この問題は単回実行のコードでは修正できない状態です。
1. ハーネスが推論結果を破棄してしまった
私たちが使用したマルチターンランナーでは、アシスタント側の発言内容のみが返されていました。しかしMiniMaxのドキュメントでは、会話履歴としては完全な応答内容、つまり reasoning_content も含めた情報が必要とされています。このプローブでは「推論部分のみにランダムな6桁の数字を記載し、『ok』と返信すること」が求められ、次のターンではその数字が何だったかを尋ねる内容でした。
| モデル | 推論処理が省略された回数 | 推論処理が再実行された回数 |
|---|---|---|
| MiniMax-M3 | 10回中1回 | 10回中7回 |
| MiniMax-M3.1-Flash | 10回中0回 | 10回中8回 |
| MiniMax-M2.5 | 10回中2回 | 10回中6回 |
推論処理を無効化した状態では、私たちが測定したケースであるRD4-kettle-saddleにおいて、モデルは12回中1回のみで推論内容を出力しました。再実行してみると、12回中6〜12回で推論結果が得られました。つまり、ハーネス機能は思考プロセス自体を抑制したわけではなく、単にその発現を抑えていただけです。対策としては、プロバイダーごとに切り替え可能な設定を用意し、MiniMaxのAPIを利用するプロバイダーではデフォルトで有効に、それ以外のすべてのプロバイダーでは無効にします。さらに、推論内容が同じチャネル経由で送信されるようリクエスト用のフィールドも追加します。なお、評価対象となる対話内容はテキストのみとなります。つまり、推論結果は回答そのものではなく単なる文脈情報に過ぎないのです。

ツールループ部分で別の不具合も発生していました。アシスタント側でツール呼び出し情報が付加されていなかったため、結果として2回目の呼び出しが行われ、「1回のみの呼び出しを期待している」というチェックに失敗してしまったのです。保存されていた記録全体を見ると、45件ものツール呼び出しが省略されており、「N回のツール呼び出しが行われたが、1回だけを期待していた」というエラーが発生したケースでは、実際に1回分の呼び出しが再実行されていました。
2. 「トークンが尽きた」というのは、部分的に残っているのではなく完全に空になった状態を指します
私の使用しているボードでは、16,384個の出力トークンが生成されました。ベンダーが推奨する値は、2つの大型モデル用に131,072個となっており、これは私の結果の8倍にもなります。切り捨てられた行はすべて空欄であり、部分的な回答が残っているわけではありません。保存されている全トランスクリプトを確認したところ、MiniMax-M3では13件すべて、MiniMax-M3.1-Flashでも10件すべてが100%空欄でした。一方、推論内容がはるかに短い2つの小型モデルでは切り捨てが全く見られませんでした。ボード上での実行結果自体もさらに少なく、MiniMax-M3ではWR1-ninth-stringというケースにおいてのみ2件の切り捨て空欄行が確認されましたが、MiniMax-M3.1-Flashでは0件でした。このWR1-ninth-stringケースだけがスコア計算に影響を与える唯一の例です。M3モデルでは最大で+0.574ポイントが加算される可能性がありますが(M3.1-Flashには何も加算されません)、実際には空欄以外の回答でもチェック基準を満たせなければスコアはゼロになる可能性もあります。
推奨される予算で失敗していたケースを再実行したところ、ゼロだった結果が正しい答えへと変わりました。例えば、finish=length という出力値を持ち、16,384個あるトークンのうち16,383個が推論に使われたにもかかわらず表示される文字はゼロだったケースが、今度は131,072という結果となり、8,897文字からなる完全なPython関数が得られました。また別のケースでも4,466文字分のコードが生成されました。これらのケースはその後判定対象から外れたため、予算面でのペナルティも発生していません。つまりこの判定システムでは Room という列が必須なのです。この列がなければ「予算が同等」ということは、「予算が同じで、最も長く推論したモデルには実質的にゼロというペナルティが与えられる」という意味になってしまうからです。
3. モデル一覧が古くなっていた
ベンダーのレジストリ上では3つのIDが「退役済み」と記録されていましたが、実際にはベンダー側のモデルエンドポイントにはそれらが依然として表示されており、どの呼び出しを行ってもHTTP 404エラーが返され、「もはや利用不可」というメッセージと共にコード2069が示されました。モデルリストというのは単なる一覧に過ぎず、何ら保証するものではありません。ベンチマーク対象のモデルについては、安価な呼び出しを一度行って確認するべきです。「エンドポイント上に記載されている」ことは単なるヒントにすぎず、決して確実な証拠とは見なすべきではありません。c1がこのような動作をしているかどうか、またエイリアスも正しく検出しているかどうかをご確認ください。

同じ規則がその一つ前の段階にも適用されます。ベンダー自身の FAQ によると、M2.5およびM2.7ファミリーは2026年11月18日にサービス終了となる予定で、Mプラン/トークンプランでは2026年10月19日以降からそれらのリクエストが自動的にM3.1 Flashへ転送されることになっています。私たちは2026年11月2日にこの点を検証してみました。APIでは依然として要求されたIDが報告されており、reasoning_split: false を用いると M3.1-FlashのIDではHTTP 400エラーが返されますが、M2.5やM2.7のIDでは理由説明なしに200 OKが返されています。外部からはどちらが実際に応答しているか判断できません。したがって、もしこのFAQが当該アカウントにも適用されるならば、MiniMaxの6つのエントリのうち4つは別名で表記されたM3.1-Flashモデルであり、そのスコアの幅(11.7から14.0)も単に同一モデル内での実行ごとのばらつきに過ぎず、ランキングを意味するものではないのです。
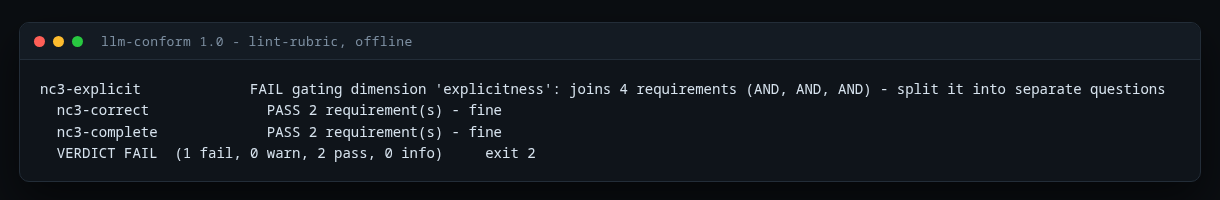
4. ある審査用の質問では、一度に4つの事柄が尋ねられていました
「ジャッジ要素」とは、単純な「はい/いいえ」の判断を指し、その「いいえ」は保護対象となる次元を示します。ある成人向けロールプレイテストセッションにおいて、ある要素がジャッジに対して同時に4つの事項を確認するよう求めました。すなわち、その行為が記述通りかどうか、どのように演出されたか、登場人物がクライマックスに達したかどうか、そしてもう一人の登場人物の名前が口にされたかどうかです。名前以外のすべてを正しく答えた返答でも「いいえ」と判定され、さらに「熱量度合い」の値まで引き下げられてしまいました。なお、名前については別途チェックも行われたため、同じ情報が二重に評価される結果となりました。
記録されている17件の判定結果を見てみると、その化合物に対して10件が不合格となっていました。各判定結果における「ヒートファクター」とは、その判定が明確さの基準を満たした割合に加え、判定者による総合的な評価点も含めた値です。つまり、不合格となるとヒートファクターは4分の1程度まで減少してしまいます。また、単一セッションでの結果はばらつきが大きいものです。最初の成人向けケースでは、MiniMaxの両方の判定結果が0.73となり、兄弟関係を区別できませんでした。次のケースではMiniMax-M3が0.89対0.44でリードしました。さらに別のケースでは順位が逆転しており(M3は0.0、M3.1-Flashは0.91)、単一セッションでの結果はあくまでサンプルに過ぎず、正確なランキングとは言えないのです。
この修正により、該当要素はページに関する質問とステージングに関する質問の2つに分割され、名前の評価も一度だけ実施されるようになりました。また、保存済みのトランスクリプトを再生成する代わりに再度判定が行われる仕組みになっています。さらに「lint」機能も強化され、ある質問が2つ以上の要件と関連付けられている場合はエラーとなるようになりました。修正前のテキストは後方互換性維持用のフィクスチャとしてそのまま保持されています。この変更により、全463件の判定要素が393件のケースに対して「lint」チェックを無事通過しました。ただし、ある1つの行については両方の質問で判定が行われた結果、いずれも失敗となりました。実際にはその部分を見落としていたのです。このケースのヒートファクターは0.75、ケーススコアは0.62でした。今回の修正では不公正な処理を排除しただけであり、本来の機能を果たせていなかったモデルを救うことはありませんでした。
5. 正しい修正をしても基板は動きません
この推論の修正は明らかに正しいと証明できます。同じプローブを使って、異なるパズルを用いて3回ずつ実行したところ、毎回「想起できた数」が0個から3個へと増加しました。また、ボード上の動きもその誤差範囲内に収まっていました。ミニチェーンプローブは0個から3個へと増加し、2つのM3モデルにおいてはスコアの「Deep RP」部分が0.2ポイントから0.4ポイントへ上昇しました。そして「Overall」値の変動幅もその許容誤差範囲未満でした。MiniMaxでは seed パラメータが無視されるため、各MiniMax行は1つのサンプルとして扱われます。コードバンク内の2つのケースについてそれぞれ5回ずつ実行した結果、要素率のばらつきは0.250および0.500という値になりました。
2026年11月1日に実行したコーディングテストは成功しましたが、同日の11月2日にも同じテスト環境およびプロンプトで実行したところ失敗に終わりました。つまり、条件は同一なのに結果が正反対となったのです。調査を進めたところ、別の不具合も見つかりました。推論部分が終了した後でストリームが途切れてしまい、終了理由も記載されていないにもかかわらず、そのストリームは「完了した空の回答」として認識され、得点はゼロとなっていました。現在ではこのようなケースは「中断したストリーム」と見なされ、再実行されることになっています。ですから最も重要な手順というのは、まずプロトコルを確認し、その上でセッションを繰り返してから初めて一点の差異を信じるべきだという点です。
根本的な原因と、それを検知するためのチェック項目
今回確認された4つの不具合はいずれもモデルやスコアリングコードのバグではなく、また全てが同じ原因によるものでもありません。古くなったモデル一覧はベンダー側の問題、複合的な判定基準はケース設計上の問題、トークン数の制限も設定上の選択にすぎません。具体的な根本原因は以下の4点です。
- 各プロバイダーやモデルごとのリクエストプロトコルが前提とされており、実際のモデルの挙動やベンダーのドキュメントと照合して検証されていませんでした。
- 各モデルにおいて、ハーネスが送信する会話内容がそのモデルで利用可能なものであるかを証明する手段がありませんでした。
- 生成されたデータ行に使用されたプロトコルの情報が記録されていなかったため、ハーネスを修正してもどのデータが古くなっているか判別できませんでした。
- ケース・リント機能では複合的な判定条件を持つ質問を検知できませんでした。
対策としては、各ベンチマーク実行前に必ず適合性チェックを行う仕組みを導入しました。これはランナー内の特別な処理ではなく、各モデルごとに6項目のチェックを行う形です。リプレイモードごとに約21回のAPIリクエストが発生しますが、すべてハーネス自身のリクエスト経路を通じて行われます。手作業でリクエストを送信するとハーネスの適合性が検証できなくなるためです。チェック結果にはプロトコルの指紋情報も記録されるので、ハーネス側の変更があった場合でも即座に検知可能となります。
ダウンロードできるキットはこのチェック処理を切り出したもので、どのOpenAI互換エンドポイントでも利用できます。同じ6項目のチェックや証拠ファイル、ルーブリック・リント機能、さらに偽のローカルエンドポイントを用いた44件からなるオフラインテストスイートも含まれています。これはサブスクリプションではなく単なるダウンロードパッケージです。ただし、どのモデルが優れているかを判定することはできません。その判断は利用者自身が行う必要があり、正確な評価には繰り返しテストや公開可能な誤差範囲の算出が求められます。
これからどうなるか
M2.5およびM2.7シリーズは2026年11月18日にサービス終了となります。つまり、MiniMaxの6つの行のうち4つが対象です。これらの行向けのトラフィックを別のモデルへ移行させる予定なので、それに先立って対応方針を決めておく必要があります。crucibleforge conformというコマンドが存在し、論理的な欠陥を即座に検出してくれました。次のステップとしては、このチェックに失敗したモデルをベンチマークから排除することですが、まだ実装されていません。現状では1ポイント幅の範囲内で順位付けを行うための十分な繰り返しテストデータも不足しており、この範囲こそが実際の正解値となるのです。
関連記事:ベンチマークツール自体(テストケース276件、うち難易度が高いもの166件)、私たちのAIエージェントにかかる実際のコスト、プログラミング用エージェントとしてのMiniMax M3、そしてStudioForgeです。
ダウンロード
個人利用は無料です。役に立ったら、コーヒーをおごってもらえると嬉しいです。