4. 那些导致我的大语言模型基准测试分数失真的缺陷
- 发布日期
- 2026年11月2日
- 更新日期
- 2026年11月2日
- 作者
- Jacob Lloyd —— 项目完成后,在 AI 协助下撰写
- 阅读时长
- 约 12 分钟阅读

简单来说: 我们的大语言模型基准测试结果显示,新模型的表现不如旧模型。这一结果大体上是正确的,但实际上并无太大意义:真正的问题在于测试框架本身存在四个漏洞。本页面详细说明了每个漏洞带来的影响、如何识别它们,还提供了一个免费的Python工具包,帮助您在信任测试结果之前对自己的测试框架进行检查。
在2026年11月2日午夜结束的整夜测试中,新上线的模型表现逊于其旧版本:MiniMax-M3.1-Flash仅获得了13.3分(满分20分),而旧版MiniMax-M2.5则得到了14.2分。不过,我们无法完全信赖测试评分结果——因为测试工具本身存在缺陷。
简而言之:
- 评分结果基本可信;真正值得注意的问题在于测试工具本身。经审核发现,测试工具的两个缺陷导致评分被虚增了约0.4至1.7分;实际得分应在13.7到14.9之间。与领先模型之间的差距确实反映了模型质量的差异。
- 三种测试习惯会让模型显得很“笨”。其一就是忽略推理过程:同样的测试任务,不启用推理功能时模型得分为0/10,启用后则能得8/10。“令牌用尽”的情况也从未出现——所有记录中均无此类情况。另外,模型列表只是个参考,并非绝对可靠:有些已停用模型的编号仍被列在其中,调用这些模型时均返回404错误。
- 某个评估问题同时询问了四个内容。而评估标准仅允许回答“是”或“否”;因此即便模型完整描述了场景但漏答了其中一项,也会被视为完全未答对,且整体评分也会随之下降。
- 看似正确的修正方案其实并不能作为衡量标准。误差范围在0.8至1.8分之间;即便修复了推理相关问题,整体评分提升幅度也小于此范围。有个编程测试案例在2026年11月1日能通过,但在2026年11月2日使用同一测试工具时却失败了。
最终会得到什么
一个免费的压缩包,内含 llm-conform 1.0。它能针对你测试的每个模型回答一个问题:我的测试框架是否符合该模型的协议规范? 它会通过你指定的请求路径执行六项检查——每种回放模式下大约需要发送21次API请求——所有检查结果也会被保存下来。
$ python3 llm_conform.py --config my-config.toml

MODEL my-model  (https://api.example.com/v1)
  c1   PASS  served; endpoint reports model 'my-model'
  c2   PASS  reasoning arrives via 'reasoning_content'; answer text is clean
  c3   FAIL  your replay mode loses this model's reasoning: 'content-only' recalled 0/3
              but 'reasoning_content' recalled 3/3 - use reasoning_content
  c4   WARN  tool round trip ok (lookup_record -> result -> answer); an unanswered tool call
              is tolerated by the endpoint, but it must still be answered or removed
  c5   PASS  the sampler was accepted
  c6   PASS  a medium task fits in max_tokens=4096 (finish_reason=stop)

  VERDICT FAIL  (1 fail, 1 warn, 4 pass, 0 info)
当所有检查均通过时返回码为0;出现警告时返回1;出现失败则返回2。因此它可直接集成到CI流程中。无需安装任何第三方包:示例代码中使用的分别是 https://api.example.com/v1、my-model 以及 $MY_API_KEY。
我们的大语言模型基准测试隐藏了哪四个缺陷?
修复后的表格。分数后面的 ± 数值表示基于所有样本计算出的 90% 置信区间的一半。当两组数据差值的 90% 置信区间包含 0 时,表格才会判定这两行数据为平局;而并非以各个条形图是否重叠作为判断依据。

| 型号 | 修复前 | 修复后 | 数值范围 |
|---|---|---|---|
| MiniMax-M3.1-Flash | 13.3 | 13.5 ± 1.6 | 14.3 |
| MiniMax-M3 | 13.4 | 14.4 ± 1.6 | 15.3 |
| MiniMax-M2.5 | 14.2 | 11.7 ± 1.8 | = |
| MiniMax-M2.5-highspeed | 12.8 | 14.0 ± 0.8 | = |
| MiniMax-M2.7-highspeed | 13.8 | 13.5 ± 1.1 | = |
| MiniMax-M2.7 | 12.6 | 12.6 ± 1.8 | = |
| deepseek-flash | 19.2 | 19.2 ± 0.8 | — |
| deepseek-pro | 17.5 | 17.5 ± 0.8 | — |
“之前”的状态是指2026年11月2日上午的棋盘状态;“之后”则是指在20:18重新生成棋盘,随后在20:55因重新运行了两行数据而再次刷新后的状态。Room这一分数则是因为重新运行了那些超出预算限制的行数据而变大了。变化最显著的便是MiniMax-M2.5,它的得分下降了2.5分:其Func子分数从5.0降到了3.1,而这个修正措施无法影响到单轮计算中的代码。
1. 训练框架抛弃了推理过程
我们的多轮对话运行器仅返回了助手回复中可见的文本内容。而 MiniMax 的文档要求则恰恰相反:需要在对话历史中包含完整的回复内容,包括 reasoning_content。该测试请求要求在“推理过程”中随机生成一个六位数,并回复“ok”;下一轮对话则询问具体是哪个数字。
| 模型 | 推理结果丢失的情况 | 推理结果重新生成的情况 |
|---|---|---|
| MiniMax-M3 | 10次中有1次 | 10次中有7次 |
| MiniMax-M3.1-Flash | 10次中0次 | 10次中有8次 |
| MiniMax-M2.5 | 10次中有2次 | 10次中有6次 |
在关闭推理功能后,在我们测试的案例 RD4-kettle-saddle 中,该模型在12次尝试里仅有1次输出了推理过程;重新开启后,在12次尝试中有6次成功输出了推理内容。可见该机制只是抑制了推理过程,并未使其完全消失。解决方案是为每个服务提供商设置一个开关:对于使用 MiniMax API 的服务提供商,该开关默认处于开启状态;其他所有服务提供商则保持关闭状态。此外还需添加一个请求字段,以确保推理信息能通过同一通道传输。需要强调的是,对话内容仅以可见文本形式呈现:推理过程只是上下文信息,并非最终答案。

另一个漏洞出现在工具调用流程中:某个辅助操作被添加进去,但却没有对应的工具调用指令;结果系统将其视为第二次调用,从而触发了“预期只有一次调用”的检查机制并导致失败。在所有存储的对话记录中,共有45次工具调用被遗漏;而在那些显示“应有N次工具调用,实际只出现了1次”的错误中,有3个错误实际上又重新发出了一次调用请求。
2. “令牌用完了”意味着彻底用尽,而非还剩一些
我们的测试板产生的输出标记数量达到了16,384个。而该供应商为这两款大型模型推荐的设定值则是131,072个——相当于前者的八倍。所有被截断的行均为空,并未出现部分回答的情况:在全部存储的转录文本中,MiniMax-M3的所有13行均为空;MiniMax-M3.1-Flash的10行也全为空,占比100%。至于另外两款体积较小的模型,由于它们的推理过程较短,则完全没有出现这种情况。实际上,真正影响评分的只是其中一小部分数据:在WR1-ninth-string这个测试案例中,MiniMax-M3出现了2行截断且内容为空的情况;而MiniMax-M3.1-Flash则没有此类情况。这个案例是决定评分的唯一依据:MiniMax-M3最多可获得+0.574分的加分(而MiniMax-M3.1-Flash则得不到任何加分),不过也有可能得分为零,因为即便有非空回答,仍有可能无法通过相关校验。
在按照推荐的预算重新运行那些原本失败的测试用例后,结果发生了显著变化:其中一个测试用例原本返回了 finish=length,表示该模型在16,384个令牌中仅有16,383个被用于推理过程,且未生成任何可见字符;但在重新运行后,它却输出了131,072个令牌的内容,即一个完整的、包含8,897个字符的Python函数。另一个测试用例则输出了4,466个字符。这两个测试用例后来都不再出现在榜单上,因此并未给系统带来任何扣分。正因如此,榜单上才保留了“Room”这一列——若没有这一列,“相同预算”的含义就会变成“相同的预算加上对推理时间最长的模型所赋予的隐性零分”。
3. 模型列表已过时
在供应商的注册表中,有三个标识符被标记为已废弃。然而该供应商的模型端点仍然列出了它们;每次调用时都返回 HTTP 404 错误,并附带“已不再可用”的提示以及错误代码 2069。模型列表只是个参考信息而已:在进行基准测试前,请先发起一次简单的调用来确认模型状态——把“端点上列有该模型”视为一个提示而非确凿证据。查看 c1 的实现方式吧,它还能处理别名问题。

同样的规则也适用于更早的阶段。该供应商自己的 常见问题解答 指出,M2.5和M2.7系列模型将于2026年11月18日起停用;而在M计划/令牌计划下,自2026年10月19日起,针对这些模型的请求均被自动路由至M3.1 Flash。我们于2026年11月02日对此进行了测试:API仍然返回所请求的模型ID;当使用 reasoning_split: false 参数时,若输入M3.1-Flash的ID则会返回HTTP 400错误,而输入M2.5和M2.7的ID则均返回200状态码且没有任何相关说明。从外部来看,根本无法判断实际提供服务的模型是哪一个。因此,如果该常见问题解答适用于此账户的话,那么六个MiniMax条目中有四个实际上就是以其他名称命名的M3.1-Flash模型;其数值范围(11.7至14.0)也仅仅是同一模型在不同运行实例中的误差范围而已,并非真正的性能排名。
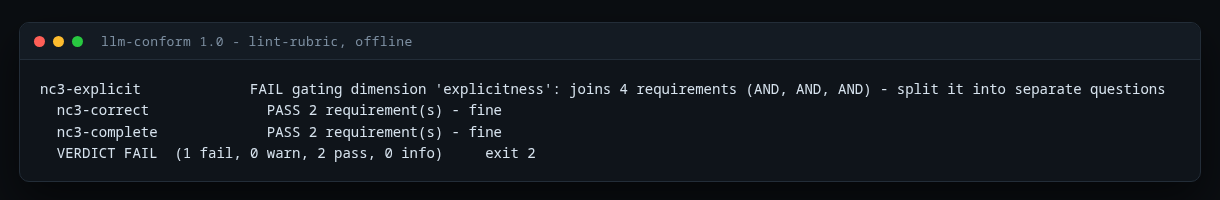
4. 一道需要评判的题目同时询问了四件事
所谓“评判元素”其实就是一个只能回答“是”或“否”的选项,该选项所代表的维度则由其名称来体现。在一次成人角色扮演测试中,有一个评判元素要求测试者同时确认四件事:所述行为是否确实出现在剧本中、表演方式是否正确、角色是否达到了高潮,以及另一个角色的名字是否被提及。如果回答者答对了所有内容但唯独没说出那个名字,则会被判定为“否”,且“紧张程度”这一评分也会随之降低;而那个名字还会被单独检查,因此同一个细节实际上被考核了两次。
根据已存储的数据统计:在总共17个针对该化合物元素的评估样本中,有10个未能通过测试。某个样本的“热度值”由其通过的明确性检查数量决定,每通过一项检查便增加1分;反之,一次未通过则会使其热度值减少四分之一。此外,单次评估的结果往往存在波动:在第一个成人样本测试中,MiniMax的两个版本得分均为0.73,因此无法区分二者;而在第二个样本中,MiniMax-M3的得分为0.89,另一版本则为0.44;在另一个成人样本中,得分顺序又发生了反转(M3得分为0.0,而M3.1-Flash则得0.91)。因此,每个样本仅对应一次评估结果,并不能作为真正的排名依据。
该修复方案将相关元素拆分为两个部分:一个关于页面的问题,另一个关于分级流程的问题。系统仅对名称进行一次评分,随后重新评估已存储的转录文本,而无需重新生成它们。此外,该修复还引入了代码规范检查机制:任何其问题涉及两个以上判定条件的内容现在会被视为错误;原先的文本则作为回归测试用例予以保留。整个测试用例集均通过了此规范检查:在393个测试用例中,共有463个判定元素符合要求。有一个测试用例在两个问题上均未能通过——它确实没达到要求——其热度因子为0.75,得分则为0.62。此次修复消除了不公平的评分情况;不过它并未能挽救那些根本无法完成指定任务的模型。
5. 正确的修复方法仍无法移动棋盘
这个修正逻辑显然是正确的:在三次分别使用不同谜题的测试中,同一个探针的得分都从3题中回忆出0题提升到了3题全对。而且棋盘上的变化幅度也小于其误差范围:迷你链探针的得分从0升至3;在两个M3模型上,Deep RP部分的得分则提升了0.2到0.4分。整体变化幅度也小于其±误差值。MiniMax忽略了seed参数,因此每条MiniMax记录都代表一个样本:两个代码库案例各自进行了五次完全相同的测试,所得的元素率波动范围分别为0.250和0.500。
有一个编码案例在 2026年11月1日运行成功,但在同一测试环境与提示词下于 2026年11月2日运行失败——两次运行结果截然相反。进一步检查后发现另一个问题:某个输出流在推理内容结束后便终止了,且没有任何结束原因;但该输出仍被视作一个完整的空答案并得到了零分。现在该情况已被视为输出流丢失的情况,系统会重新尝试运行。因此,操作顺序才是值得借鉴的关键点:务必先验证协议是否正确,然后再重复执行整个流程,才可信服某个仅得一分的结果。
根本原因以及相应的检测机制
这四个问题均不属于模型或评分代码中的缺陷,它们的成因也各不相同:过时的模型列表属于供应商端的问题;复合判断逻辑则是用例设计上的疏漏;令牌预算则属于配置选项。具体有四个根本原因:
- 针对每个提供商及模型的请求协议仅被假定存在,却从未通过模型的实际行为或供应商文档加以验证。
- 没有任何证据能证明测试工具所发送的对话内容确实能被相应模型处理。
- 数据记录中并未记载生成该数据的协议类型,因此即便修复了测试工具也无法判断哪些数据是过时的。
- 用例检查机制未能发现那些包含复合逻辑判断的问题。
解决方案就是在每次基准测试前执行一组一致性检查,这并非运行器中的特殊处理流程:每个模型需经过六项检查——在每种回放模式下大约需要发送21次API请求。这些请求均通过测试工具自身的请求路径发出,绝不会手动编写请求代码,否则这类检查就无法验证测试工具的可靠性。检查后生成的记录中还包含协议特征信息,便于检测测试工具是否发生了变动。
下载包中提供的正是这一检查流程,它可适配任何与OpenAI兼容的端点:同样包含六项检查、相应的证据文件、用例检查工具,以及针对模拟本地端点的44项离线测试。这是一个一次性下载包,而非订阅服务。不过它无法帮您判定哪个模型更出色——这需要您自行反复测试并计算出误差范围才行。
现状与后续安排
M2.5和M2.7系列产品将于2026年11月18日停止服务——也就是六个MiniMax产品线中的四个。针对这些产品的流量规划将转至其他型号,因此必须在该日期前对这些产品线做出决策。crucibleforge conform命令目前已投入使用,它能实时检测出逻辑上的缺陷;下一步则是让基准测试工具拒绝那些未能通过测试的模型,不过这一步尚未实施。目前我们仍缺乏足够的重复测试数据来对结果进行排序——而那个误差范围其实才是最真实的答案。
相关链接:基准测试工具本身(共276个测试用例,其中166个为难题)、我们的AI代理实际所需的成本、作为编程代理使用的MiniMax M3,以及 StudioForge。
下载
仅限个人使用免费。如果它替你省下了一下午的时间,欢迎点旁边的咖啡按钮支持一下。