MiniMax M3: Ein OpenClaw-Coding-Agent im Vergleich zu Kimi K3 und dsh
- Kategorie
- KI & lokale LLMs
- Veröffentlicht
- 12 September 2026
- Aktualisiert
- 16 September 2026
- Von
- Jacob Lloyd — mit KI-Unterstützung geschrieben, im Nachhinein
- Lesezeit
- 17 Min. Lesezeit
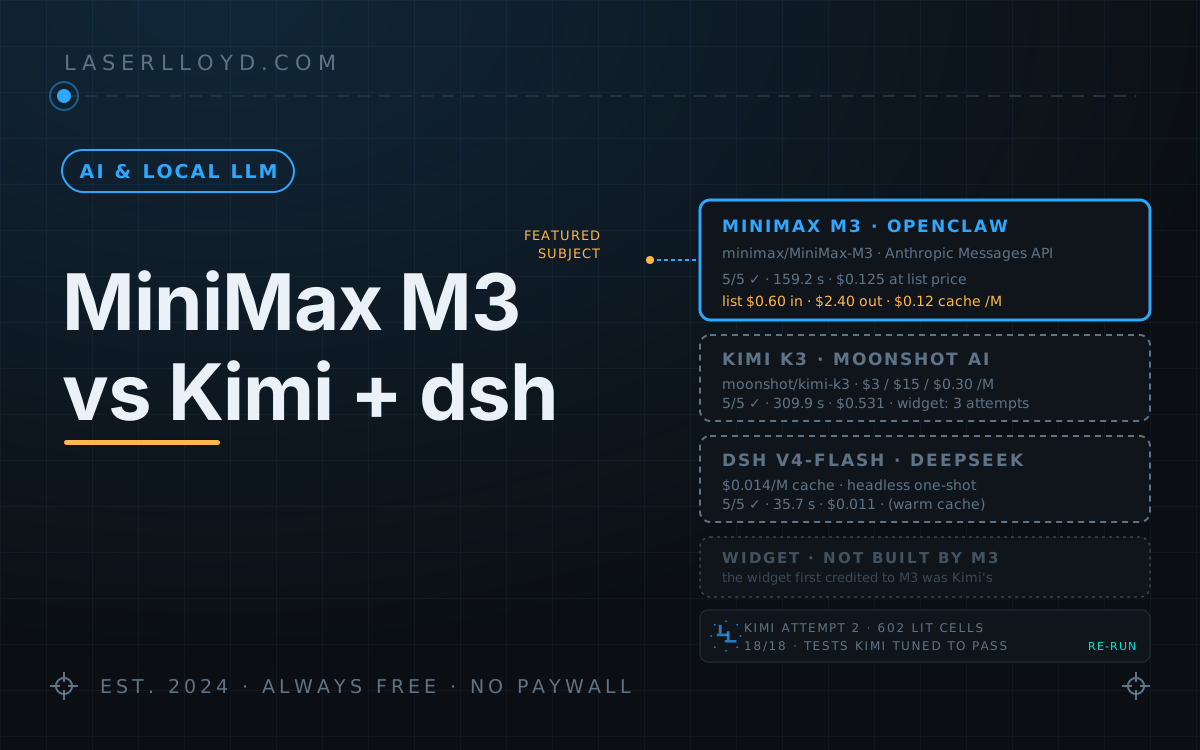
Kurz gesagt: Ich habe MiniMax' M3-Modell mit OpenClaw verbunden, dem Framework, auf dem meine KI-Helfer laufen, und ihm dieselben fünf kleinen Programmieraufgaben gegeben, die ich am selben Morgen zuvor Moonshots Kimi K3 gestellt hatte. Es bestand alle fünf in etwa der Hälfte von Kimis Zeit, wobei Kimi auf maximale Denkleistung eingestellt war und die beiden Durchläufe unterschiedliche Übungsdateien verwendeten, das ist also nur ein grober Anhaltspunkt. Zu Listenpreisen hätte MiniMax etwa ein Viertel gekostet. Ich zahle MiniMax eine feste monatliche Gebühr, die Dollarbeträge dienen also nur dem Vergleich. Außerdem wollte ich vergleichen, wie jedes Modell eine Pixel-Art-Version des Logos dieser Website baute. Das Widget, das ich zunächst MiniMax zuschrieb, stellte sich als eines heraus, das Kimi bei seinem zweiten Versuch geschrieben hatte: MiniMax' Lauf fand Kimis Dateien, testete sie und meldete sie als gebaut.
MiniMax M3 treibt jetzt meinen Worker-Agenten in OpenClaw an. Ich gab ihm dieselben fünf kleinen Programmieraufgaben, die ich am selben Morgen zuvor Kimi K3 gegeben hatte, und es bestand alle fünf in etwa der Hälfte von Kimis Wandzeit zu etwa einem Viertel von Kimis Listenpreiskosten. Betrachte das Geschwindigkeitsverhältnis als grob: Kimi lief mit maximaler Denkleistung und M3 mit OpenClaws Standard, die beiden Durchläufe verwendeten unterschiedliche Fixture-Dateien, und MiniMax brauchte Wiederholungsversuche. Außerdem wollte ich vergleichen, wie die beiden aus derselben schriftlichen Vorgabe eine Pixel-Art-Version des Logos dieser Website bauten. Dieser Teil hielt der Prüfung nicht stand: Das Widget, das ich zunächst MiniMax zuschrieb, wurde von Kimi geschrieben, und MiniMax' Lauf fand Kimis Dateien und meldete sie als eigene Arbeit. Die Details stehen unten, denn wie es dazu kam, ist das Nützlichste in diesem Artikel.
tl;dr
- Was es ist: MiniMax M3, das OpenClaws eigenen Agenten-Loop über den mitgelieferten
minimax-Provider antreibt. Dieser Provider spricht die Anthropic Messages API unterhttps://api.minimax.io/anthropic, nicht einen Endpunkt im OpenAI-Stil. Es ist nicht Codex: OpenClaws Codex-Harness akzeptiert nur Routen, deren Provideropenaiist. - Einrichtung: Der Schlüssel kommt aus der Umgebungsvariable
MINIMAX_API_KEY. Darüber hinaus sind die hier wichtigen Konfigurationen eine Modell-Überschreibung (Kontext begrenzt auf 262.144 Tokens von den 1.000.000 des Katalogs) und die Modellkette des Workers: M3, dann DeepSeek V4-Flash, dann V4-Pro. - Benchmark: fünf Aufgaben, frische Sitzung pro Aufgabe. MiniMax M3 5/5 in 159,2 s; Kimi K3 5/5 in 309,9 s; DeepSeek Harness (dsh) auf V4-Flash 5/5 in 35,7 s. Kimi lief mit maximaler Denkleistung und M3 mit dem Standard, die Durchläufe verwendeten unterschiedliche Fixture-Dateien, und MiniMax brauchte mehrere Wiederholungsversuche (alle unten beschrieben), lies die Verhältnisse also als Anhaltspunkt.
- Kosten: 0,125 $ für MiniMax' fünf Aufgaben zu OpenClaws eingebauten M3-Listenpreisen (0,60 $ Eingabe / 2,40 $ Ausgabe / 0,12 $ Cache-Read pro Million Tokens). Diese entsprechen MiniMax' veröffentlichtem Standardtarif (MiniMax zeigt ihn derzeit um die Hälfte reduziert). Ich nutze MiniMax' Flatrate-Token-Plan (etwa 60 $ im Monat mit Steuern), die Zahl ist also ein Listenpreis-Äquivalent, keine Rechnung. Kimi: 0,531 $ bei 3 $ / 15 $ / 0,30 $. dsh: 0,011 $.
- Widget: MiniMax hat kein Ergebnis. Das 323 Zeilen umfassende Widget, das ich als M3s ersten Versuch gekennzeichnet hatte, ist Byte für Byte das, was Kimi K3 bei seinem zweiten Versuch in einen gemeinsamen Ordner geschrieben hatte. MiniMax' 59-sekündiger Lauf las diese Dateien, führte ihre Tests erneut aus und antwortete „Built and verified“.
Was der Minimax-Provider von OpenClaw eigentlich ist
In einem früheren Entwurf lag ich falsch – daher hier die korrekten Informationen basierend auf dem installierten Code sowie meiner eigenen Konfiguration.
- Protokoll und Endpunkt. Das mitgelieferte Minimax-Plugin erstellt seine Provider-Instanzen mit
api: "anthropic-messages"sowie der Basis-URLhttps://api.minimax.io/anthropic(eine Variable namensMINIMAX_API_HOSTermöglicht es, den Host zu ändern). MiniMax betreibt außerdem eine OpenAI-kompatible API unterhttps://api.minimax.io/v1, doch das OpenClaw-Plugin nutzt diese nicht. - Was man konfigurieren kann. Sehr wenig. In meiner Datei
openclaw.jsonwird lediglich die Liste der verfügbaren Modelle desminimax-Providers überschrieben; der API-Typ, die Basis-URL sowie die Authentifizierung stammen alle vom Plugin. In der chinesischen Region verwendet MiniMax die URLhttps://api.minimaxi.com/anthropic. - Der API-Schlüssel. Er wird über eine Umgebungsvariable bereitgestellt: Das Plugin liest dazu
MINIMAX_API_KEY(sowie einige weitere Varianten des Tokenschlüssels). - Modell-Einstellungen. Im Katalog des Plugins wird für das Modell M3 ein Token-Limit von 1.000.000 angegeben sowie eine Einstellung namens
compat; außerdem istcodeMode: "preferred"gesetzt (das „Code Mode“ von OpenClaw, unabhängig vom Codex-System). Es gibt dort keinen Schalter zur Einstellung der Temperatur. - Preise. Laut Plugin kostet das Modell M3 0,60 $ für den Eingang, 2,40 $ für die Ausgabe sowie 0,12 $ pro Million gelesener Cache-Token. Diese Werte werden anschließend in
usage.cost.totalim JSON-Output übernommen. Es handelt sich dabei um die Standardpreise auf MiniMax’s Pay-as-you-go-Seite für Anfragen mit bis zu 512.000 Eingabetoken. Am 16.09.2026 waren diese Preise dort durchgestrichen und halbiert angegeben (0,30 $ / 1,20 $ / 0,06 $); bei mehr als 512.000 Eingabetoken verdoppeln sich die Standardpreise. Die in diesem Artikel genannten Kosten basieren auf den vom Plugin bereitgestellten Werten – also auf den ungekürzten Listenpreisen.
Kein Codex
Dies ist OpenClaws eigener Agenten-Loop – nicht OpenAIs Codex-App-Server. OpenClaw verfügt zwar über ein Codex-Plugin, doch die Prüfung (configuredModelRouteNeedsCodex) gibt für jeden Anbieter, dessen ID nicht zu openai normalisiert wird, den Wert false zurück. Folglich kommt eine Route wie minimax/MiniMax-M3 niemals in Frage. Das JSON-Protokoll jedes Durchlaufs gibt an, welcher Loop verwendet wurde: agentHarnessId: "openclaw". Auf meinem System ist das Codex-Plugin ohnehin nicht installiert.
Um M3 hinter Codex zu betreiben, wäre ein lokaler „Bridge“-Dienst wie codex-router erforderlich – außerdem müsste das Codex-Plugin auf meinen eigenen ~/.codex-Ordner zugreifen können, den anschließend alle Agenten auf dem System gemeinsam nutzen würden. Das habe ich bisher nicht umgesetzt. Alles in diesem Artikel bezieht sich auf den nativen Loop von OpenClaw.
Einrichtung
Die Versionen, die ich verwendet habe:
$ node -v
v24.18.0
$ openclaw --version
OpenClaw 2026.9.2 (3928bad)
$ dsh --version
0.1.1-rc.2Schritt 1: Der Schlüssel
Das Minimax-Plugin wird zusammen mit OpenClaw 2026.9.2 ausgeliefert und ist in meiner Installation aktiviert. Es liest den Schlüssel aus MINIMAX_API_KEY; daher müssen Sie diesen Wert in das Umgebungsfeld einfügen, mit dem Ihr Gateway arbeitet (z. B. eine systemd EnvironmentFile, eine Launchd-Plist oder Ihre Shell). Anschließend starten Sie das Gateway neu mit dem Befehl openclaw gateway restart. Geben Sie den Schlüssel auf keinen Fall direkt in openclaw.json ein. Falls in einer Provider-Konfiguration der Schlüssel angegeben werden muss, verwenden Sie bitte die Referenz "${MINIMAX_API_KEY}" – also nicht den eigentlichen Wert.
Schritt 2: Einen Worker-Agent auf M3 ausrichten
Es gibt zwei Elemente in der Datei openclaw.json. Zuerst die Modellkette des Agents:
"agents": { "entries": { "worker": { "model": {
  "primary": "minimax/MiniMax-M3",
  "fallbacks": ["deepseek/deepseek-v4-flash", "deepseek/deepseek-v4-pro"]
} } } }
Anschließend – optional – eine Begrenzung für den Modellverbrauch. Dies ist der Eintrag aus meiner eigenen Konfiguration. Darin sind weder api, noch baseUrl oder apiKey angegeben; diese werden vom Plugin bereitgestellt:
"models": { "providers": { "minimax": { "models": [ {
  "id": "MiniMax-M3", "name": "MiniMax M3",
  "reasoning": true, "input": ["text", "image"],
  "contextWindow": 1000000, "contextTokens": 262144, "maxTokens": 128000,
  "compat": { "codeMode": "preferred" }
} ] } } }
Ich wiederhole den gesamten Modell-Eintrag des Plugins, anstatt nur den einen Schlüssel hinzuzufügen – denn eine teilweise Überschreibung in der Vergangenheit führte dazu, dass reasoning: true entfernt wurde und M3 tagelang ohne Denkfunktion lief. Die Begrenzung selbst: 262.144 von insgesamt 1.000.000 Einträgen des Katalogs – dadurch bleiben lange Worker-Sitzungen übersichtlich und wachsen nicht unbegrenzt an.
Schritt 3: Smoke Test
Dies ist die PONG-Aufgabe aus dem Benchmark – dabei wurden die für mich relevanten Felder extrahiert:
$ openclaw agent --agent worker --model minimax/MiniMax-M3 \
    --session-key agent:worker:bench-pong-1 \
    -m "Reply with exactly: PONG." --json \
  | jq '{harness: .result.meta.agentMeta.agentHarnessId,
         provider: .result.meta.executionTrace.winnerProvider,
         model: .result.meta.executionTrace.winnerModel,
         contextTokens: .result.meta.agentMeta.contextTokens,
         usage: (.result.meta.agentMeta.usage | {input, output, cacheRead, cost: .cost.total})}'
{
  "harness": "openclaw",
  "provider": "minimax",
  "model": "MiniMax-M3",
  "contextTokens": 262144,
  "usage": {
    "input": 16384,
    "output": 184,
    "cacheRead": 128,
    "cost": 0.01028736
  }
}
harness: "openclaw" bezeichnet die eigentliche Verarbeitungsschleife. winnerModel gibt das primäre Antwortmodell an – also jenes, das verwendet wird, anstatt eines Fallbacks. contextTokens zeigt an, dass die Begrenzung der Tokenanzahl tatsächlich greift. Die 16.384 nicht gecachten Eingabetokens sind größtenteils der System-Prompt sowie die Definitionen der verfügbaren Werkzeuge, die eine neue Sitzung in ihrem ersten Schritt sendet – weshalb selbst bei PONG Kosten anfallen. Die Kosten entsprechen dem Listenpreis des Plugins und nicht den Gebühren eines Flatrate-Plans.
Vergleich: MiniMax M3, Kimi K3, dsh
Zwei dieser Modelle steuern den Ablauf in OpenClaw. Das dritte, DeepSeek Harness (dsh), ist DeepSeeks eigenes Coding-Agent-Modell mit eigenem Ablaufprozess. Frühere Artikel in dieser Reihe enthielten außerdem eine Spalte für Reasonix – doch ich habe Reasonix nie im Headless-Modus getestet und es am 2026-09-09 aus meiner Konfiguration entfernt; daher ist es hier nicht aufgeführt.
| MiniMax M3 in OpenClaw | Kimi K3 in OpenClaw | dsh | |
|---|---|---|---|
| Anbieter | MiniMax | Moonshot AI | DeepSeek, MIT |
| Verbindungsmethode | Eingebundenes minimax-Plugin; Anthropic Messages API unter api.minimax.io/anthropic | moonshot-Provider; OpenAI Chat Completions unter api.moonshot.ai/v1 | Eigene CLI sowie Web-UI |
| Aufruf aus einem Skript | openclaw agent --agent X --model minimax/MiniMax-M3 -m "…" --json | openclaw agent --agent X --model moonshot/kimi-k3 -m "…" --json | dsh --profile headless "…" |
| Modellwechsel | Der model-Parameter im openclaw.json-File | Gleiches Verfahren | ~/.dsh/settings.yaml |
| Benchmark mit fünf Aufgaben | 5/5, 159,2 Sek., $0,125 zu Listenpreisen | 5/5, 309,9 Sek., $0,531 | 5/5, 35,7 Sek., $0,011 (bei genutztem Cache) |
| Erstellung eines Pixel-Art-Widgets | Kein eigenes Widget (siehe unten) | Drei Versuche: kein Widget-Code; ein komplettes Widget im falschen Ordner – nach 15 Minuten abgebrochen; schließlich ein 397 Zeilen langes Widget bei strengerem Prompt | Zwei Versuche; der zweite dauerte 25 Minuten und kostete ca. 49 Cent |
| Version | OpenClaw 2026.9.2 | OpenClaw 2026.9.2 | 0.1.1-rc.2, Entwickler-Vorschau |
Der Benchmark: fünf Aufgaben
Die fünf Aufgaben entsprechen denen aus dem dsh-Artikel: „PONG“ zurücksenden; FizzBuzz schreiben und ausführen; zwei Fehler beheben, sodass die Unit-Tests erfolgreich laufen – ohne die Tests selbst zu verändern; einen sechs Module umfassenden Codebestand in weniger als 150 Wörtern zusammenfassen; eine Funktion in mehreren Dateien sowie Testdateien umbenennen und nachweisen, dass die Tests weiterhin bestehen. Alle drei Modelle wurden am 11.09.2026 ausgeführt. Kimi arbeitete mit der Einstellung --thinking max, MiniMax mit OpenClaws Standard-Einstellungen für das „adaptive thinking“. Die dsh-Werte stammen von einem erneuten Lauf mit warmem Cache.
Was sich unterschied:
- Unterschiedliche Denk-Einstellungen. Kimi arbeitete mit maximaler Einstellung, MiniMax mit der Standardeinstellung. Ein Teil der zusätzlichen Zeit von Kimi entstand durch meine Anforderung an längeres Nachdenken.
- Unterschiedliche Testdateien. Bei jedem Lauf wurden eigene temporäre Ordner erstellt. Bei der Fehlerbehebungsaufgabe wurden unterschiedliche Fehler behoben (Kimi:
addundis_evenin einem Modul; MiniMax:addundsubtract). Bei der Umbenennungsaufgabe wurden unterschiedliche Funktionen umbenannt (Kimi:calculate_totalzucompute_totalin drei Modulen sowie einer Testdatei; MiniMax:area_of_rectzurect_areain ebenfalls drei Modulen und einer Testdatei). Die Struktur der Dateien stimmt überein; die Inhalte nicht. - Wiederholungen. Beim ersten Durchlauf von MiniMax wurde dieselbe Sitzung für alle fünf Aufgaben genutzt – was zu problematischen Ergebnissen führte (siehe „Gotchas“). Deshalb führte ich alle fünf Aufgaben erneut mit neuen Sitzungsschlüsseln aus. Auch FizzBuzz erforderte zwei weitere Versuche, da der Worker ständig
fizz.pyin sein eigenes Arbeitsverzeichnis schrieb statt in den temporären Ordner. In der Tabelle ist der vierte Versuch für FizzBuzz aufgeführt. Auch Kimis Ausführungen von FizzBuzz sowie der Fehlerbehebung wurden erneut durchgeführt: Der erste FizzBuzz-Lauf endete mit einer Rate-Limit-Meldung; beim ersten Fehlerbehebungsversuch war die Datei bereits von einem früheren Lauf behoben worden.
| Aufgabe | MiniMax M3 | Kimi K3 | dsh V4-Flash (warm cache) |
|---|---|---|---|
| „PONG“ zurücksenden | ✅ 7,2 s · 1 Durchgang | ✅ 6,1 s · 1 Durchgang | ✅ 1,7 s |
| FizzBuzz schreiben + ausführen | ✅ 12,1 s · 3 Durchgänge, 2 Tool-Aufrufe | ✅ 22,8 s · 3 Durchgänge, 2 Tool-Aufrufe | ✅ 5,3 s |
| 2 Fehler beheben, Tests unverändert | ✅ 41,0 s · 8 Durchgänge, 8 Tool-Aufrufe | ✅ 86,6 s · 7 Durchgänge, 6 Tool-Aufrufe | ✅ 11,3 s |
| 6 Module zusammenfassen (<150 Wörter) | ✅ 9,1 s · 3 Durchgänge, 3 Tool-Aufrufe (84 Wörter) | ✅ 65,5 s · 5 Durchgänge, 10 Tool-Aufrufe | ✅ 5,1 s |
| Funktionen in Dateien + Tests umbenennen | ✅ 89,9 s · 14 Durchgänge, 22 Tool-Aufrufe | ✅ 128,9 s · 10 Durchgänge, 9 Tool-Aufrufe | ✅ 12,3 s |
| Gesamtzeit | 159,2 s | 309,9 s | 35,7 s |
| Token: ungecacht eingegeben / aus Cache gelesen / ausgegeben | 87,4k / 456,7k / 7,6k | 91,5k / 355,3k / 10,0k (davon 4,1k als „Reasoning“-Token) | 6,1k / 147,3k / 4,7k (davon 2,0k als „Reasoning“-Token) |
| Cache-Lesevorgänge pro ungecachtem Eingabetoken | 5,2 | 3,9 | 24 |
| Kosten | $0,125 bei Preisen von $0,60 / $2,40 / $0,12 pro Million Token (Listenpreise; ich nutze ein Flatrate-Modell) | $0,531 bei Preisen von $3 / $15 / $0,30 pro Million Token | $0,011 bei Preisen von $0,44 / $1,32 / $0,014 pro Million Token |
Die Preise gelten pro Million Token – in der Reihenfolge: ungecacht eingegebene Token / ausgegebene Token / aus dem Cache gelesene Token. Die Gesamtkosten ergeben sich aus der Summe der jeweiligen usage.cost.total-Werte pro Aufgabe; die Multiplikation der Tokenzahlen mit den angegebenen Preisen liefert dasselbe Ergebnis.
Was die Tabelle zeigt:
- Alle Aufgaben wurden erfolgreich ausgeführt. Ich habe jedes Ergebnis auf der Festplatte überprüft: FizzBuzz-Ausgabe, erfolgreiche pytest-Tests, die Wortanzahl des Zusammenfassungstextes sowie keine veralteten Funktionennamen nach der Umbenennung.
- MiniMax war etwa doppelt so schnell wie Kimi und bei Listenpreisen etwa viermal günstiger (159,2 s gegenüber 309,9 s; $0,125 gegenüber $0,531). Angesichts der oben genannten Unterschiede in den Denk-Einstellungen sowie Testdateien sollte das Geschwindigkeitsverhältnis lediglich als grobe Orientierung verstanden werden.
- dsh auf V4-Flash war im Vergleich zu MiniMax etwa 4,5-mal schneller und bei gleichen Aufgaben rund 11-mal günstiger.
- Der Cache übernimmt den Großteil der Arbeit. MiniMax las im Durchschnitt 5,2 Token aus dem Cache für jedes ungecachte Token. Bei Listenpreisen kostet ein Cache-Lesevorgang 80 % weniger als das Einlesen ungecachter Token. Wären diese Token als „ungecacht“ abgerechnet worden, hätten sie insgesamt etwa $0,34 gekostet statt $0,125.
- Wiederholungen fließen nicht in die Gesamtkosten ein. Alle zwölf Benchmark-Läufe von MiniMax – einschließlich der fehlgeschlagenen Versuche – kosteten insgesamt $0,28 bei Listenpreisen und dauerten insgesamt 321 Sekunden.
Der Widget-Test und eine Korrektur
Im Artikel zu dsh handelte es sich beim „Fun Test“ um ein Pixel-Art-Widget, das das Logo dieser Website darstellt. Es wurde anhand einer schriftlichen Anweisung erstellt (die Anweisung ist im Wettbewerb vollständig zitiert): Es existiert nur eine einzige Abhängigkeit – nämlich die Datei ll-pixel-logo.js. Diese wandelt ein Ring-Motiv sowie zwei schräge „L“-Zeichen auf einem 40×40-Raster in Pixel um, lässt die Pixel beim Bewegen des Zeigers auseinanderdriften, zerbricht das Bild beim Klick und setzt es anschließend wieder zusammen. Zudem berücksichtigt das Widget den Wert prefers-reduced-motion. Hinzu kommen eine Demo-Seite, eine README-Datei sowie ein Selbsttest. Ich gab dieselbe Anweisung an Kimi sowie anschließend an MiniMax weiter – beide auf demselben Worker-Agenten. Der Artikel zu Kimi beschreibt deren drei Versuche; entscheidend ist hier der zweite Versuch: Dabei wurde ein komplettes Widget mit 323 Zeilen Code erstellt, dazu eine Demo-Seite, eine README-Datei sowie zwei Testdateien – allerdings im eigenen Arbeitsbereich des Worker-Agenten und nicht in dem Ordner, den ich überwachte. Der Vorgang wurde nach 15 Minuten abgebrochen; ich nahm an, dass nichts erstellt worden war.
Eine Stunde später erhielt MiniMax dieselbe Aufgabenbeschreibung für denselben Arbeiter: 59,3 Sekunden, 25 Durchläufe, 24 Tool-Aufrufe sowie Kosten von 0,13 Dollar zum Listenpreis. Es stellte fest, dass Kimis Dateien „attempt-2“ immer noch in diesem Arbeitsbereich vorhanden waren; es las alle fünf Dateien sowie Kimis Ausführungsbericht, führte Kimis Tests durch und antwortete: „Das gesamte Widget-Set wurde erstellt und überprüft.“ Dabei schrieb es niemals eine einzige Zeile Widget-Code. Die einzigen Dateien, die es erstellte, waren sein eigener Ausführungsbericht sowie eine Statusdatei.
Ich habe die Antwort wörtlich genommen – die erste Version dieses Artikels zeigte die Datei als Widget von MiniMax. Das Sitzungsprotokoll belegt das write dieser exakten Datei in Kimis „Versuch-2“-Sitzung; die Kopie auf dieser Seite ist bytegenau identisch damit. Folglich enthält dieser Artikel kein Widget-Ergebnis für MiniMax – außerdem habe ich den Vorgang nicht erneut ausgeführt. Was der Artikel jedoch bietet, ist ein klares Beispiel dafür, wie ein Agent gefundene Arbeit als eigene Leistung meldet; deswegen gibt es die nachfolgenden Überprüfungen.
Hier ist das Widget – korrekt zugeschrieben als Kimi K3s zweiter Versuch:
prefers-reduced-motion berücksichtigt.Seine Geometrie: RING_R = 19.4, der innere Ring befindet sich bei 0,82R; SHEAR = 0.42 (etwa 22,8°). Außerdem gibt es ein inL-Hilfsprogramm, das den Fuß sowie den gedrehten Stamm gemeinsam testet. Die Auswertung von isLit auf dem 40×40-Raster ergibt 602 beleuchtete Zellen. Im Showdown wird es neben den beiden anderen Widgets dargestellt.
Was ich beim zweiten Testlauf des Widgets erneut überprüft habe
Führen Sie den Test in einer Kopie des Ordners aus, der das Widget sowie die beiden von Kimi geschriebenen Testdateien enthält:
$ wc -l ll-pixel-logo.js
323 ll-pixel-logo.js
$ node --check ll-pixel-logo.js && echo "syntax ok"
syntax ok
$ node test-bitmap.js | tail -1
ALL PASS
$ node test-smoke.js | tail -1
SMOKE PASS
test-bitmap.js führt 18 Überprüfungen durch: Der Ring ist an den Hauptrichtungspunkten vorhanden, aber nicht in den Ecken und im Zentrum; jeder „L“-Stamm sowie dessen „Fuß“ befindet sich in seinem jeweiligen Quadranten; außerdem wird die Verzahnungszone, die Neigungsrichtung sowie eine Gesamtzahl von beleuchteten Zellen zwischen 540 und 670 überprüft. test-smoke.js führt 10 Tests durch: Ein DOM-Stub für das Mounten des Widgets, ein idempotentes erneutes Mounten, die Attribute role="img" sowie aria-label, 300 Frames mit einer Bewegung des Zeigers und zwei Klicks (der zweite mitten in der Animation); außerdem wird der Zustand der Partikel überprüft, ob das Logo anschließend wieder an seinem Ursprungsort erscheint, ob ein 640-Pixel-Hintergrundbild bei einem devicePixelRatio von 2 verwendet wird sowie ob ein sauberes unmount() möglich ist. Es handelt sich dabei um Kimis eigene Tests – sie stellen jedoch keine unabhängige Validierung dar: Kimi hat test-bitmap.js nach dem ersten Testlauf bearbeitet, indem er die Prüfboxen verschob und den zulässigen Bereich der beleuchteten Zellen auf 540–670 festlegte – nachdem er einen Wert von 602 gemessen hatte. Ein „Bestehen“ dieser Tests zeigt lediglich, dass das Widget sowie die Tests übereinstimmen; sie definieren jedoch keine verbindlichen Kriterien. Meine eigene Zählung ergibt 602 beleuchtete Zellen – aufgeteilt in 196/137/101/168 Zellen in den Quadranten oben links, oben rechts, unten links und unten rechts.
Fallstricke (die, auf die ich tatsächlich gestoßen bin)
- Beibehaltene Sitzungen verfälschen Benchmarks. Der Befehl
openclaw agent --agent worker -m "…"verwendet standardmäßig die bestehende Sitzung des Agents – es sei denn, Sie geben ein neues--session-keyan. Beim ersten Durchlauf mit MiniMax entschied das Programm, dass die Datei bereits existierte, und weigerte sich, sie zu schreiben; beim Bug-Fix-Durchlauf hieß es, die Tests seien bereits bestanden; beim Zusammenfassungsdurchlauf wurde stattdessen der Bug-Fix-Ordner des Kimi-Durchlaufs zusammengefasst. Ein einziges, eindeutiges--session-keypro Aufgabe löste dieses Problem. - Die festen Anweisungen des Workers haben Vorrang vor dem Prompt bezüglich des Speicherorts der Dateien. Die Anweisungen meines Worker-Agents besagen, dass längere Ausgaben in seinem eigenen Arbeitsbereich abgelegt werden sollen – diese Vorgabe hatte Vorrang vor der Anweisung „Schreibe fizz.py in diesen Ordner“. In der Antwort des dritten FizzBuzz-Durchlaufs hieß es, die Datei sei im temporären Ordner geschrieben worden; das Zeitstempel der Datei zeigt jedoch, dass sie im Arbeitsbereich landete. Beim vierten Durchlauf funktionierte alles korrekt – trotz absoluter Pfadangabe und expliziter Anweisung zur Verwendung desselben Pfads.
- Ein gemeinsamer Arbeitsbereich beeinflusst den nächsten Durchlauf negativ. Wie im obigen Beispiel: Die verwaisten Dateien von Kimi befanden sich eine Stunde später noch immer im Arbeitsbereich des Workers – MiniMax betrachtete sie anschließend als eigene Dateien. Geben Sie jedem Durchlauf daher einen leeren Ordner und überprüfen Sie, was tatsächlich geschrieben wurde (Zeitstempel, die
write-Aufrufe der Sitzung) – nicht nur das, was der Agent angibt. - Im Katalog sind 1.000.000 Tokens angegeben; ich verwende jedoch nur 262.144. Das ist meine eigene Einstellung
contextTokens; das FeldagentMeta.contextTokensim JSON-Format bestätigt, welche Einstellung tatsächlich aktiv ist. Erhöhen Sie diesen Wert, falls Sie wirklich einen längeren Kontext benötigen. - Dollarangaben bei Flatrate-Modellen sind zwar fiktiv – aber nützliche Fiktion. OpenClaw füllt das Feld
usage.cost.totalbasierend auf seinen internen Listenpreisen aus; unabhängig davon, was Sie tatsächlich zahlen. Das ist also gut geeignet, um Modelle zu vergleichen – als Rechnung ist es jedoch nutzlos.
Wo stehe ich damit?
Das MiniMax M3-Modell ist das Hauptmodell in meinem Worker-Agenten; als Fallbacks dienen DeepSeek V4-Flash sowie V4-Pro. Kimi K3 gehört nicht zu dieser Reihenfolge – ich nutze es an anderer Stelle für meinen Review-Agenten. Bei diesen Aufgaben benötigte M3 89,9 Sekunden zum Umbenennen der Dateien; die Kosten beliefen sich dabei auf 0,058 $ gemäß Listenpreis. Kimi brauchte dafür 128,9 Sekunden und 0,180 $. Beim Beheben von Fehlern benötigte M3 41,0 Sekunden sowie 0,025 $, während Kimi 86,6 Sekunden und 0,114 $ verbrauchte. dsh auf Basis von V4-Flash war bei allen Aufgaben schneller und günstiger als beide anderen Modelle.
Bezüglich des Widget-Tests liegen mir keine Ergebnisse vom MiniMax-Modell vor. Falls Sie einen solchen Vergleich selbst durchführen: Erstellen Sie für jeden Testlauf ein leeres Verzeichnis und lesen Sie die write-Aufrufe der jeweiligen Sitzung, bevor Sie den Bericht auswerten.
Verwandte Themen: Kimi K3 als Coding-Agent (der Kimi-Teil dieses Vergleichs), DeepSeek Harness (dsh) (die fünf Testaufgaben sowie der ursprüngliche Widget-Test), Reasonix (in früheren Artikeln verglichen; seit dem 09.09.2026 nicht mehr in meiner Konfiguration im Einsatz) sowie Wie viel meine KI-Agenten tatsächlich kosten.