Betrieben von CrucibleForge
Dokumentation
Wie der Benchmark funktioniert, wie man dieselben Tests auch mit eigenen Modellen durchführen kann sowie welche Änderungen das Testpaket im Laufe der Zeit erlebt hat.
Wie sich die Skala entwickelt
Jedes Modell absolviert denselben Standardtest. Bei einer perfekten Ausführung erhält es in jeder Kategorie 10 Punkte. Ein Modell, das in einem Bereich mindestens 90 % erreicht, erhält ein schwierigeres Bonuspaket – dadurch ergeben sich zusätzliche Punkte. Jede neue Version des Benchmarks hat eine festgelegte Höchstpunktzahl; ein neues Bonuspaket erhöht diese Grenze. Sobald die besten Modelle ein Bonuspaket meistern, fügen wir ein noch schwierigeres hinzu. So bleibt für alle Modelle – von kleinen lokalen Modellen bis hin zu hochentwickelten APIs – derselbe Testbestand erhalten; niemand erreicht dabei eine „Obergrenze“.
Ausführungskosten
Bei gehosteten Modellen gibt es sogenannte „Ausführungskosten“ (standardmäßig nicht angezeigt; können über die Spaltenauswahl aktiviert werden). Dabei handelt es sich um die Kosten für eine Ausführung der Standardtests „Code“ und „Chat“ gemäß den vom Anbieter veröffentlichten Preisen – berechnet auf Basis der gesendeten sowie zurückgesendeten Token. Nicht berücksichtigt werden dabei Bonuspakete, erneute Durchläufe, der Bewertungsalgorithmus (der auf unserer eigenen Hardware läuft) sowie eventuelle Rabatte für Nutzung außerhalb der Hauptverkehrszeiten. Ein „~“ bedeutet, dass der Anbieter keine Abrechnung pro Token vornimmt; daher berechnen wir die Kosten auf Basis des Listenpreises. Ein „*“ zeigt an, dass bei einigen Anfragen keine Nutzungsdaten vorlagen. Ein Bindestrich bedeutet, dass das Modell auf unserer eigenen Hardware ausgeführt wurde.
„Built on“-Angabe sowie ältere Versionen
Jedes Modell verfügt über eine „Built on“-Angabe: Bei gehosteten Modellen handelt es sich dabei um die Produktlinie – beispielsweise Claude Opus; bei lokalen Modellen um die Basisgewichte, auf denen sie trainiert wurden – etwa Gemma 4 31B. Ein feinabgestimmtes Modell erscheint daher direkt neben dem Modell, von dem es abstammt. Das Filterfeld berücksichtigt sowohl diese Angabe als auch den Modellnamen.
„Nur neueste Versionen“ sorgt dafür, dass ältere Releases eines Anbieters ausgeblendet werden, sobald ein neueres Release desselben Produkts vorhanden ist und eine Rangplatzierung erhalten hat. Standardmäßig ist dieses Feld aktiviert; dadurch bleiben ältere Versionen zunächst verborgen. Deaktivieren Sie es, um sie anzuzeigen – die Auswahl wird gespeichert, und Links zu ausgeblendeten Zeilen funktionieren weiterhin. Im angezeigten Zustand trägt die Zeile für ältere Versionen den Hinweis „ältere Version“. Feinabgestimmte Modelle behalten den Namen ihres Basismodells in der „Built on“-Spalte bei und werden durch dieses Filterfeld niemals ausgeblendet.
MAX
Ein Modell kann in einem bestimmten Testbereich die Höchstpunktzahl erreichen; in solchen Fällen wird das Label „MAX“ vergeben. Darüber hinaus können die Tests keine Unterschiede zwischen den Modellen mehr feststellen – daher ist für diesen Bereich ein noch schwierigeres Testpaket erforderlich; dessen Name findet sich in den Details der jeweiligen Zeile.
Blockierte Antworten
Der Inhaltsfilter des Anbieters kann Antworten blockieren. In der Modellzeile wird angegeben, wie viele Antworten blockiert wurden; zusätzliche Informationen finden sich in den Details. Jede blockierte Antwort erhält 0 Punkte – genauso wie eine fehlerhafte Antwort. CrucibleForge erkennt solche Fälle bei jedem Aktualisierungsvorgang in den Transkripten; zukünftige Ausführungen werden dadurch automatisch markiert, ohne dass manuelles Eingreifen nötig ist.
Warum MakoBench?
Der Kurzflossen-Makohai gilt gemeinhin als der schnellste Hai im Ozean: Laut Wikipedia erreicht er Spitzengeschwindigkeiten von bis zu etwa 74 km/h; allerdings variieren die Schätzungen, und solche Werte sind schwer zu messen. Wir haben das Testpaket so konzipiert, dass es schnell ausgeführt werden kann – dabei kommt der Open-Source-Engine CrucibleForge zum Einsatz.

So funktioniert MakoBench: Erklärung des Open-Source-LLM-Benchmarks
Wie MakoBench die Antworten eines Modells Schritt für Schritt in eine Bewertung umwandelt – mit einem Diagramm zu jedem Schritt: Wie Fälle bewertet werden, wie der Bewerter arbeitet, Code plus Chat, der „Margin“ sowie wie Bonussätze freigeschaltet werden. Die Beispiele verwenden echte Modelle aus dem Board.

CrucibleForge mit eigenen Modellen ausführen: Installationsanleitung
Installieren Sie CrucibleForge – die open-source-Engine hinter MakoBench. Weisen Sie sie auf ein beliebiges OpenAI-kompatibles Modell hin, um Code- und Chat-Bewertungen zu erhalten; bei einer perfekten Ausführung sind jeweils 10 Punkte möglich. Es handelt sich dabei um echte Befehle sowie tatsächliche Ausgaben – außerdem gibt es einen 1,6-minütigen Testlauf, der lediglich 2 Cent kostet.
Geschichte der MakoBench Suite: Frühere Versionen
Die Tests des MakoBench ändern sich von Zeit zu Zeit – ein Ergebnis hat also nur innerhalb der jeweiligen Testreihe eine Bedeutung. Hier finden sich die früheren Boards – und deswegen haben wir sie behalten.
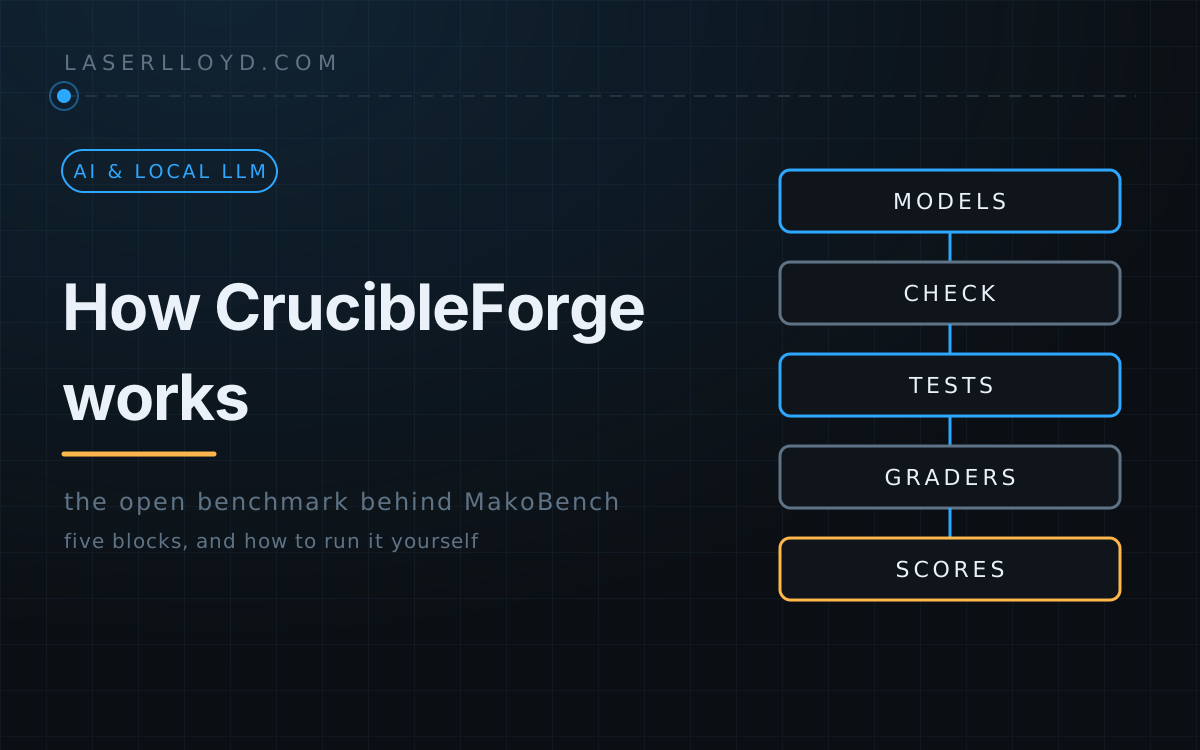
Wie CrucibleForge funktioniert: Ein offener LLM-Benchmark, erklärt
CrucibleForge ist der kostenlose, open-source-Benchmark, der der Grundlage für das MakoBench-System dient. Fünf Blöcke, ein Diagramm: Ihr Modell, eine Überprüfung der Einstellungen, die Tests, die Bewertungsalgorithmen sowie die Ergebnisse. Zusätzlich gibt es eine zehnminütige Anleitung zur Ausführung auf einem lokalen Server oder über eine gehostete API.
Was MakoBench testet – und was nicht
MakoBench testet Textmodelle in zwei Aufgaben: das Erstellen funktionierenden Codes sowie Rollenspiele oder Gespräche mit dem Modell. Hier sind die Modelle aufgelistet, die für die Nutzung geeignet sind, welche niemals verwendet werden können – und was eine Zeile benötigt, damit sie eine Bewertung erhält.
Hauptwerkbank öffnen Die Zahlen hinter jeder Seite hier.