文書化/記録
ベンチマークの仕組み、自身のモデルで同じテストを実行する方法、そしてこのテストスイートがどのように進化してきたかについて説明します。
スコアの伸び方
すべてのモデルが同一の標準テストを受けます。完全に正しく実行した場合、各カテゴリで10点が与えられます。あるカテゴリで90%以上のスコアを獲得したモデルには、さらにポイントが加算されるより難易度の高いボーナスパックが解放されます。各ベンチマークの改訂版には最大スコアの上限があり、新たなパックが追加されるごとにその上限も引き上げられます。トップレベルのモデルたちがあるパックをクリアし始めると、さらに難易度の高いパックが追加されます。こうすることで、小規模なローカルモデルから最先端のAPIまで、すべてのモデルに共通するテストが維持され、どのモデルもスコアの上限に達することはありません。
実行コスト
ホスト型モデルには「実行コスト」という項目があります(デフォルトでは表示されず、「列」から追加可能)。これは、プロバイダーが公表している料金体系に基づき、標準的なコードテストおよびチャットテストを1回実行する際に必要となる費用です。計算には各リクエストで送信・返送されるトークン数がすべて含まれます。ただしボーナスセットや再試行、判定処理(当社の自前ハードウェア上で実行される)、キャッシュやオフピーク割引などは考慮されていません。「〜」と記載されている場合は、プロバイダーがトークン単位での課金を行っていないため、定価に基づいてトークン数を算出したことを示します。「*」は一部のリクエストにおいて使用量データが返却されなかったことを意味します。ハイフンはモデルが当社の自前ハードウェア上で実行されたことを表します。
Built onおよび旧バージョン
各モデルには「Built on」というタグがあります。ホスト型モデルの場合は製品ライン名(例:Claude Opus)が記載され、ローカルモデルの場合は学習に用いられたベースとなる重みデータ名(例:Gemma 4 31B)が示されます。そのためファインチューニング版モデルも元となったモデルと並んで表示されます。フィルターボックスではこのタグおよびモデル名でも絞り込みが可能です。
「最新バージョンのみ」を選択すると、同じ製品ラインでより新しいバージョンがランキングに存在する場合、旧バージョンは非表示になります。このオプションはデフォルトで有効となっており、旧バージョンは最初から隠された状態です。無効にすればそれらも表示されます(この設定はブラウザに記憶され、非表示行へのリンクをクリックしても開くことができます)。旧バージョンが表示されている際には「古いバージョン」と表記されます。ファインチューニング版モデルは「Built on」欄に元となるモデルの名前が記載されるため、このフィルターの影響を受けることはありません。
MAX
あるテストカテゴリにおいて、すべてのセットで最高得点を獲得できるモデルには「MAX」というマークが付きます。このレベルを超えるとテストではモデル間の差異を判別できなくなるため、より難易度の高いセットが必要となり、その名称は該当行の詳細情報として記載されます。
ブロックされた応答
プロバイダーのコンテンツフィルターによって応答がブロックされる場合があります。モデルの行にはブロックされた回数が示され、詳細情報にもその旨が記載されています。ブロックされた応答は失敗した回答と同様に0点として扱われます。CrucibleForgeが各更新時においてトランスクリプトからこれらを自動検出するため、手作業なしでも今後の実行結果に反映されます。
なぜMakoBenchなのか?
ショートフィン・マコは「海の中で最も速いサメ」とよく言われます。Wikipediaによれば、瞬間的な速度は約74km/hに達するとされていますが、推定値にはばらつきがあり実測も困難です。私たちはこのテストスイートを迅速に実行できるよう構築しました。その裏側ではオープンソースエンジンであるCrucibleForgeが処理を行っています。

MakoBenchの仕組み:オープンなLLMベンチマークの解説
MakoBenchがどのようにしてモデルの回答をスコアに変換するか、各ステップごとに図解付きで説明します。事例の採点方法、判定プロセスの仕組み、コード+チャット機能、マージンの概念、そしてボーナスセットがどのように解除されるかについても解説します。実例では、実際のモデルを使用しています。

自分のモデルでCrucibleForgeを実行する:インストールガイド
MakoBenchの背後で動作するオープンソースエンジンであるCrucibleForgeをインストールし、任意のOpenAI互換モデルを指定すれば、コードスコアとチャットスコアがそれぞれ得られます。標準的な実行においては両スコアとも満点の10となります。実際のコマンドや出力結果も確認でき、1.6分間の簡易テストにかかった費用はわずか2セントです。
MakoBenchスイートの履歴:以前のバージョン
MakoBenchのテスト内容は時々変更され、スコアはそれを生成したテスト群の中でのみ意味を持ちます。ここが以前のボードたちが存在する場所であり、私たちがそれらを保持している理由です。
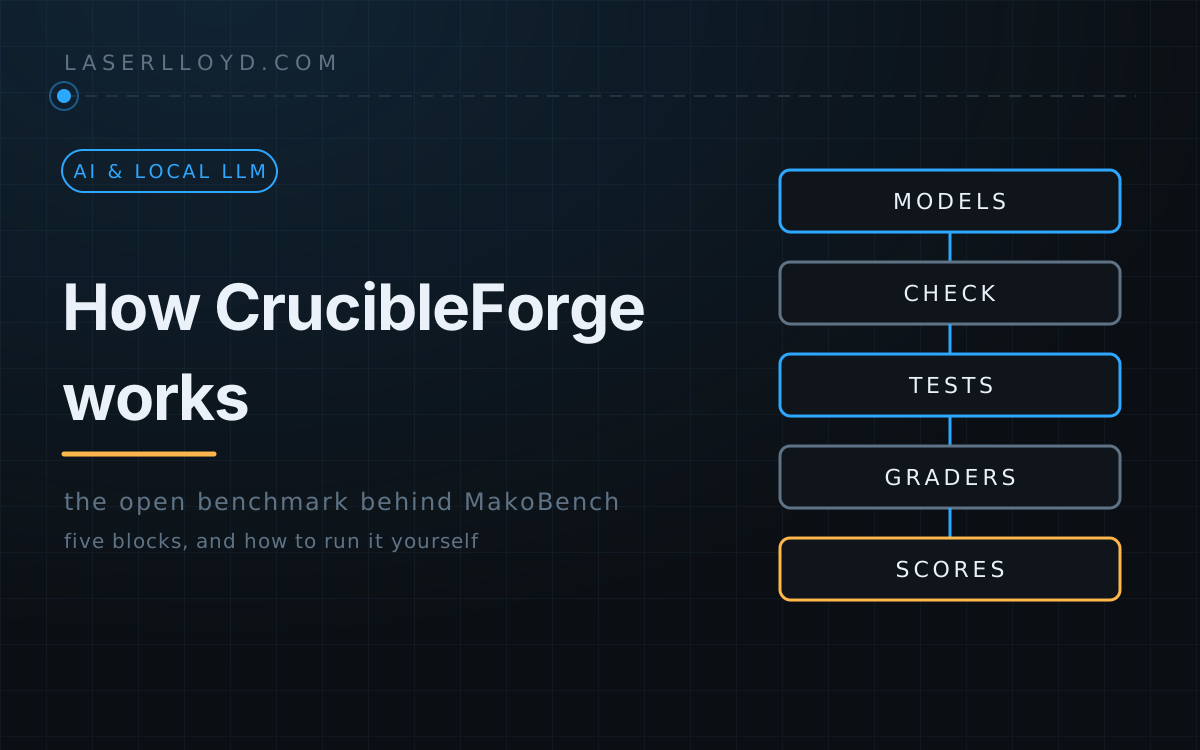
CrucibleForgeの仕組み:オープンなLLMベンチマークの解説
CrucibleForgeは、MakoBenchボードの背後で動作する無料のオープンソースベンチマークです。5つのブロックと1枚の図で構成されており、ご自身のモデル、セットアップ確認、各テスト、採点者、そして得点が示されます。さらに、ローカルサーバーやホスティングされたAPI上でこれを実行するための10分程度のガイドも含まれています。
MakoBenchがテストするもの、そしてテストしないもの
MakoBenchでは、テキストモデルを「動作するコードの生成」と「ロールプレイや対話相手としてのチャット」という2つのタスクで評価します。ここでは、どのモデルがランキングに載る資格があるか、どのモデルが決して載れないか、そしてランク付けされるためには各行に何が必要かを説明します。
メインベンチを開く ここの各ページの裏にある番号です。