Desarrollado por CrucibleForge
Documentación
Cómo funciona el benchmark, cómo ejecutar las mismas pruebas en sus propios modelos y cómo ha evolucionado la suite.
Cómo crece la escala de puntuación
Todos los modelos realizan la misma prueba estándar; una ejecución perfecta obtiene 10 puntos en cada categoría. Un modelo que consiga al menos el 90 % de puntuación en una sección desbloquea un paquete de bonificación más difícil, el cual añade puntos adicionales. Cada revisión del benchmark tiene un máximo fijo; la incorporación de nuevos paquetes lo aumenta. Cuando los mejores modelos comienzan a superar un paquete, añadimos uno más difícil. De este modo, existe una prueba común para todos los modelos, desde pequeños modelos locales hasta las API más avanzadas; nadie alcanza el límite máximo.
Coste de ejecución
Los modelos alojados tienen un “Coste de ejecución” (desactivado por defecto; se puede añadir desde la opción “Columnas”): representa cuánto cuesta una ejecución de las pruebas estándar de Código y Chat según los precios publicados por el proveedor, sumando todos los tokens enviados y recibidos en cada solicitud. Este cálculo excluye los paquetes de bonificación, los reintentos, el sistema de evaluación (que se ejecuta en nuestro propio hardware) y cualquier descuento por uso fuera de horas punta o por almacenamiento en caché. El símbolo “~” indica que el proveedor no cobra por cada token; por eso hemos calculado el coste basándonos en el precio de lista. El símbolo “*” significa que algunas solicitudes no devolvieron datos sobre su uso. Un guion indica que el modelo se ejecutó en nuestro propio hardware.
“Built on” y versiones anteriores
Cada modelo cuenta con una etiqueta “Built on”. Para modelos alojados, esta etiqueta corresponde a la línea de producto, como por ejemplo Claude Opus; para modelos locales, indica los pesos base con los que se entrenaron, como Gemma 4 31B; de este modo, un modelo afinado aparece junto al modelo del cual proviene. El cuadro de filtros también busca coincidencias tanto en esta etiqueta como en el nombre del modelo.
La opción “Solo versiones más recientes” oculta las versiones anteriores de un proveedor cuando existe una versión más nueva de la misma línea que sí figura en la tabla y tiene una clasificación. Esta opción está activada por defecto, por lo que las versiones antiguas permanecen ocultas; desactívela para verlas (la tabla guarda tu preferencia, y el enlace a una fila oculta sigue permitiendo acceder a ella). Cuando se muestran, las filas correspondientes a versiones anteriores llevan la etiqueta “versión anterior”. Los modelos afinados conservan el nombre de su modelo base en la columna “Built on” y nunca se ocultan por esta opción.
MAX
Un modelo puede alcanzar la máxima puntuación en todas las categorías de una sección de pruebas; en ese caso, se marca como “MAX”. Como las pruebas no pueden diferenciar más a los modelos por encima de ese nivel, es necesario incorporar un conjunto de pruebas más difícil para esa sección; el nombre de dicho conjunto aparece en los detalles de la fila correspondiente.
Respuestas bloqueadas
El filtro de contenido del proveedor puede bloquear algunas respuestas. La fila del modelo indica cuántas respuestas fueron bloqueadas, con una nota explicativa en sus detalles; cada respuesta bloqueada obtiene una puntuación de cero, igual que una respuesta fallida. CrucibleForge detecta estas situaciones en las transcripciones cada vez que se actualiza la tabla, por lo que las ejecuciones futuras quedarán debidamente marcadas sin necesidad de intervención manual.
¿Por qué MakoBench?
El tiburón mako de aleta corta suele describirse como el tiburón más rápido del océano: Wikipedia señala que puede alcanzar velocidades de hasta unos 74 km/h, aunque las estimaciones varían y tales cifras son difíciles de medir con exactitud. Diseñamos esta suite para que se ejecute rápidamente; el motor de código abierto CrucibleForge se encarga de todo el trabajo subyacente.

Cómo funciona MakoBench: Explicación del benchmark de LLM de código abierto
Cómo MakoBench convierte las respuestas de un modelo en una puntuación, paso a paso, con un diagrama para cada etapa: cómo se califican los casos, cómo funciona el juez, Code plus Chat, el margen de puntuación y cómo se desbloquean los conjuntos de bonificación. Los ejemplos prácticos utilizan modelos reales del tablero.

Ejecute CrucibleForge con sus propios modelos: Guía de instalación
Instale CrucibleForge, el motor de código abierto que impulsa MakoBench; luego indíquele que utilice cualquier modelo compatible con OpenAI para obtener las puntuaciones de Código y Chat, siendo 10 puntos en cada una de ellas el resultado ideal en una ejecución estándar. Se trata de comandos reales, con resultados reales; además, existe una prueba rápida que dura 1,6 minutos y cuesta tan solo 2 centavos.
Historial de MakoBench Suite: Versiones anteriores
Las pruebas de MakoBench cambian de vez en cuando, y una puntuación solo tiene sentido dentro del conjunto de pruebas que la genera. Aquí es donde se encuentran las placas anteriores y por qué las hemos conservado.
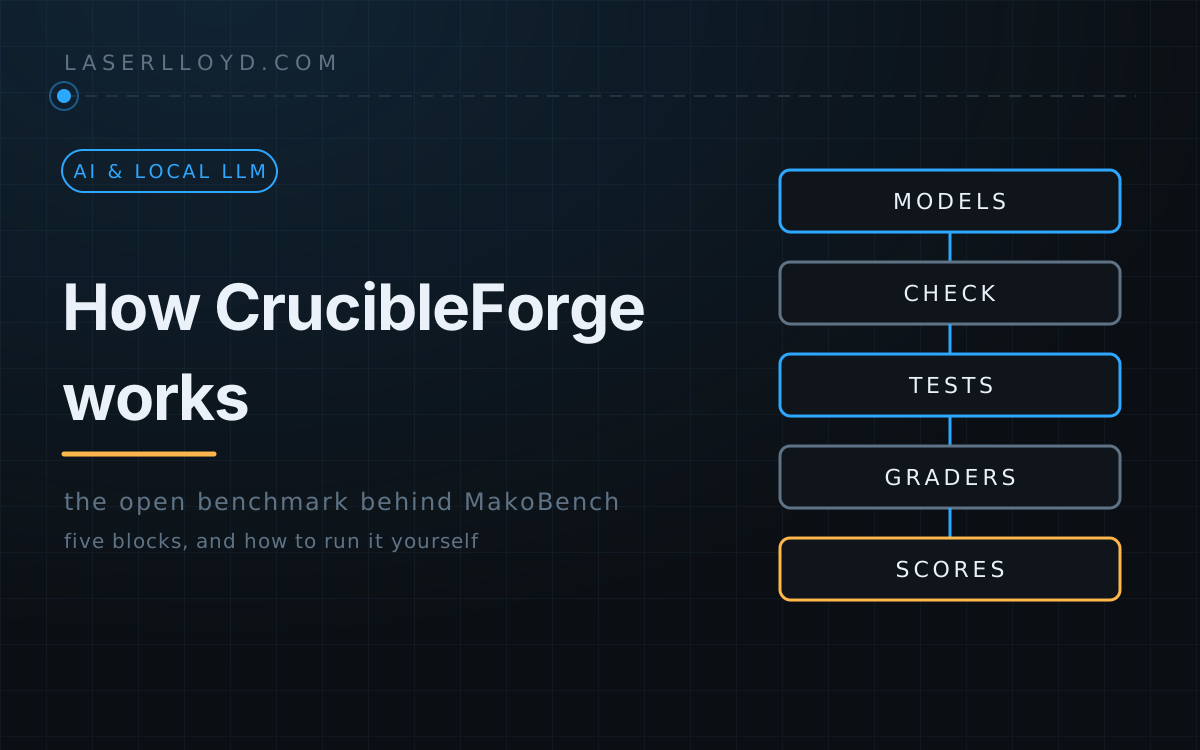
Cómo funciona CrucibleForge: una explicación sobre este benchmark abierto para LLM.
CrucibleForge es el sistema de evaluación gratuito y de código abierto que sustenta la plataforma MakoBench. Cinco bloques, un único diagrama: su modelo, una verificación de configuración, las pruebas, los correctores y las puntuaciones. Además, incluye una guía de diez minutos para ejecutarlo en un servidor local o mediante una API alojada.
Qué pruebas realiza MakoBench, y qué no
MakoBench prueba los modelos de texto en dos tareas: generar código funcional y realizar juegos de rol o conversaciones como compañeros. A continuación, se indica qué modelos pueden formar parte de la lista, cuáles nunca podrán estar en ella y qué requisitos debe cumplir una entrada para obtener un ranking.
Abrir el banco principal Los números detrás de cada página aquí.