ChatForge: um assistente de IA com NPU local para a Tecla Copilot
- Categoria
- IA e LLM Local
- Publicado em
- 2 outubro 2026
- Atualizado em
- 3 outubro 2026
- Por
- Jacob Lloyd — escrito com ajuda de IA, depois do projeto
- Tempo de leitura
- 15 min de leitura
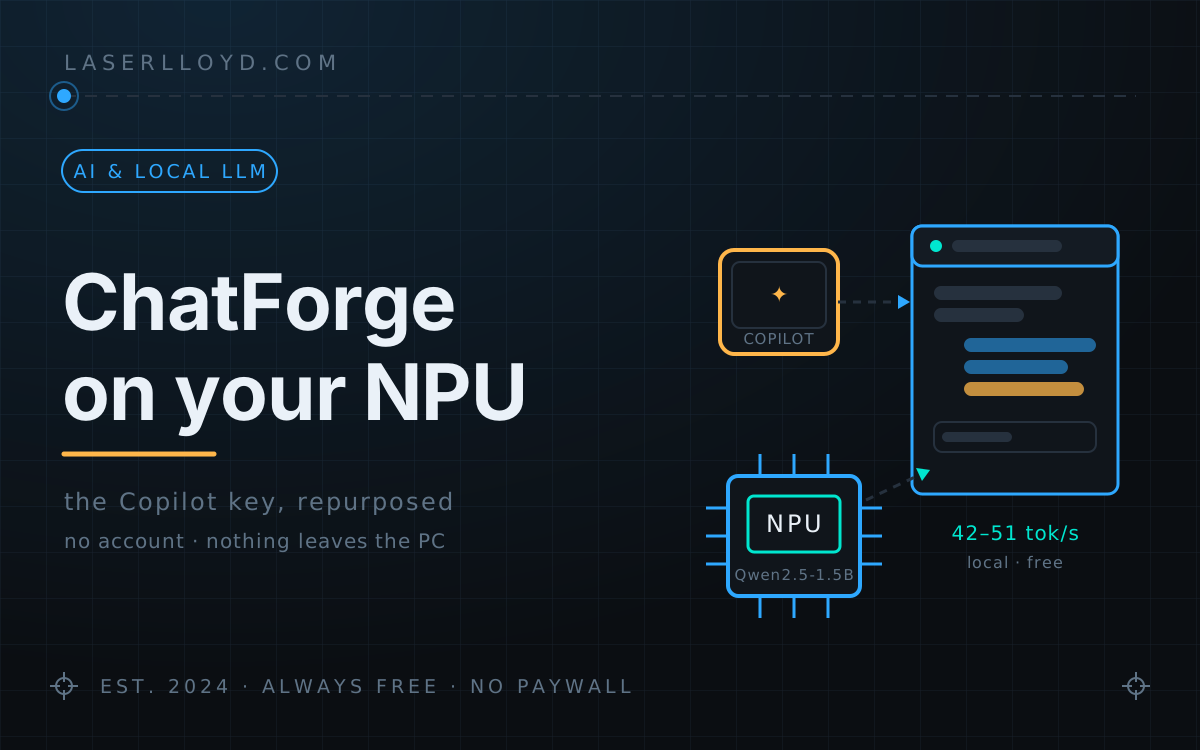
Em termos simples: Os novos laptops da Intel possuem um chip de IA especial (um NPU) que, na maioria das vezes, fica sem uso. Eles também têm uma tecla Copilot que ativa o assistente da Microsoft. O ChatForge é um programa gratuito que dá àquela tecla uma função diferente: ela abre uma pequena janela de chat que responde às perguntas com base em um modelo rodando no próprio laptop do usuário. Não é necessário criar conta nem pagar taxa mensal. Além disso, o programa pode buscar informações em tempo real, como previsão do tempo e notícias. Para perguntas mais complexas, a mesma janela pode consultar um serviço de IA mais avançado.
Meu laptop tem uma tecla Copilot. Assim que o liguei, ela abria o Microsoft Copilot; agora, porém, abre meu próprio assistente: um modelo Qwen de 1,5 bilhão de parâmetros que roda na UPN do laptop, gerando de 42 a 51 tokens por segundo. Não é necessário nenhuma conta, não há cobrança por token, e as conversas nunca saem do próprio PC. O ChatForge é o aplicativo para a bandeja do Windows 11 que criei para isso: uma única tecla de atalho, um pequeno pop-up, um modelo local para responder às perguntas cotidianas; além disso, meu servidor com GPU ou um modelo na nuvem ficam a apenas um clique de distância no mesmo menu, para tudo o que for mais complexo. Este artigo explica o que esse sistema faz, como a UPN realmente se comporta (inclusive sobre o modelo que foi compilado corretamente, mas ainda assim respondia de forma incompreensível), e como fazer com que um modelo de 1,5 bilhão de parâmetros forneça respostas reais, em vez daquela mensagem genérica “Não tenho acesso a dados em tempo real”.
Resumo:
- O que é: um assistente gratuito para a área de notificações do Windows 11, licenciado sob a licença MIT. Pressionar
Ctrl+Alt+C(ou a tecla Copilot, reconfigurada via PowerToys) abre um pop-up de 420 × 620 pixels no canto inferior direito; pressionar Esc o fecha. - O modelo local:
Qwen2.5-1.5B-Instruct(versão INT4, com download de 0,94 GB), servido pelo OpenVINO Model Server na unidade NPU “AI Boost” da Intel. O primeiro carregamento leva cerca de 45 segundos; depois disso, o modelo é carregado do cache em aproximadamente 3 segundos, com uma velocidade de decodificação entre 42 e 51 tok/s. Após 10 minutos de inatividade, o modelo é descarregado da memória. - Modelos maiores, mesmo menu: StudioForge (seu próprio servidor com GPU), MiniMax, OpenAI, DeepSeek ou qualquer URL compatível com o padrão OpenAI. As chaves de acesso são armazenadas no Gerenciador de Credenciais do Windows; nunca em arquivos de configuração.
- Nove ferramentas: busca na web e notícias, obtenção de conteúdo de páginas, previsão do tempo, Wikipedia, taxas de câmbio, data e hora, calculadora — além da ferramenta
create_document, que salva um arquivo Word, Excel ou PowerPoint gerado pelo modelo. É possível anexar até 10 arquivos por mensagem e fazer perguntas sobre eles. - O que não é: um agente autônomo. Nenhuma ferramenta executa programas ou altera configurações; a única ferramenta que gera conteúdo só pode criar novos arquivos na sua própria pasta.
- Requisitos: Windows 11, Python 3.12 + uv + Git; para usar o modelo na NPU, é necessário um processador Intel Core Ultra. Sem NPU? Use apenas GPU/CPU ou provedores remotos.
O que você acaba obtendo
Uma pergunta, sem precisar de nenhum aplicativo: pressione a tecla, digite, leia e aperte Escape. A resposta indica qual modelo a escreveu e com que rapidez. Quando a pergunta exige dados em tempo real, um chip de ferramenta mostra o que foi consultado; ao pedir um relatório a um modelo maior, a resposta traz um cartão de documento com os botões Abrir e Mostrar na pasta.
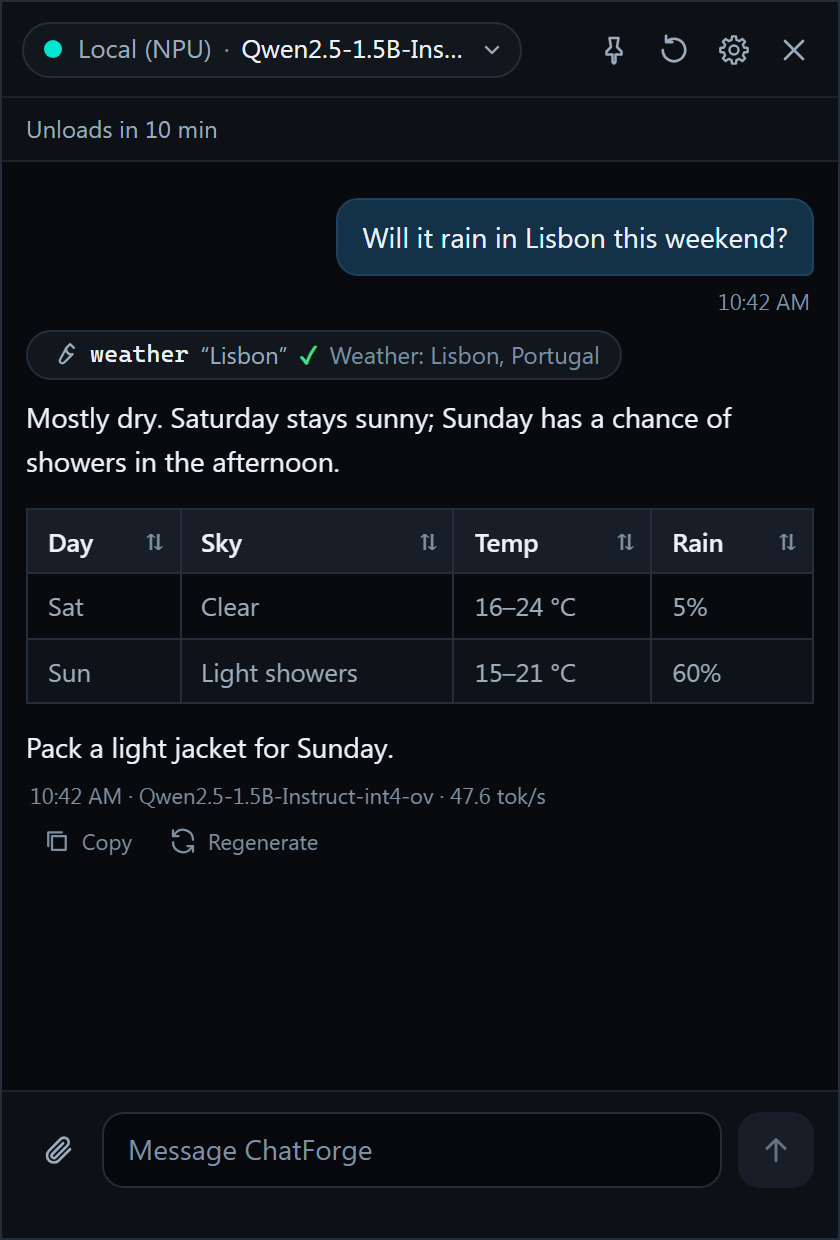
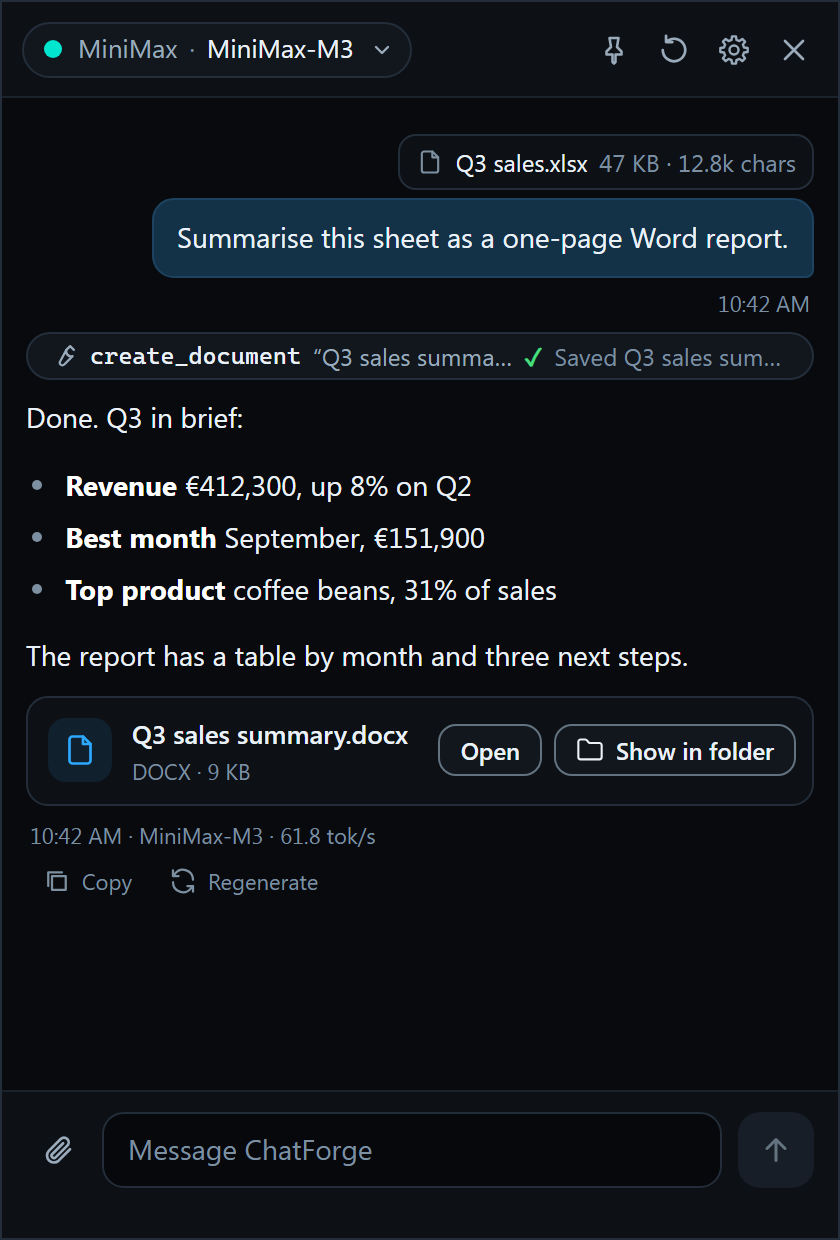
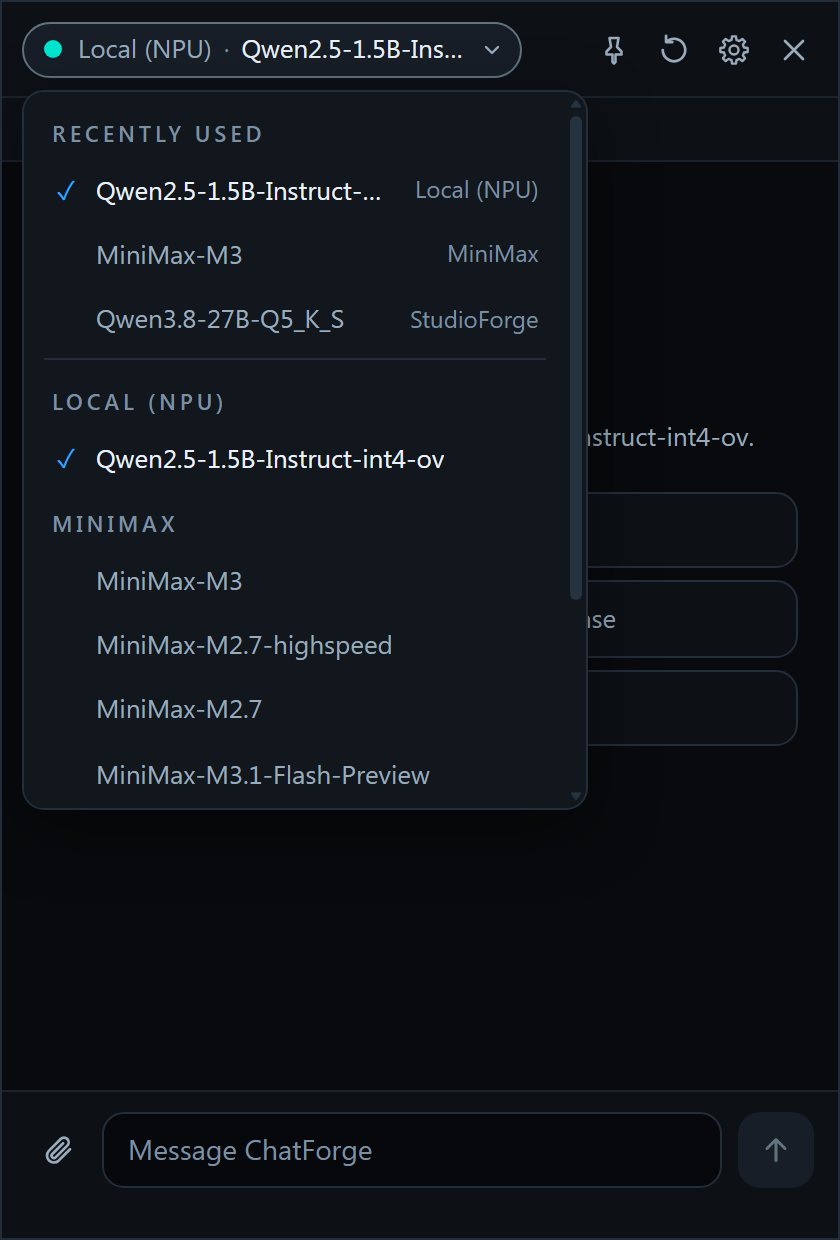
As capturas de tela mostram a interface real exibida no Microsoft Edge (o motor por trás do WebView2), em comparação com o protótipo de desenvolvimento do projeto. A conversa, os valores da planilha, a localização e o nome do servidor são dados de exemplo.
Como tudo se encaixa
Um único processo Python controla tudo: o ícone na bandeja do sistema, o atalho global, as janelas pop-up e de Configurações (usando pywebview com WebView2), além de um núcleo asyncio que transmite as respostas e executa as ferramentas. O servidor do modelo é um processo filho totalmente controlado por ele — iniciado quando a janela pop-up é aberta com o modelo local selecionado, e encerrado junto com o aplicativo por meio de um objeto de tarefa do Windows; assim, uma falha no sistema não permite que o modelo permaneça na memória.
O design reutiliza deliberadamente componentes de outros projetos meus: o supervisor de processos, o downloader, a área de notificações e o sistema de logs do StudioForge; a interface de chat e o pipeline de processamento Markdown do DisPatch; além do cliente de streaming da minha ferramenta de benchmarking. Cada módulo adaptado indica isso claramente no seu cabeçalho. Esses componentes já haviam sido testados durante meses de uso diário — o que explica por que o primeiro commit e a versão v0.1.0 foram feitos com apenas dois dias de diferença (da noite de 30/09/2026 até 02/10/2026). Um agente de IA cuidou da montagem do sistema, seguindo um plano escrito contendo cerca de 1.000 linhas.
Instalação
O arquivo docs/SETUP.md do repositório contém um guia completo, com verificação após cada etapa; a versão resumida consiste em três comandos PowerShell e o download de um modelo:
git clone https://github.com/LaserLloyd/ChatForge.git
cd ChatForge
py -3.12 -m uv sync --extra dev
py -3.12 -m uv run chatforge runtime install # OpenVINO Model Server 2026.4.0; download de 139 MB; SHA-256 especificado
py -3.12 -m uv run chatforge doctor # tabela de resultados: pass/warn/fail para Python, WebView2, NPU, OVMS, keyring, disco…
Em seguida, execute o arquivo (launchers\ChatForge.bat), abra Configurações > Modelos, procure por Qwen e clique em Download na linha marcada como Recomendado — OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov, 0,94 GB. Na primeira execução, o programa ativa a opção de iniciar automaticamente ao fazer login (uma tarefa do Agendador de Tarefas específica para cada usuário; nada aqui exige direitos de administrador) e registra o atalho de teclado. Na primeira vez que o modelo é carregado, a NPU o compila: leva cerca de 45 segundos, com uma contagem regressiva no cabeçalho da janela pop-up. A partir daí, cada carregamento do modelo é feito a partir do cache de compilação, em aproximadamente 3 segundos.
A tecla Copilot
A parte que ninguém documenta na caixa: a tecla Copilot não é uma tecla que você possa reconfigurar. Ela envia a combinação Win+Shift+F23; o Windows registra essa combinação para uso próprio, e o seletor de configurações da tecla oferece apenas aplicativos empacotados e assinados — portanto, nenhum programa comum consegue receber esse sinal. A solução viável é usar o Keyboard Manager do PowerToys: redefina o atalho Win (Esquerda) + Shift (Esquerda) + F23 para Ctrl+Alt+C (o atalho do ChatForge) e ative a opção Executar na inicialização do PowerToys. Com essa única reconfiguração, a tecla reservada pela Microsoft para o Copilot passa a abrir seu próprio assistente. Se a tecla voltar a abrir a Busca do Windows ou o Copilot, significa que o PowerToys não está em execução — esse é o único modo de falha possível.
Por que vale a pena criar um modelo de 1,5 bilhão
Um modelo de 1,5 bilhão de parâmetros com uma janela de contexto de 4096 tokens é realmente pequeno; a engenharia interessante do ChatForge gira justamente em torno desse fato, e não contra ele:
- Lista curta de ferramentas. Existem nove ferramentas disponíveis, mas o modelo local oferece apenas cinco (pesquisa, busca de páginas, previsão do tempo, data/hora e calculadora). Modelos pequenos ficam confusos com listas longas de ferramentas; reduzir essa lista é o que mantém as chamadas às ferramentas organizadas.
- Consulte primeiro. Perguntas que exigem dados em tempo real (“clima”, “preço atual”) fazem com que a ferramenta correspondente seja executada antes da primeira rodada de resposta do modelo; assim, ele responde com base nos resultados obtidos, em vez de adivinhar. Trata-se apenas de correspondência de padrões — sem necessidade de novas chamadas ao modelo.
- Recuperação de recusas. Modelos pequenos tendem a responder “Não tenho acesso a dados em tempo real”, mesmo quando há uma ferramenta de busca disponível. Respostas que recusam a solicitação ou prometem uma consulta que nunca é feita são descartadas; o sistema executa a consulta por conta própria e o modelo responde novamente. Nesse meio tempo, um aviso “Consultando…” aparece na tela.
- Sem resumos automáticos. Quando uma conversa ultrapassa o limite da janela de contexto, as mensagens mais antigas são simplesmente excluídas do prompt; um divisor visual indica exatamente onde a visão do modelo começa. Isso não exige novas chamadas ao modelo, nada é parafraseado sem seu conhecimento, e o modelo é informado de que mensagens antigas foram removidas, portanto ele pergunta em vez de inventar respostas.
- Proteção contra loops e limite de uso. Uma mensagem pode receber no máximo 6 chamadas a ferramentas; chamadas idênticas são recusadas — um modelo de 1,5 bilhão de parâmetros continuaria chamando indefinidamente a mesma ferramenta se permitido.
- Rede de segurança. Caso o modelo NPU falhe ao carregar, trave ou exceda o tempo limite, a mesma mensagem pode ser reenviada para outro provedor de sua escolha; a resposta indicará qual deles atendeu.
Nada disso exige o uso do NPU — o mesmo mecanismo funciona com modelos maiores — mas é isso que permite ao modelo local gratuito responder corretamente a perguntas como “Vai chover neste fim de semana?”, operando à velocidade de 42–51 tokens por segundo no NPU, em vez de recusar educadamente a solicitação.
O modelo que compilou sem problemas, mas gerou respostas inúteis
O plano original era utilizar o Qwen3-4B como modelo local. O arquivo docs/RUNTIME-NOTES.md do repositório descreve o obstáculo que impediu isso: o Qwen3-4B-int4-ov compila sem problemas para o NPU, mas gera respostas inúteis com o OVMS 2026.4 — enquanto os mesmos arquivos do modelo produzem respostas corretas na CPU, à velocidade de 24 tokens por segundo. O problema é específico ao NPU; todas as configurações testadas falharam, e nenhuma das versões quantizadas possui um parser capaz de interpretar chamadas a ferramentas no OVMS 2026.4. Se você pretende usar um modelo em um NPU da Intel: uma compilação bem-sucedida não garante nada; é preciso testar as saídas antes de confiar nelas.
O modelo que acabou sendo utilizado, testado num Core Ultra 5 226V (Lunar Lake):
| Qwen2.5-1.5B-Instruct INT4 no NPU | Valor medido |
|---|---|
| Primeira compilação | 44,5 s |
| Carregamento a partir do cache de compilação | 2,7–3,2 s |
| Velocidade de decodificação | 42–51 tokens/s |
| Tempo até o primeiro token (prompts curtos) | 0,5–0,8 s |
| Tamanho do cache de compilação no disco | 306 MiB |
| Janela de contexto | 4096 tokens |
Uma observação importante: o OVMS aceita um parâmetro BEST_PERF que aumenta a velocidade de decodificação em cerca de 10% (para 48,3 tokens/s), mas exige 135 segundos adicionais para compilar — três vezes mais que o padrão. O ChatForge desativa esse parâmetro por padrão, e isso é acertado; os 44,5 segundos iniciais já representam um limite aceitável para usuários comuns.
Envio de arquivos e geração de documentos
É possível anexar até 10 arquivos por mensagem (arrastando ou colando — cada um com até 20 MB): código, texto, CSV, JSON, HTML, Word, Excel, PowerPoint, OpenDocument, RTF, e-mails, PDFs e até arquivos antigos .doc. Arquivos .xls/.ppt são convertidos automaticamente via Microsoft Office, se instalado. Imagens são verificadas, giradas para ficarem na orientação correta, redimensionadas para 1568 pixels e despojadas de metadados — dados como câmera, GPS e horário são removidos antes de qualquer armazenamento ou envio; modelos incapazes de “ver” imagens recebem o texto extraído por meio do OCR.
Na direção inversa, a ferramenta create_document permite que um modelo StudioForge ou em nuvem salve seus textos gerados: arquivos .docx, .xlsx e .pptx são criados pelo próprio ChatForge a partir do Markdown produzido pelo modelo, usando apenas bibliotecas padrão — não é necessário o Office nem pacotes externos. Os arquivos são salvos em Documents\ChatForge; nomes repetidos resultam em nomes como relatório (2).docx, evitando sobrescritas; a resposta inclui um cartão com os botões Abrir e Mostrar na pasta. O pequeno modelo local, porém, não dispõe dessa ferramenta.
O que o ChatForge não é
O ChatForge não é um agente; essa limitação é estrutural, não apenas uma promessa contida no prompt. Oito das nove ferramentas são apenas consultas de leitura; a nona só permite adicionar novos arquivos à sua própria pasta, sem jamais sobrescrever nada. Nenhuma ferramenta executa programas, altera configurações ou lê arquivos que você não anexou. A ferramenta fetch_url bloqueia endereços privados e locais (inclusive via DNS rebinding); a calculadora é um avaliador com lista de funções permitidas, sem suporte a eval. Chaves de API são armazenadas no Windows Credential Manager e protegidas pelo redator de logs; o processo filho do servidor do modelo opera sob um objeto de “kill-on-close”, garantindo que morra junto com o aplicativo. O sistema mantém apenas uma conversa ativa, sem arquivar todas as interações anteriores. Para o tipo de tarefas que um assistente de área de trabalho deve desempenhar, o pior cenário possível seria uma resposta errada ou a criação acidental de um novo arquivo numa pasta qualquer.
Cuidados necessários
- O
pythonpadrão no Windows é apenas um “stub” da Microsoft Store. Use semprepy -3.12 -m uv run …ou os executáveis emlaunchers\. Esse detalhe pode causar problemas antes mesmo de qualquer outra coisa acontecer. - A tecla Copilot não pode ser usada como atalho. Ela é
Win+Shift+F23, e o Windows a reserva. Use o PowerToys para reconfigurá-la ou nada funcionará. - Uma compilação bem-sucedida não garante um modelo funcional. O Qwen3-4B compilou sem erros, mas gerou respostas inúteis no NPU; o catálogo o classifica como Evitar. Qualquer modelo não listado é marcado como Não testado — teste as saídas antes de confiar nelas.
- Atualizações de driver ou ciclos de suspensão/retomada podem corromper o cache de compilação. Acesse Configurações > Modelos > Limpar cache, depois Carregar. Um provedor alternativo garante que você continue recebendo respostas nesse meio tempo.
- O modelo pequeno perde eficiência em conversas longas — para de chamar ferramentas, entra em loops ou responde mal. Isso é esperado num modelo de 1,5 bilhão de parâmetros com contexto limitado; não se trata de um bug: limpe a conversa ou mude para um modelo maior para perguntas complexas.
- Arquivos
.xls/.pptantigos exigem o Office instalado (a conversão ocorre numa cópia temporária). Sem o Office, converta-os previamente para.xlsx/.pptx. Fotos HEIC precisam do pacote opcionalpillow-heif, ou sejam exportadas como JPEG. - Observação sobre licenças: o aplicativo é distribuído sob licença MIT, mas a biblioteca
pystray(usada para o ícone na bandeja) está sob LGPL-3.0; ela é importada sem modificações durante a execução. Isso é aceitável se você instalar o programa normalmente; porém, ao distribuir um pacote “frozen” que inclua essa biblioteca, você assumirá as obrigações de relinking da LGPL.
Minha avaliação final
Do primeiro commit à versão 0.1.0, que já uso, em apenas dois dias, o maior mérito foi reaproveitar componentes já testados: o supervisor, a interface de chat e o cliente de streaming vieram de projetos já em produção aqui. O NPU acabou sendo a parte mais fácil; o verdadeiro desafio foi tornar um modelo de 1,5 bilhão de parâmetros útil (reduzindo as ferramentas disponíveis, priorizando consultas prévias e recuperando situações de recusa) e mantendo o escopo restrito: sem funcionalidades de agente, sem arquivamento de conversas e sem integração padrão com a nuvem. É um produto novo, exclusivo para Windows; o número da versão indica que ainda está em fase inicial, e o conjunto de testes — 1.520 testes em Python e 114 em JavaScript, todos aprovados no Windows e Linux via CI — é o que me dá confiança para seguir adiante.
Obtenha-o
A versão da árvore de código descrita neste artigo é a v0.1.0, correspondente ao commit 2edd2d4. Ela está disponível publicamente no GitHub e possui licença MIT:
github.com/LaserLloyd/ChatForge
git clone https://github.com/LaserLloyd/ChatForge.git
cd ChatForge
py -3.12 -m uv sync --extra dev
Dentro do repositório: 78 arquivos Python e aproximadamente 27.400 linhas de código em src/; o plano escrito a partir do qual o agente desenvolveu o projeto, docs/PLAN.md (1022 linhas); os passos de configuração e medições de desempenho em docs/SETUP.md e docs/RUNTIME-NOTES.md; um conjunto de 1.520 testes em Python e 114 testes em JavaScript, todos aprovados tanto no Windows quanto no Linux via CI. Os únicos códigos front-end incluídos são marked, DOMPurify e highlight.js.
Licença: MIT — você pode usar, modificar, distribuir ou vender o código, desde que mantenha a nota de copyright; não há garantias. Apenas uma dependência não possui licença MIT: a biblioteca pystray usa licença LGPL-3.0; ela é importada sem alterações durante a execução (a nota sobre redistribuição encontra-se em “Gotchas” acima).
Versões
Conforme o repositório na versão descrita neste artigo (verificado em 02/10/2026):
$ git log -1 --format='%h %ci'
2edd2d4 2026-10-02 18:04:38 +0900        # ChatForge v0.1.0

$ uv run pytest -q
1520 passed, 6 skipped, 6 deselected in 50.65s   # em Linux, Python 3.13.14

$ npm run -s test:js
tests 114 / pass 114 / fail 0                     # Node v24.18.0
O desempenho no Windows foi medido usando o OpenVINO Model Server 2026.4.0 (python_on) e o modelo OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov, em um processador Intel Core Ultra 5 226V. Os valores relativos ao NPU constam no arquivo docs/RUNTIME-NOTES.md, que também registra as configurações inviáveis do modelo Qwen3-4B.
Relacionado: StudioForge: um servidor LLM exclusivo para GPU · DisPatch: chat com IA auto-hospedado · Primeiras impressões do DeepSeek Harness (dsh) · Como executar o DeepSeek localmente: guia em 4 passos · Quanto realmente custam meus agentes de IA?
Downloads
Gratuito para uso pessoal. Se isso te economizar uma tarde, o botão do café está logo ali.