ChatForge : un assistant IA local doté d’un NPU pour la touche Copilot
- Catégorie
- IA et LLM locaux
- Publié
- 2 octobre 2026
- Mis à jour
- 3 octobre 2026
- Par
- Jacob Lloyd — rédigé avec l'aide de l'IA, une fois le projet terminé
- Temps de lecture
- 16 min de lecture
En clair : Les nouveaux ordinateurs portables Intel disposent d’une puce IA spéciale (un NPU) qui reste généralement inutilisée, ainsi que d’une touche Copilot permettant d’activer l’assistant de Microsoft. ChatForge est un programme gratuit qui confie à cette touche une autre fonction : il ouvre une petite fenêtre de chat qui répond en s’appuyant sur un modèle exécuté directement sur votre ordinateur, sans nécessiter de compte ni de frais mensuels. Cette fenêtre peut également afficher des informations en temps réel, comme la météo ou les actualités. Pour les questions plus complexes, elle peut faire appel à un service IA plus puissant.
Mon ordinateur portable est livré avec une touche dédiée à l’IA et un processeur NPU, mais dès la sortie de l’emballage, ils ne se sont jamais « rencontrés » : la touche ouvre Microsoft Copilot dans le cloud, tandis que le NPU reste inactif. Cela m’a dérangé bien plus que prévu. Désormais, cette touche ouvre ChatForge, mon propre assistant. Il exécute un modèle Qwen de 1,5 milliard de paramètres sur le NPU à une vitesse de 42 à 51 tokens par seconde. Pas de compte, pas d’abonnement, pas de facturation au nombre de tokens ; en outre, les conversations ne quittent jamais l’ordinateur. Lorsqu’une question dépasse les capacités de ce petit modèle, il suffit d’un clic pour faire appel à mon serveur GPU ou à un modèle cloud via la même fenêtre contextuelle.
Cet article fait le tour du sujet : ses fonctionnalités, l’expérience concrète d’utilisation du NPU (y compris le cas où un modèle s’est compilé parfaitement mais a ensuite produit des résultats incohérents), ainsi que les astuces permettant à un modèle aussi petit de fournir des réponses pertinentes, au lieu du comportement typique des petits modèles qui se contentent de répondre « je ne sais pas ».
Résumé
- Qu’est-ce que c’est ? Un assistant gratuit pour la zone de notification sous Windows 11, sous licence MIT.
Ctrl+Alt+C(ou la touche Copilot, reconfigurée via PowerToys) ouvre une fenêtre de 420 × 620 pixels en bas à droite ; la touche Échap la ferme. Source : github.com/LaserLloyd/ChatForge. - Le modèle local :
Qwen2.5-1.5B-Instruct(format INT4, téléchargement de 0,94 Go), servi par OpenVINO Model Server sur le NPU « AI Boost » d’Intel. La première compilation pour le NPU prend environ 45 secondes ; ensuite, le modèle se charge depuis le cache en 3 secondes et génère 42–51 tokens/s. Il se décharge automatiquement après 10 minutes d’inactivité. - Modèles plus gros, même menu : StudioForge (votre propre serveur GPU), MiniMax, OpenAI, DeepSeek ou tout autre URL compatible avec OpenAI. Les clés d’accès sont stockées dans le Gestionnaire de mots de passe Windows, jamais dans un fichier de configuration.
- Neuf outils : recherche web et actualités, récupération de pages, météo, Wikipédia, taux de change, date/heure, calculatrice — ainsi que
create_document, qui permet d’enregistrer un fichier Word, Excel ou PowerPoint généré par le modèle. Vous pouvez joindre jusqu’à 10 fichiers par message et les interroger. - Ce que ce n’est pas : un agent autonome. Aucun outil ne lance de programme ni ne modifie de paramètres ; seul l’outil d’écriture peut ajouter un nouveau fichier dans son propre dossier.
Ce que vous obtenez
Il suffit de poser une question pour accéder à toutes les fonctionnalités : appuyez sur la touche, tapez votre requête, lisez la réponse, puis appuyez sur Échap. Chaque réponse indique quel modèle l’a générée et à quelle vitesse ; ainsi vous savez toujours si c’est le modèle local gratuit ou un service payant qui a répondu. Lorsqu’une requête nécessite des données en temps réel, une icône d’outil précise ce qui a été recherché ; si vous sollicitez un modèle plus gros pour obtenir un rapport, la réponse inclut une carte de document avec les boutons Ouvrir et Afficher dans le dossier.
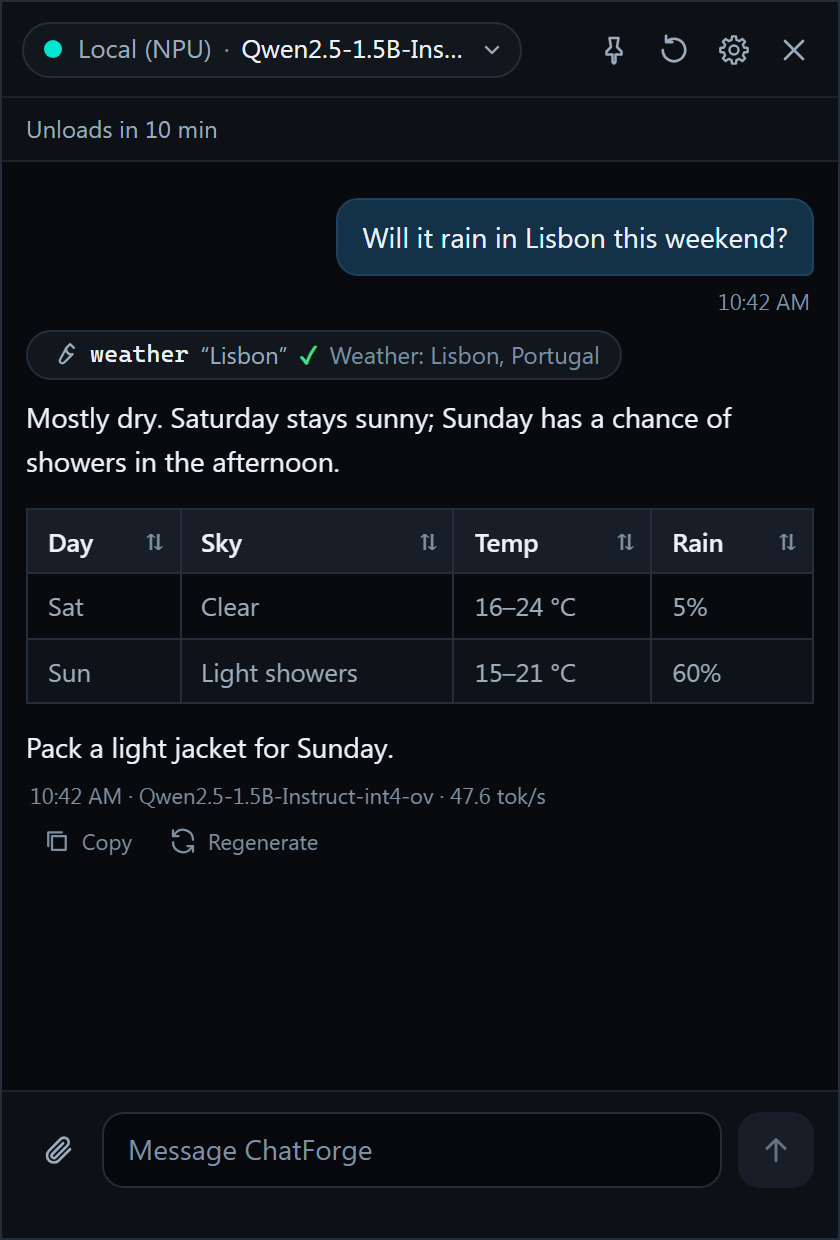
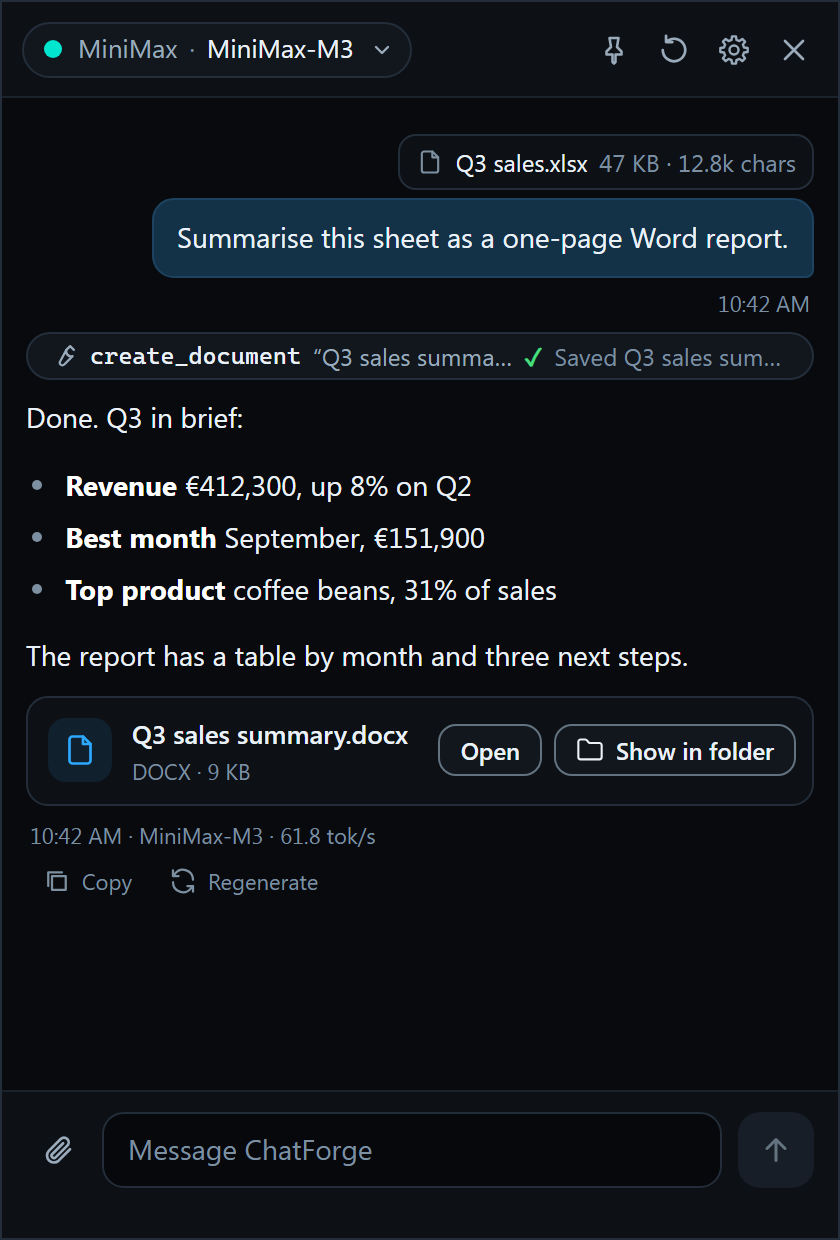
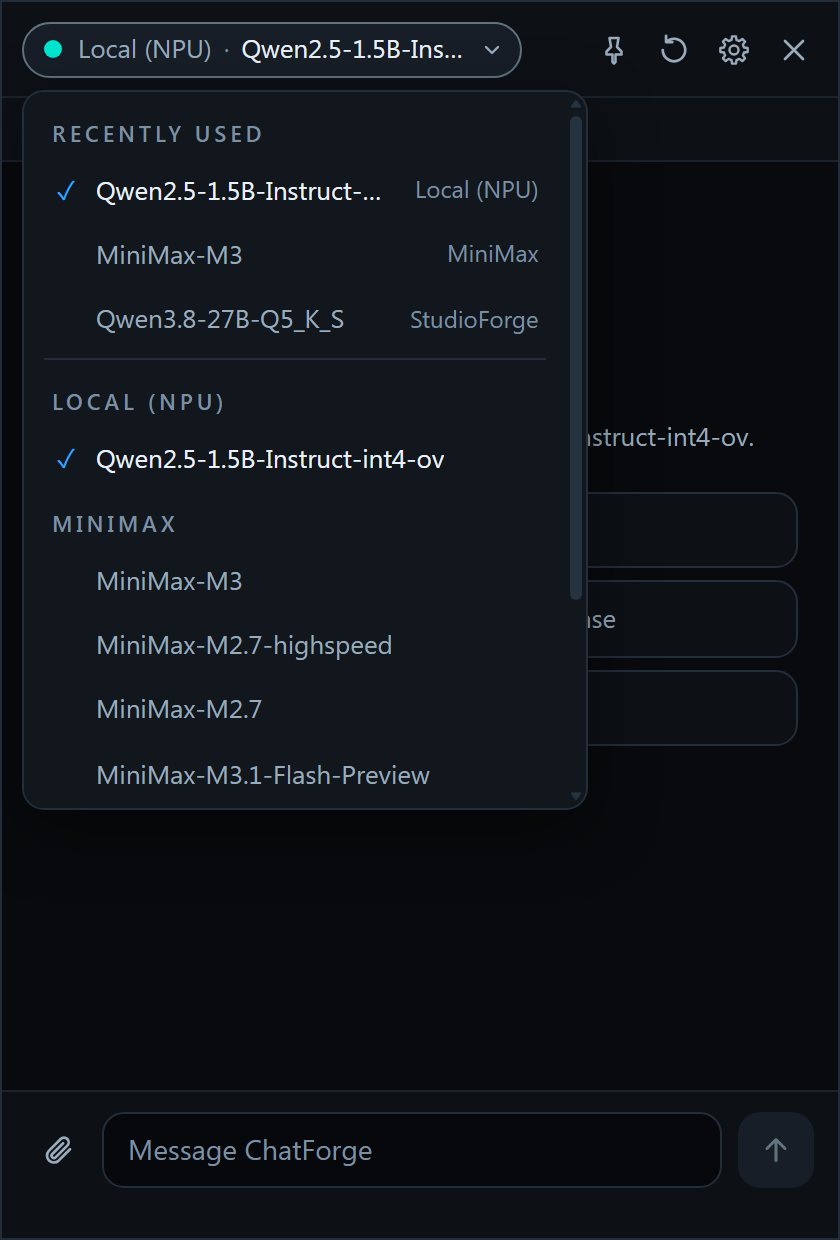
Les conversations, images, localisation et noms de serveurs figurant sur les captures d’écran sont fictifs ; l’interface est bien réelle, affichée dans Edge (moteur sous-jacent à WebView2) sur un prototype de développement du projet.
Où le télécharger
Un seul dépôt sous licence MIT : github.com/LaserLloyd/ChatForge, incluant les notes d’exécution contenant toutes les mesures NPU citées dans cet article. Préférez un fichier zip ? La section Téléchargements en bas de page propose la source complète, disponible également sur la page Téléchargements du site.
Comment tout s’articule
Un seul processus Python gère l’ensemble : l’icône dans la barre des tâches, le raccourci global, la fenêtre contextuelle et les paramètres (via pywebview sur WebView2), ainsi qu’un cœur asynchrone qui diffuse les réponses et exécute les outils. Le serveur de modèles est un processus enfant entièrement géré par celui-ci — lancé dès l’ouverture de la fenêtre avec le modèle local sélectionné, et supprimé en même temps que l’application grâce à un objet job Windows ; ainsi, une éventuelle panne ne laisse pas de processus modèle actif dans la mémoire.
Très peu de code a été écrit de zéro ; je le dis fièrement : le superviseur de processus, le téléchargeur, l’icône dans la barre des tâches et le système de journalisation proviennent de StudioForge ; l’interface de chat et le pipeline Markdown viennent de DisPatch, tandis que le client de diffusion a été repris de mon outil de benchmarking. Tous ces modules avaient déjà prouvé leur fiabilité lors d’une utilisation quotidienne sur plusieurs mois ; chaque module adapté en fait mention en en-tête. C’est grâce à cette réutilisation que le premier commit et la version v0.1.0 ne sont séparés que de deux jours (soir du 30/09/2026 au 02/10/2026), un agent IA ayant procédé à l’assemblage selon un plan écrit comptant environ 1 000 lignes.
Installation
Les instructions complètes se trouvent dans docs/SETUP.md du dépôt ; voici la procédure abrégée en trois commandes PowerShell et un téléchargement de modèle :
git clone https://github.com/LaserLloyd/ChatForge.git
cd ChatForge
py -3.12 -m uv sync --extra dev

py -3.12 -m uv run chatforge runtime install   # OpenVINO Model Server 2026.4.0, téléchargement de 139 Mo, SHA-256 vérifié
py -3.12 -m uv run chatforge doctor            # tableau de résultats pass/warn/fail : Python, WebView2, NPU, OVMS, keyring, espace disque…
Lancez ensuite l’application (launchers\ChatForge.bat), ouvrez Paramètres > Modèles, recherchez « Qwen » et cliquez sur Télécharger dans la ligne portant l’étiquette Recommandé — il s’agit de OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov, d’une taille de 0,94 Go. Lors du premier démarrage, l’application active le lancement au démarrage (via une tâche planifiée utilisateur — aucun droit administrateur n’est requis) et enregistre le raccourci. La toute première fois que le modèle se charge, le NPU le compile : cela prend environ 45 secondes, avec un compte à rebours affiché dans l’en-tête de la fenêtre pour éviter toute impression de blocage. Par la suite, chaque chargement s’effectue depuis le cache en seulement 3 secondes.
Le problème de la touche Copilot
Voici le détail que personne ne vous mentionne lors de l’achat du portable. La touche Copilot n’est pas une touche que l’on peut réassigner. Elle envoie la combinaison Win+Shift+F23 ; Windows enregistre cette combinaison pour son propre usage, et le sélecteur officiel des paramètres ne propose que des applications packagées et signées. Votre propre programme ne figure donc pas sur la liste autorisée pour utiliser cette touche sur votre clavier.
La solution viable est d’utiliser le Gestionnaire de clavier de PowerToys : réassignez le raccourci Win (Gauche) + Shift (Gauche) + F23 à Ctrl+Alt+C (le raccourci clavier de ChatForge), puis activez l’option Exécuter au démarrage dans PowerToys. Une seule réassignation suffit : la touche réservée par Microsoft pour Copilot ouvrira alors votre assistant. Si jamais cette touche rouvre à nouveau la recherche Windows ou Copilot, c’est que PowerToys ne fonctionne pas — c’est là le seul mode de défaillance possible, et il figure en premier dans la liste de dépannage car il se produit effectivement.
Rendre un modèle de 1,5 milliard d’éléments utile
Un modèle de 1,5 milliard d’éléments doté d’une fenêtre contextuelle de 4096 tokens est comparable à un poisson rouge possédant une carte de bibliothèque. L’ingénierie mise en œuvre dans ChatForge tient compte de cette limite plutôt que de prétendre la contourner :
- Une liste courte d’outils. Neuf outils sont disponibles, mais le modèle local n’en reçoit que cinq (recherche, récupération de page, météo, date/heure, calculatrice). Les petits modèles se perdent dans des menus d’outils trop longs ; réduire cette liste garantit des appels outils clairs.
- Rechercher d’abord. Une question nécessitant des données en temps réel (« météo », « dernières nouvelles », « prix actuel ») fait appel à l’outil correspondant avant la première passe du modèle, afin que celui-ci s’appuie sur les résultats plutôt que de deviner. Il s’agit simplement de correspondances de motifs, sans appel supplémentaire au modèle.
- Gestion des refus. Les petits modèles ont tendance à répondre « Je n’ai pas accès aux données en temps réel » même lorsqu’un outil de recherche est disponible. Toute réponse formulée à la première personne ou promettant une recherche non effectuée (« laissez-moi chercher ça… » sans le faire) est ignorée ; le moteur exécute alors la recherche lui-même et le modèle répond à nouveau. Un message « Recherche en cours… » s’affiche pendant ce temps, de sorte que vous ne voyez jamais cette première tentative erronée.
- Pas de résumé automatique. Lorsqu’une conversation dépasse la capacité de la fenêtre contextuelle, les tours de dialogue les plus anciens sont simplement omis du prompt ; un séparateur visuel indique précisément où commence la vision du modèle. Aucun texte n’est paraphrasé en arrière-plan, ce qui évite tout appel supplémentaire au modèle et lui signale que les messages anciens ont été supprimés afin qu’il pose des questions plutôt que d’inventer des réponses.
- Protection contre les boucles et limitation du nombre d’appels. Un message ne peut compter au maximum que 6 appels outils ; un appel identique répété est refusé — un modèle de 1,5 milliard d’éléments continuerait indéfiniment à solliciter l’outil météo s’il en avait l’occasion.
- Filet de sécurité. Si le modèle exécuté sur la puce NPU échoue à se charger, plante ou ne répond pas dans les délais impartis, le même message peut être renvoyé à un fournisseur de votre choix.
Rien de tout cela ne nécessite l’usage de la puce NPU — le même moteur fonctionne aussi avec les grands modèles — mais c’est ce qui permet au modèle local gratuit de répondre correctement à « Est-ce qu’il pleuvra ce week-end ? » à pleine vitesse sur la puce NPU, sans se contenter de refuser poliment.
Le modèle qui s’est compilé sans erreur mais a produit des résultats incohérents
Le plan initial prévoyait d’utiliser Qwen3-4B comme modèle local : un modèle plus grand, issu d’une famille plus récente, un choix évident. Le fichier docs/RUNTIME-NOTES.md du dépôt indique la raison de son échec : Qwen3-4B-int4-ov se compile sans le moindre problème sur la puce NPU, mais produit ensuite des résultats incohérents avec OVMS 2026.4 — alors que les mêmes fichiers modèles donnent des réponses correctes sur le CPU à une vitesse de 24 tokens/s. Le défaut est spécifique à la puce NPU ; toutes les configurations testées ont échoué, et les autres quantifications possibles ne permettent pas d’utiliser les outils dans OVMS 2026.4. Sur une puce NPU, une compilation sans erreur ne prouve rien du tout. Il faut donc vérifier les résultats avant de leur faire confiance.
Ce qui a finalement été déployé, testé sur un Intel Core Ultra 5 226V (Lunar Lake) :
| Qwen2.5-1.5B-Instruct INT4 sur la puce NPU | Mesures |
|---|---|
| Première compilation (une seule fois) | 44,5 s |
| Chargement depuis le cache de compilation | 2,7–3,2 s |
| Décodage | 42–51 tokens/s |
| Temps jusqu’au premier token (prompts courts) | 0,5–0,8 s |
| Taille du cache de compilation sur disque | 306 Mo |
| Fenêtre contextuelle maximale | 4096 tokens |
Une précision de réglage tirée du même fichier : OVMS accepte un paramètre BEST_PERF qui accroît la vitesse de décodage d’environ 10 % (48,3 tokens/s) en échange d’une compilation de 135 secondes — trois fois plus longue que par défaut. ChatForge ne l’active pas, et je pense que c’est juste : les 45 secondes nécessaires lors de la première utilisation se situent déjà à la limite de ce qu’un utilisateur patient peut accepter avant de croire que le programme est défectueux.
Fichiers entrants, documents sortants
Vous pouvez joindre jusqu’à 10 fichiers par message (via l’icône en forme de trombone, glisser-déposer ou copier-coller — 20 Mo chacun) : code et texte, CSV, JSON, HTML, Word, Excel, PowerPoint, OpenDocument, RTF, e-mails, PDF, voire d’anciens fichiers .doc. Les anciens formats .xls/.ppt sont convertis via Microsoft Office s’il est installé. Les images sont vérifiées, redressées, réduites à 1568 pixels et dépouillées de leurs métadonnées — données GPS, heure et informations de prise de vue disparaissent avant toute sauvegarde ou envoi ; les modèles incapables de voir les images reçoivent simplement le texte extrait par l’OCR de Windows.
En sens inverse, create_document permet à un modèle StudioForge ou cloud d’enregistrer ses productions : ChatForge génère alors les fichiers .docx, .xlsx et .pptx à partir du Markdown produit par le modèle, en utilisant uniquement la bibliothèque standard Python — aucun logiciel Office n’est nécessaire. Les documents se stockent dans Documents\ChatForge ; un nom déjà utilisé devient rapport (2).docx pour éviter toute écrasement, et la réponse affiche une carte avec les options Ouvrir et Afficher dans le dossier. Ce dernier outil n’est pas proposé au petit modèle local ; demander à un poisson rouge de rédiger votre rapport trimestriel relève donc de votre responsabilité.
Ce que ChatForge ne fait pas exprès
ChatForge n’est pas un agent autonome ; cette limite est structurelle et non simplement une promesse formulée dans le prompt. Huit des neuf outils sont des requêtes en lecture seule ; le neuvième ne peut qu’ajouter un nouveau fichier dans son propre dossier sans jamais écraser quoi que ce soit ; aucun outil ne lance de programme, ne modifie de paramètre ou ne lit de fichiers autres que ceux que vous avez joints. fetch_url bloque les adresses privées et locales (y compris la résolution DNS), la calculatrice n’est qu’un évaluateur listé en blanc avec aucune fonction eval, les clés API sont stockées dans le Gestionnaire de identifiants Windows et filtrées automatiquement du journal ; enfin, le serveur modèle se termine avec l’application, par conception. Une seule conversation est conservée ; il n’existe aucun archivage de toutes vos requêtes passées. Le pire qu’un modèle perdu puisse faire ici est de donner une mauvaise réponse et d’ajouter un fichier dans un dossier — ce qui correspond exactement à la portée des dégâts que l’on peut attendre d’un assistant rudimentaire.
Pièges à éviter
pythonseul sur Windows renvoie au stub du Microsoft Store. Utilisez toujourspy -3.12 -m uv run …ou les lanceurs disponibles danslaunchers\. Cet écueil survient avant tout autre problème.- La touche Copilot ne peut pas servir de raccourci clavier. Elle correspond à
Win+Shift+F23et Windows la réserve. Seule une réassignation via PowerToys fonctionne (voir ci-dessus). - Une compilation réussie ne garantit pas un modèle utilisable. Qwen3-4B se compile sans erreur mais produit des résultats incohérents sur la puce NPU ; le catalogue le marque comme À éviter, et tout ce qui n’est pas connu y est classé Non testé.
- Une mise à jour de pilote ou un mode veille peuvent corrompre le cache de compilation. Allez dans Paramètres > Modèles > Effacer le cache, puis chargez le modèle. Un fournisseur de secours vous permettra de continuer à dialoguer.
- Le petit modèle perd en efficacité dans les longues conversations — il cesse d’utiliser les outils, entre en boucle ou donne des réponses erronées. Il s’agit simplement d’une limite liée à la petite taille du modèle et à sa capacité contextuelle ; appuyez sur « Effacer la conversation » ou basculez sur un modèle plus grand pour les questions complexes.
- Les anciens fichiers
.xls/.pptnécessitent Office (la conversion se fait en arrière-plan sur une copie temporaire). Sans Office, convertissez-les d’abord en.xlsx/.pptx. Les photos HEIC requièrent le paquet optionnelpillow-heif, ou il faut les exporter au format JPEG. - Note de licence si redistribution : l’application est sous licence MIT, mais
pystray(la bibliothèque d’icône système) est sous LGPL-3.0 et intégrée telle quelle à l’exécution. Cela convient pour une installation classique ; si vous distribuez un paquet exécutable incluant cette bibliothèque, vous devrez respecter les obligations de redistribution prévues par la licence LGPL.
Bilan personnel
Le fait qu’il ne se soit écoulé que deux jours entre le premier commit et une version v0.1.0 que j’utilise réellement témoigne davantage de l’utilisation de composants éprouvés que de la rapidité d’exécution. Le superviseur, l’interface de chat et le client de streaming proviennent tous de projets déjà opérationnels chez moi. La puce NPU s’est avérée être la partie facile ; le véritable défi a été de rendre un modèle de 1,5 milliard d’éléments vraiment utile (sélection restreinte d’outils, recherche préalable, gestion des refus) et de limiter les fonctionnalités : pas de capacités d’agent autonome, pas d’archivage des conversations, et rien n’est envoyé dans le cloud sans demande explicite. Ce produit est tout neuf, réservé à Windows uniquement ; la version 0.1.0 est bien ce qu’elle indique, et c’est la suite de tests qui me donne le courage d’aller de l’avant : 1 520 tests Python et 114 tests JS, tous validés sur Windows et Linux dans le cadre du CI.
Versions
À partir du dépôt mentionné dans cet article (vérifié le 02/10/2026) :
$ git log -1 --format='%h %ci'
2edd2d4 2026-10-02 18:04:38 +0900        # ChatForge v0.1.0

$ uv run pytest -q
1520 passed, 6 skipped, 6 deselected in 50.65s   # sur Linux, Python 3.13.14

$ npm run -s test:js
tests 114 / pass 114 / fail 0                     # Node v24.18.0
Sur Windows, le moteur utilisé est OpenVINO Model Server 2026.4.0 (python_on), avec le modèle OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov, testé sur un Intel Core Ultra 5 226V. Les chiffres concernant la puce NPU proviennent du fichier docs/RUNTIME-NOTES.md du dépôt, qui recense également les configurations échouées de Qwen3-4B.
Voir aussi : StudioForge : serveur LLM réservé aux GPU · DisPatch : chat IA auto-hébergé · Première approche de DeepSeek Harness (dsh) · Exécuter DeepSeek localement : guide en 4 étapes · Coût réel de mes agents IA : DeepSeek comparé aux grands API
Téléchargements
Gratuit pour un usage personnel. Si ça vous fait gagner un après-midi, le bouton café n'est pas loin.