ChatForge: un asistente de IA local con NPU para la tecla Copilot
- Categoría
- IA y LLM Local
- Publicado
- 2 octubre 2026
- Actualizado
- 3 octubre 2026
- Por
- Jacob Lloyd — escrito con ayuda de IA, después del proyecto
- Tiempo de lectura
- 14 min de lectura
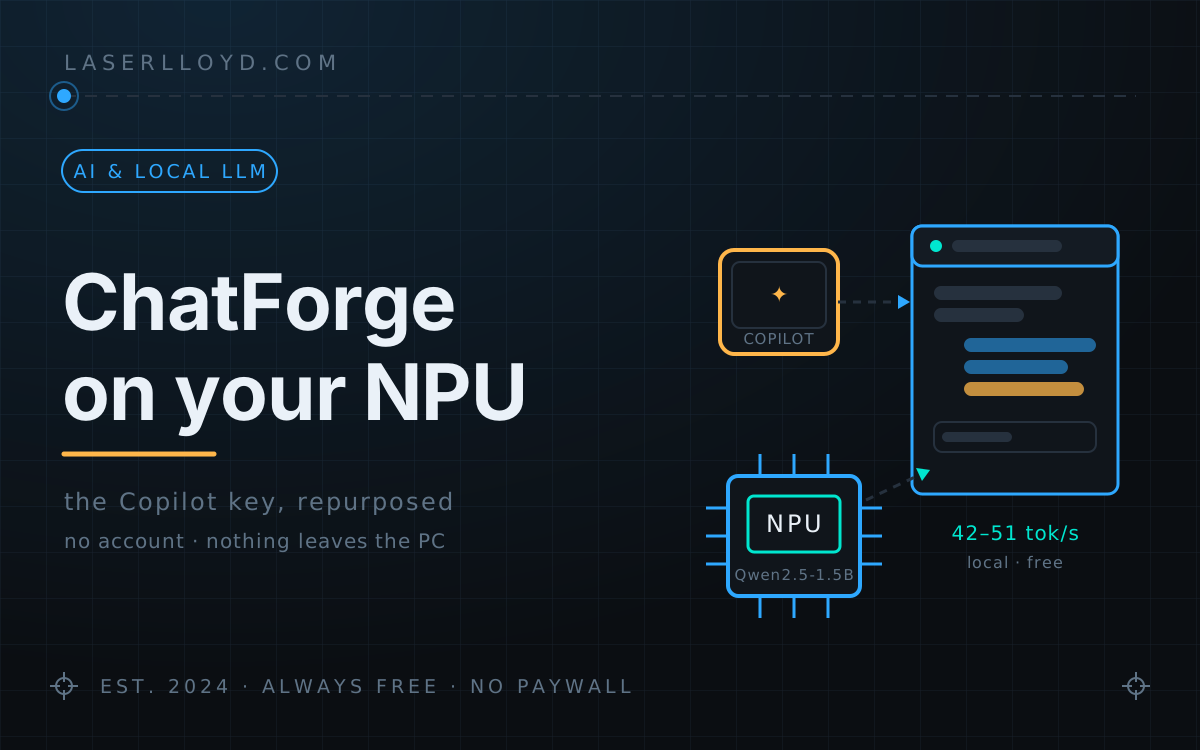
En palabras simples: Las nuevas laptops de Intel cuentan con un chip especial de IA (una NPU) que en su mayoría permanece sin usar, además de una tecla Copilot que activa el asistente de Microsoft. ChatForge es un programa gratuito que le asigna a esa tecla otra función: abre una pequeña ventana de chat que responde mediante un modelo que se ejecuta en la propia laptop, sin necesidad de cuenta ni cuota mensual; además, puede buscar información en tiempo real como el clima o las noticias. Para preguntas más complejas, esa misma ventana puede consultar a un servicio de IA más avanzado.
Mi portátil viene con una tecla dedicada para IA y un chip NPU para IA; sin embargo, desde que lo compré nunca han interactuado: la tecla abre Microsoft Copilot en la nube, mientras que el NPU permanece inactivo. Eso me molestó más de lo debido. Por eso ahora esa tecla abre ChatForge, mi propio asistente. Este ejecuta el modelo Qwen de 1,5 mil millones de parámetros en el NPU, alcanzando entre 42 y 51 tokens por segundo. No se requiere cuenta, suscripción ni pago por cada token; además, las conversaciones nunca abandonan el equipo. Cuando una pregunta supera la capacidad de este modelo pequeño, un servidor con GPU o cualquier modelo en la nube están a un clic de distancia, dentro del mismo menú emergente.
Este artículo es una guía completa: explica qué hace ChatForge, cómo es trabajar con el NPU (incluyendo el caso en que un modelo se compiló correctamente pero luego generó resultados incomprensibles), y los trucos que permiten a un modelo tan pequeño dar respuestas reales en lugar de respuestas genéricas típicas de modelos de ese tamaño.
Resumen rápido
- ¿Qué es? Un asistente gratuito para el área de notificaciones de Windows 11, bajo licencia MIT. Con
Ctrl+Alt+C(o la tecla Copilot, reasignada mediante PowerToys) se abre un menú emergente de 420 × 620 píxeles en la esquina inferior derecha; presionando Escape se cierra. Fuente: github.com/LaserLloyd/ChatForge. - El modelo local:
Qwen2.5-1.5B-Instruct(versión INT4, 0,94 GB de tamaño), servido por OpenVINO Model Server en el NPU “AI Boost” de Intel. La primera compilación para el NPU dura unos 45 segundos; después se carga desde la caché en aproximadamente 3 segundos, generando entre 42 y 51 tokens/s. Se descarga automáticamente tras 10 minutos de inactividad. - Modelos más grandes, mismo menú: StudioForge (tu propio servidor con GPU), MiniMax, OpenAI, DeepSeek o cualquier URL compatible con OpenAI. Las claves de acceso se guardan en el Administrador de Credenciales de Windows, nunca en archivos de configuración.
- Nueve herramientas: búsqueda web y de noticias, recuperación de páginas, pronóstico del tiempo, Wikipedia, tipos de cambio, fecha y hora, calculadora; además de
create_document, que guarda automáticamente en Word, Excel o PowerPoint lo que el modelo genera. Puedes adjuntar hasta 10 archivos por mensaje y preguntar sobre ellos. - Lo que NO es: un agente autónomo. Ninguna herramienta ejecuta programas ni modifica configuraciones; la única que genera contenido solo puede crear nuevos archivos en su propia carpeta.
¿Qué obtienes al final?
A un clic de distancia, cualquier aplicación: presionas la tecla, escribes tu pregunta, lees la respuesta y pulsas Escape. Cada respuesta indica claramente qué modelo la generó y a qué velocidad; así sabes siempre si se trata del modelo local gratuito o de alguno que sí requiere pago. Cuando una consulta necesita datos en tiempo real, aparece un chip de herramientas mostrando lo buscado; si solicitas un informe a un modelo más grande, la respuesta incluye una tarjeta con opciones para Abrir y Mostrar en carpeta.
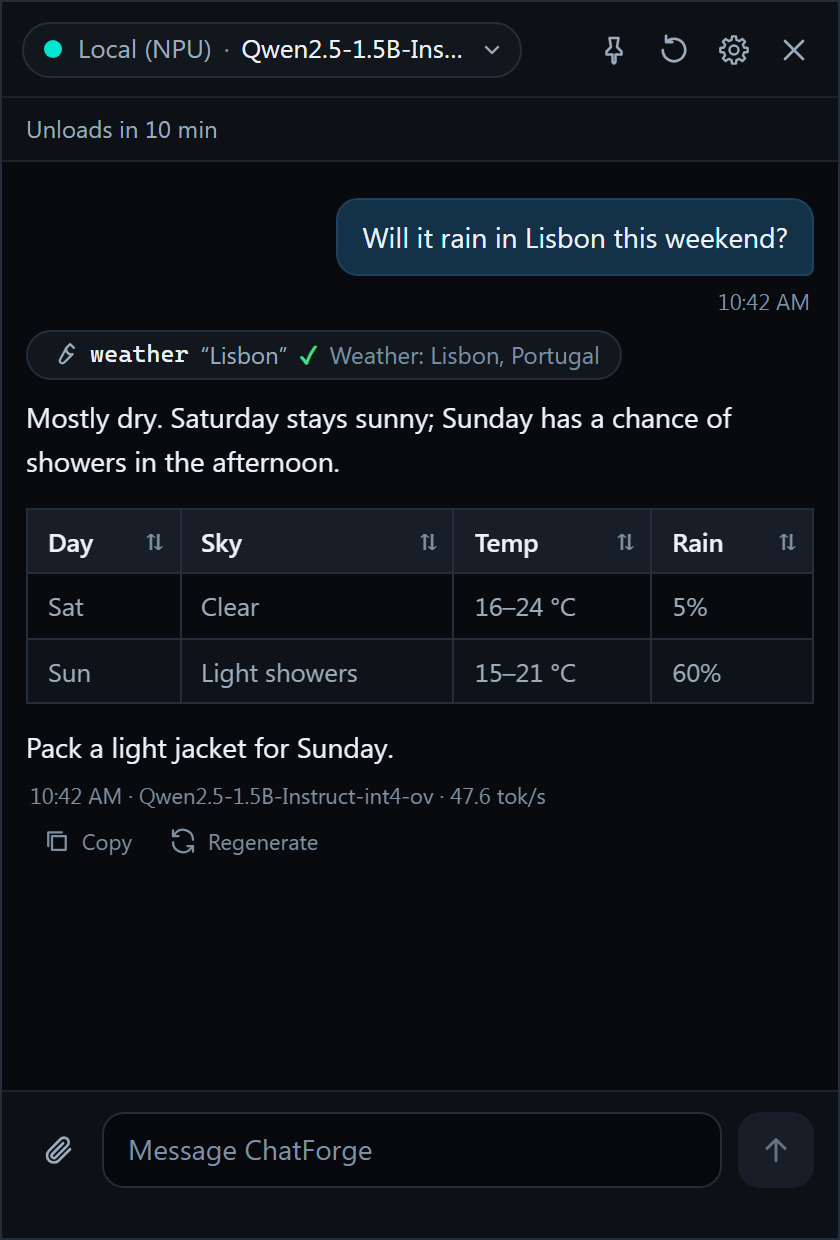
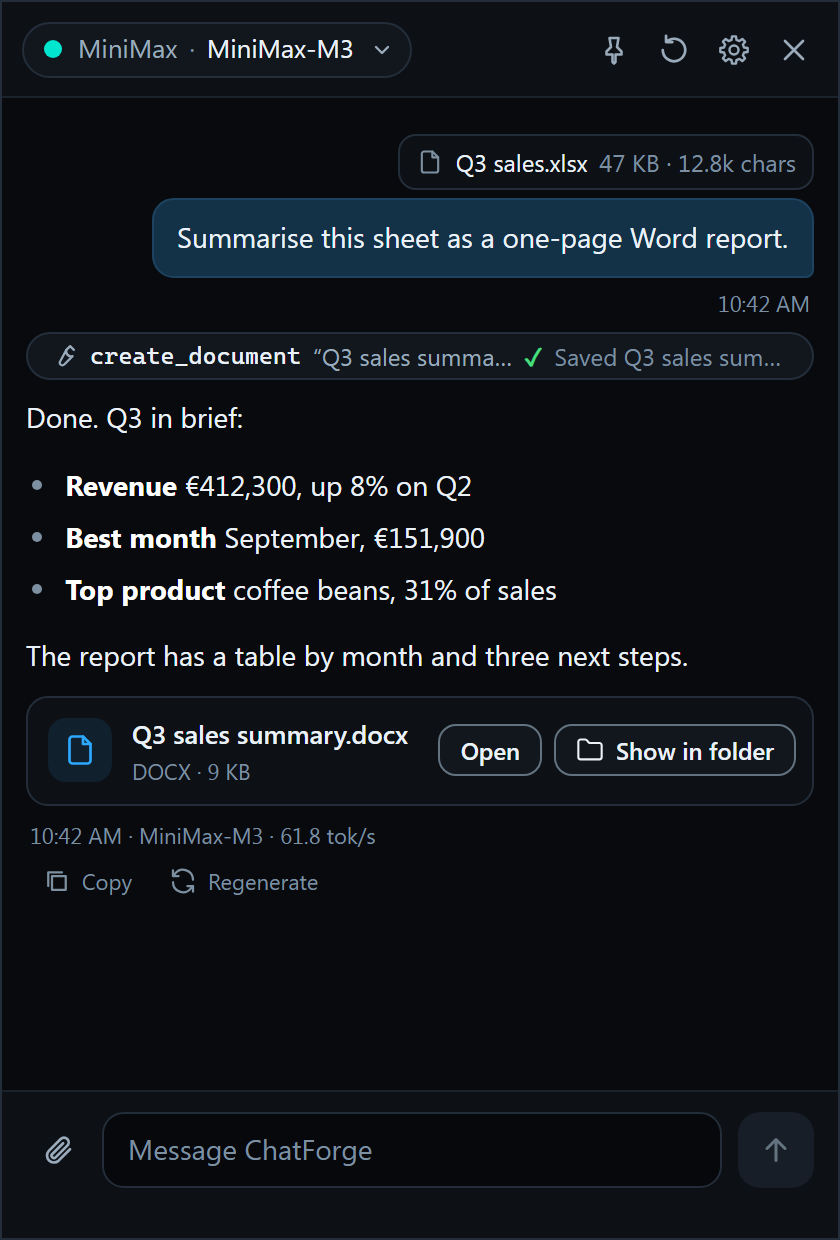
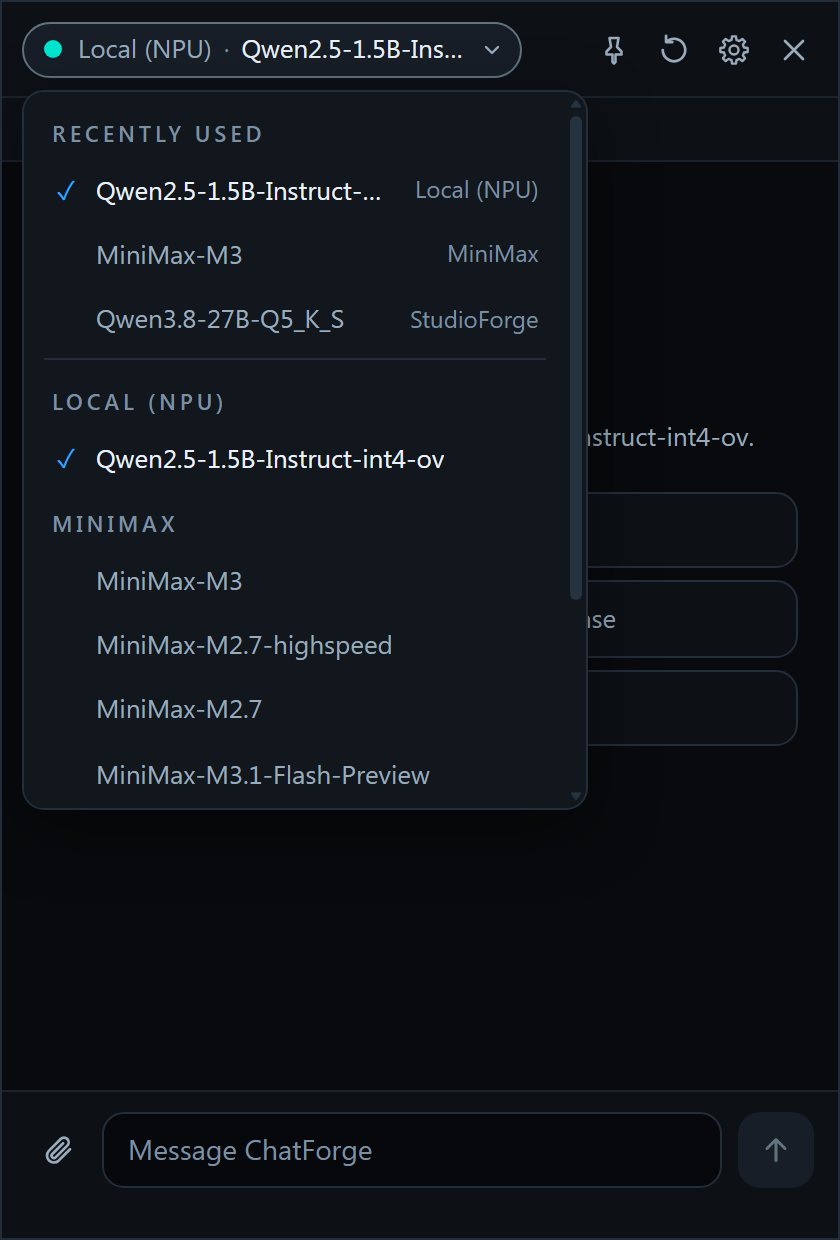
Las conversaciones, imágenes, ubicaciones y nombres de servidores mostrados en las capturas son datos de ejemplo; la interfaz es real, renderizada en Edge (motor subyacente de WebView2) a partir del prototipo de desarrollo del proyecto.
¿Dónde descargarlo?
Todo está disponible en un único repositorio bajo licencia MIT: github.com/LaserLloyd/ChatForge. Allí encontrarás también las notas de ejecución con todas las mediciones de rendimiento del NPU citadas en este artículo. ¿Prefieres un archivo zip? En el cuadro de Descargas al final de esta página tienes el código fuente completo; también está disponible en la sección Descargas del sitio web.
Cómo funciona todo junto
Un único proceso en Python controla todo: el icono en la bandeja, la combinación global de teclas, el menú emergente y las ventanas de Configuración (implementadas con pywebview sobre WebView2); además, un núcleo asyncio se encarga de enviar respuestas y ejecutar herramientas. El servidor del modelo es un proceso hijo totalmente gestionado por este programa: se inicia al abrir el menú con el modelo local seleccionado, y se finaliza junto con la aplicación mediante un objeto de trabajo de Windows; así, un posible fallo no deja ningún proceso residiendo en tu memoria RAM.
Pocas partes se escribieron desde cero; considero eso un gran logro: el supervisor de procesos, el descargador, la bandeja del sistema y el sistema de registros provienen de StudioForge; la interfaz de chat y el motor Markdown son herencia de DisPatch; el cliente de transmisión proviene de mi herramienta de evaluación. Todos estos componentes ya habían resistido meses de uso diario, y cada módulo adaptado incluye esa información al inicio de su código. Gracias a esa reutilización, el primer commit y la versión v0.1.0 están separados por apenas dos días (de la noche del 30 de septiembre de 2026 al 2 de octubre de 2026); un agente LLM se encargó de ensamblar todo según un plan escrito que abarcaba unas 1.000 líneas.
Instalación
El archivo docs/SETUP.md del repositorio contiene la guía completa; en versión resumida, se necesitan tres comandos PowerShell y una descarga de modelo:
git clone https://github.com/LaserLloyd/ChatForge.git
cd ChatForge
py -3.12 -m uv sync --extra dev

py -3.12 -m uv run chatforge runtime install   # OpenVINO Model Server 2026.4.0, descarga de 139 MB con hash SHA-256 verificado
py -3.12 -m uv run chatforge doctor            # tabla de resultados: Python, WebView2, NPU, OVMS, keyring, espacio en disco…
A continuación, ejecuta launchers\ChatForge.bat, abre Configuración > Modelos, busca “Qwen” y pulsa Descargar en la fila marcada como Recomendado: se trata de OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov, con un tamaño de 0,94 GB. En el primer inicio, ChatForge activa automáticamente la ejecución al iniciar sesión (una tarea programada por usuario; nada requiere privilegios de administrador) y registra la combinación de teclas. La primera carga del modelo compila todo en el NPU: dura unos 45 segundos, con un contador visible en el encabezado para que no parezca un fallo; a partir de entonces, cada carga se realiza desde la caché en aproximadamente 3 segundos.
El problema de la tecla Copilot
Aquí está esa parte que nadie le cuenta al comprar el portátil. La tecla Copilot no es una tecla a la que se puedan asignar atajos personalizados. Envía la combinación Win+Shift+F23; Windows registra dicha combinación para uso propio, y el selector de configuraciones oficial solo ofrece aplicaciones empaquetadas y firmadas. Su propio programa no está en la lista permitida para usar con su propio teclado.
La solución viable es utilizar el Administrador de Teclado de PowerToys: reasigne el atajo Win (Izquierda) + Shift (Izquierda) + F23 a Ctrl+Alt+C (el atajo de ChatForge) y active la opción Ejecutar al iniciar de PowerToys. Con una sola reasignación, esa tecla reservada por Microsoft para Copilot ahora abre su asistente. Si en algún momento esa tecla vuelve a abrir la Búsqueda de Windows o Copilot, significa que PowerToys no se está ejecutando; ese es el único modo de fallo posible, y es lo primero que hay que comprobar cuando surgen problemas.
Cómo hacer que un modelo de 1,5 mil millones de parámetros sea útil
Un modelo de 1,5 mil millones de parámetros con una ventana de contexto de 4096 tokens es como un pez dorado con tarjeta de biblioteca. La ingeniería implementada en ChatForge trabaja con esa limitación en lugar de ignorarla:
- Lista corta de herramientas. Existen nueve herramientas, pero al modelo local solo se le ofrecen cinco (búsqueda, obtención de páginas, clima, fecha/hora y calculadora). Los modelos pequeños se confunden con menús largos de herramientas; reducir la lista mantiene sus llamadas a herramientas ordenadas.
- Consultar primero. Cuando una pregunta requiere datos actualizados (“clima”, “precio actual”, etc.), primero se ejecuta la herramienta correspondiente; el modelo responde basándose en el resultado, no adivinando. Se trata de simple coincidencia de patrones, sin necesidad de llamadas adicionales al modelo.
- Recuperación ante negativas. Los modelos pequeños suelen responder “No tengo acceso a datos en tiempo real” aunque exista una herramienta de búsqueda. Si el modelo responde en primera persona negando algo o promete buscar información sin hacerlo (“Permítame buscar eso…”), esa respuesta se descarta; el motor realiza la consulta y el modelo vuelve a responder. Mientras tanto, aparece un mensaje “Buscando información…”, ocultando el primer borrador del modelo.
- Sin resúmenes automáticos. Cuando una conversación supera el límite de tokens, las partes más antiguas simplemente se omiten del prompt; un separador visual indica exactamente dónde comienza la visión actual del modelo. No se parafrasea nada a espaldas del usuario, lo cual evita costos adicionales por llamadas al modelo; además, se informa al modelo que los mensajes antiguos fueron eliminados para que no invente respuestas.
- Control de bucles y límite de uso. Un mensaje puede recibir hasta 6 rondas de llamadas a herramientas; cualquier llamada idéntica repetida se rechaza. Un modelo de 1,5 mil millones de parámetros podría seguir solicitando datos climáticos indefinidamente si se le permite.
- Red de seguridad. Si el modelo basado en la NPU falla al cargarse, se bloquea o excede el tiempo de espera, el mismo mensaje puede reenviarse a un proveedor alternativo elegido por el usuario.
Nada de esto requiere la NPU; el mismo motor funciona con modelos más grandes. Pero es precisamente lo que permite que el modelo local gratuito responda correctamente “¿Lloverá este fin de semana?” a toda velocidad, en lugar de negarse educadamente.
El modelo que compiló sin problemas pero dio respuestas erróneas
El plan inicial era usar Qwen3-4B como modelo local: un modelo más grande, de una familia más reciente; la opción obvia. Sin embargo, el archivo docs/RUNTIME-NOTES.md describe el obstáculo: Qwen3-4B-int4-ov compila sin errores en la NPU, pero genera resultados incorrectos con OVMS 2026.4; los mismos archivos del modelo sí responden correctamente en la CPU, a una velocidad de 24 tokens por segundo. El fallo es específico de la NPU; todas las configuraciones probadas fallaron, y las demás cuantizaciones posibles no permiten llamadas a herramientas en OVMS 2026.4. En entornos con NPU, una compilación exitosa no garantiza nada. Es imprescindible verificar los resultados antes de confiar en ellos.
Lo que finalmente se implementó, probado en un Core Ultra 5 226V (Lunar Lake):
| Qwen2.5-1.5B-Instruct INT4 en la NPU | Medición |
|---|---|
| Primera compilación (única vez) | 44,5 s |
| Carga desde caché de compilación | 2,7–3,2 s |
| Decodificación | 42–51 tokens/s |
| Tiempo hasta el primer token (prompts cortos) | 0,5–0,8 s |
| Tamaño del caché de compilación en disco | 306 MiB |
| Ventana de contexto permitida | 4096 tokens |
Un detalle de optimización mencionado en ese mismo archivo: OVMS admite el parámetro BEST_PERF que aumenta la velocidad de decodificación en un 10% (48,3 tokens/s), pero la compilación tarda 135 s, tres veces más que el valor por defecto. ChatForge lo deja desactivado; creo que es lo correcto: los 45 s iniciales ya están cerca del límite de paciencia de un usuario primerizo.
Archivos de entrada y documentos de salida
Se pueden adjuntar hasta 10 archivos por mensaje (mediante el clip, arrastrar o pegar; cada uno de hasta 20 MB): código y texto, CSV, JSON, HTML, Word, Excel, PowerPoint, OpenDocument, RTF, correos, PDF e incluso archivos .doc antiguos se leen directamente. Los formatos .xls/.ppt obsoletos se convierten mediante Microsoft Office si está instalado; las imágenes se revisan, orientan correctamente, reducen a 1568 píxeles y pierden toda metadata (ubicación GPS, fecha, cámara); los modelos incapaces de procesar imágenes reciben el texto extraído por el OCR de Windows.
En sentido inverso, create_document permite a un modelo de StudioForge o en la nube guardar sus respuestas: ChatForge genera archivos .docx, .xlsx y .pptx a partir del Markdown producido por el modelo, usando exclusivamente la biblioteca estándar de Python; no se necesita Office. Los archivos se ubican en Documents\ChatForge; si el nombre ya existe, se crea uno nuevo como informe (2).docx para evitar sobrescrituras. La respuesta incluye una tarjeta con botones Abrir y Mostrar en carpeta. El pequeño modelo local no dispone de esta herramienta; pedirle a un pez dorado que redacte su informe trimestral es responsabilidad del usuario.
Lo que deliberadamente NO es
ChatForge no es un agente autónomo; ese límite es estructural, no una mera promesa en el prompt. Ocho de las nueve herramientas son consultas de solo lectura; la novena solo permite añadir archivos a su propia carpeta sin sobrescribir nada; ninguna herramienta ejecuta programas, modifica configuraciones ni accede a archivos no adjuntados. fetch_url bloquea direcciones privadas y locales (incluyendo rebinding DNS); la calculadora es un evaluador con lista blanca que no permite eval; las claves API se guardan en el Administrador de Credenciales de Windows y se ocultan en los registros; el servidor del modelo se cierra automáticamente al apagarse la aplicación. Solo mantiene una conversación activa; no hay archivo histórico de todas las consultas. Lo peor que un modelo confundido puede hacer es dar una respuesta errónea y crear un archivo nuevo; eso es todo el riesgo permitido para un asistente local.
Advertencias
- El comando
pythonpuro en Windows apunta al stub de Microsoft Store. Use siemprepy -3.12 -m uv run …o los lanzadores enlaunchers\. Este detalle suele ser el primer obstáculo. - La tecla Copilot no puede usarse como atajo. Es
Win+Shift+F23y Windows la reserva; solo PowerToys permite reasignarla. - No asuma que una compilación exitosa implica un modelo funcional. Qwen3-4B compila sin errores pero da resultados erróneos en la NPU; el catálogo marca ese modelo como Evitar, y todo lo desconocido queda como Sin probar.
- Una actualización de controladores o un ciclo de suspensión/reactivación pueden dañar el caché de compilación. Vaya a Configuración > Modelos y haga Limpiar caché, luego vuelva a cargar. Un proveedor alternativo mantendrá la comunicación activa mientras tanto.
- El modelo pequeño pierde eficacia en conversaciones largas — deja de usar herramientas, entra en bucles o responde mal. Esto es consecuencia natural de la limitada capacidad de contexto de un modelo de 1,5 mil millones de parámetros; no es un error que deba corregirse: basta con limpiar el chat o cambiar a un modelo más grande.
- Los archivos
.xls/.pptantiguos requieren Office instalado (la conversión ocurre en una copia temporal). Sin Office, conviértalos primero a.xlsx/.pptx. Las fotos HEIC necesitan el paquete opcionalpillow-heif, o exportarlas como JPEG. - Nota de licencia si redistribuye: la aplicación es MIT, pero
pystray(la biblioteca de iconos) es LGPL-3.0; se importa sin modificaciones en tiempo de ejecución. Está bien tal cual instalado; si crea un paquete empaquetado que incluya esa biblioteca, usted asume la obligación de relinkar bajo LGPL.
Mi conclusión
El hecho de pasar de la primera commit a una versión v0.1.0 realmente utilizable en solo dos días refleja más el aprovechamiento de componentes ya probados que la velocidad de desarrollo propiamente dicha. El supervisor, la interfaz de chat y el cliente de streaming provienen todos de proyectos ya en uso aquí. La NPU resultó ser la parte fácil; lo realmente complejo fue hacer útil un modelo de 1,5 mil millones de parámetros (mediante el subconjunto de herramientas, la consulta previa a los datos y la recuperación ante negativas) y limitar su alcance: sin poderes de agente autónomo, sin historial de chats y sin conexión a la nube salvo petición explícita del usuario. Es un producto nuevo, exclusivo para Windows; el número de versión 0.1.0 no es una broma, sino realidad. El conjunto de pruebas me da confianza para avanzar: 1.520 pruebas en Python y 114 en JavaScript, todas exitosas tanto en Windows como en Linux mediante CI.
Versiones
Según el repositorio a fecha de redacción (verificado el 2026-10-02):
$ git log -1 --format='%h %ci'
2edd2d4 2026-10-02 18:04:38 +0900        # ChatForge v0.1.0

$ uv run pytest -q
1520 passed, 6 skipped, 6 deselected in 50.65s   # en Linux, Python 3.13.14

$ npm run -s test:js
tests 114 / pass 114 / fail 0                     # Node v24.18.0
En Windows se utiliza OpenVINO Model Server 2026.4.0 (python_on) con el modelo OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov, probado en un Intel Core Ultra 5 226V. Las cifras de rendimiento en NPU provienen del archivo docs/RUNTIME-NOTES.md del repositorio, donde también se detallan las configuraciones fallidas de Qwen3-4B.
Relacionado: StudioForge: servidor LLM exclusivo para GPU · DisPatch: chat de IA autoalojado · Primeras impresiones de DeepSeek Harness (dsh) · Ejecutar DeepSeek localmente: guía de 4 pasos · Coste real de mis agentes de IA: DeepSeek frente a las grandes APIs
Descargas
Gratis para uso personal. Si te ahorra una tarde, el botón del café está aquí cerca.