ChatForge:一款专为 Copilot 键设计的本地 NPU AI 助手
- 发布日期
- 2026年10月2日
- 更新日期
- 2026年10月3日
- 作者
- Jacob Lloyd —— 项目完成后,在 AI 协助下撰写
- 阅读时长
- 约 14 分钟阅读
简单来说: 新款英特尔笔记本电脑配备了一颗专用的AI芯片(NPU),但这颗芯片大多时间都处于闲置状态。此外,电脑上还有一个“Copilot”键,用于激活微软的助手功能。ChatForge是一款免费程序,它能让这个按键发挥其他作用:它会打开一个小型聊天窗口,该窗口能调用运行在用户笔记本电脑上的AI模型来回答问题。使用此程序无需注册账户,也无需支付任何费用;它还能查询天气、新闻等实时信息。对于较为复杂的问题,该窗口则可转而调用更强大的AI服务来处理。
我的笔记本电脑自带专用的 AI 快捷键和专用的 AI 芯片,但刚买来时它们始终“形同陌路”:按下快捷键会打开微软 Copilot 云服务,而 NPU 则闲置着毫无用处。这种情况让我有些心烦。于是现在我让该快捷键调用 ChatForge——我自行开发的 AI 助手。它能在 Intel “AI Boost” NPU 上运行参数量为 15 亿的 Qwen 模型,生成速度可达每秒 42–51 个词符。无需注册账号、无需订阅,也没有按词符计费的情况;所有对话内容也完全保留在本地电脑中。如果某个问题超出了这个小模型的处理能力,只需点击一下即可调用我的 GPU 服务器或云端的其他大模型。
本文将带您全面了解这款工具:它的功能、NPU 的实际使用体验(包括那个编译顺利却输出乱码的模型案例),以及让如此小型的模型也能给出靠谱答案的各种技巧。
简而言之
- 简介:一款免费且采用 MIT 许可证的 Windows 11 通知栏助手。
Ctrl+Alt+C(或通过 PowerToys 重新映射的 Copilot 键)会在屏幕右下角弹出尺寸为 420 × 620 的窗口;按下 Esc 键即可关闭。源码地址:github.com/LaserLloyd/ChatForge。 - 本地模型:
Qwen2.5-1.5B-Instruct(INT4 量化版,下载体积仅 0.94 GB),由 OpenVINO Model Server 在 Intel “AI Boost” NPU 上运行。首次加载时需约 45 秒完成 NPU 编译;之后每次启动仅需约 3 秒即可从缓存中读取并解码,生成速度稳定在每秒 42–51 词符。若连续 10 分钟无操作,模型会自动卸载。 - 更大模型,同一界面:可通过该界面调用 StudioForge(即您自行搭建的 GPU 服务器)、MiniMax、OpenAI、DeepSeek 或任何兼容 OpenAI 协议的云端服务。相关密钥均存储于 Windows 凭据管理器中,绝不会出现在配置文件里。
- 九大工具:网页与新闻搜索、页面抓取、天气查询、维基百科检索、汇率换算、日期时间查询、计算器;还有
create_document功能,可生成模型撰写的 Word、Excel 或 PowerPoint 文档。每条消息最多可附带 10 个文件并针对它们提问。 - 并非智能代理:它不具备自主执行程序或修改系统设置的能力;唯一具备写入功能的工具也仅能在指定文件夹内新建文件。
最终效果
只需按一下快捷键即可随时使用:按下按键、输入问题、阅读回复,再按 Esc 退出。每条回答都会标注所用模型及其生成速度,让您清楚知道当前得到的是免费的本地小模型还是需要付费的云端大模型。若问题需实时数据,相关工具图标会展示已检索的内容;若请求由大模型处理,回复中还会出现带有 Open 与 Show in folder 按钮的文档卡片。
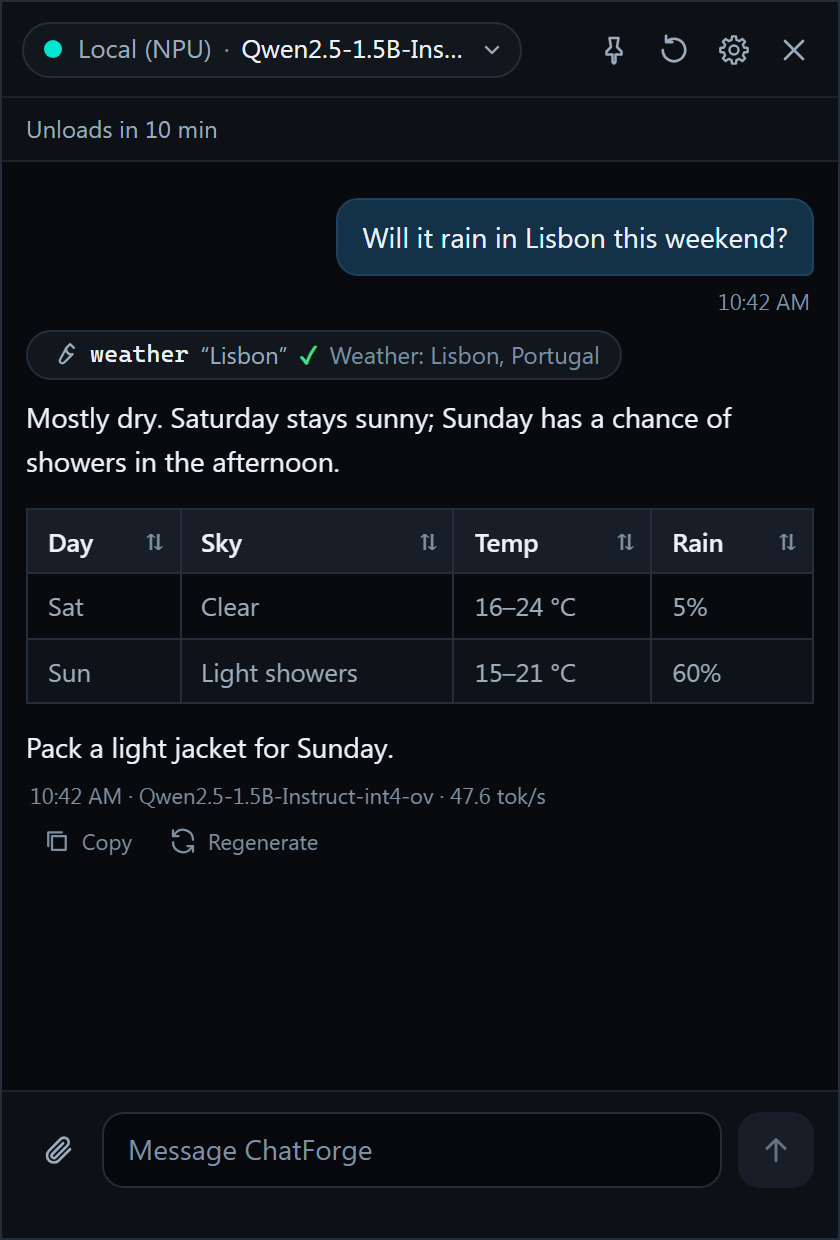
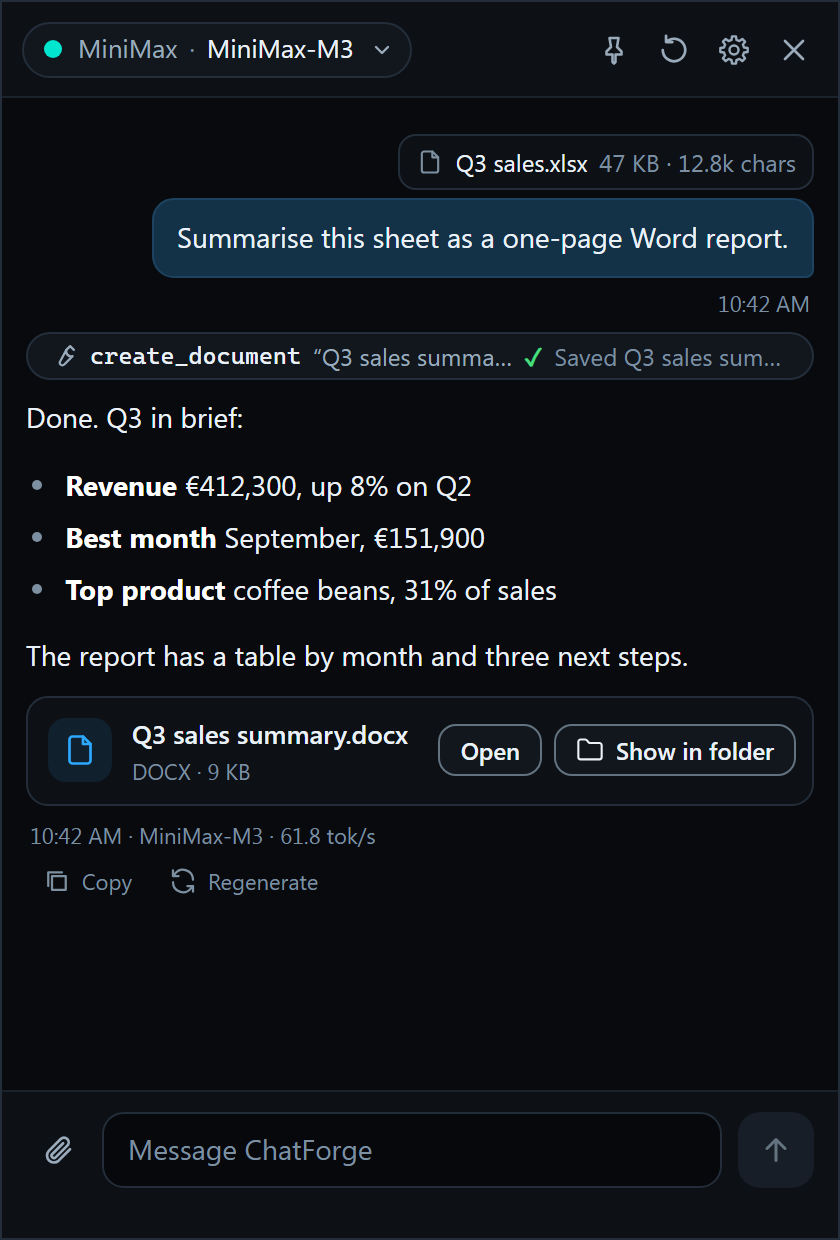
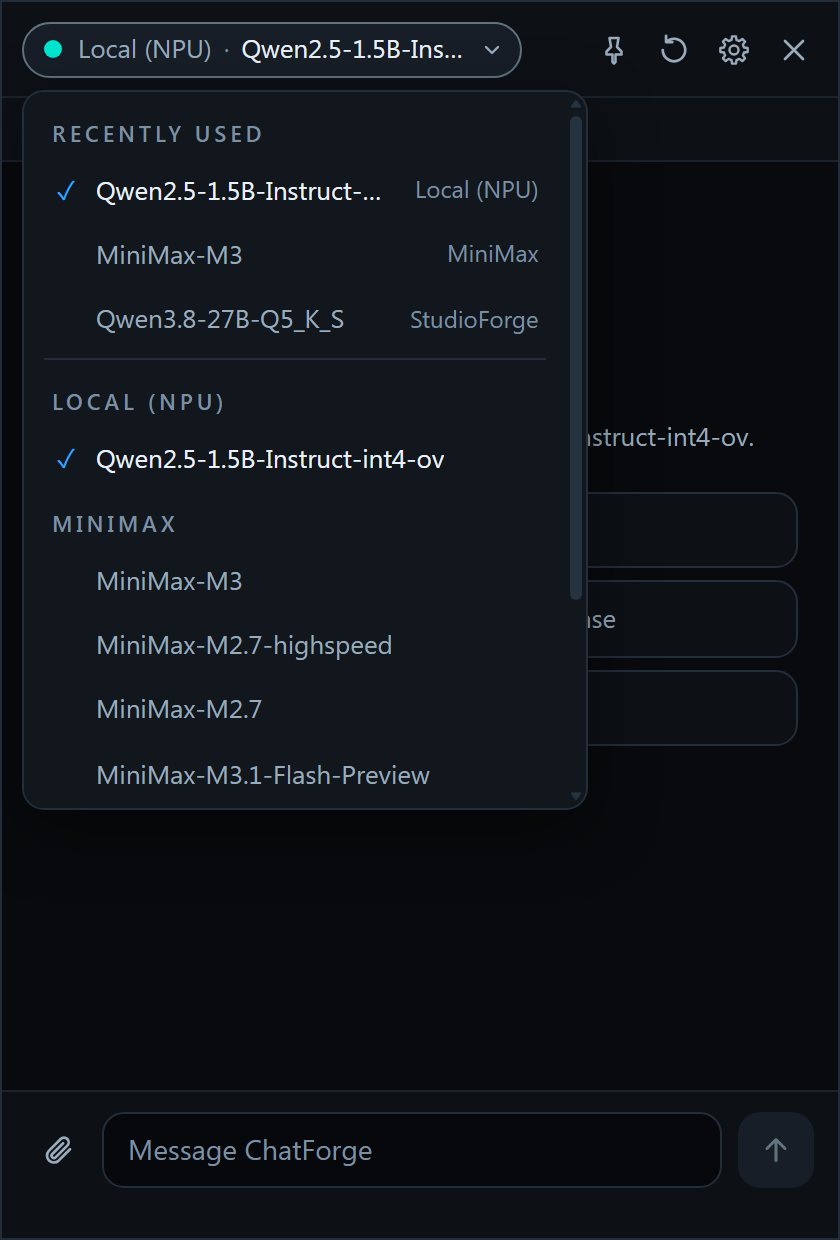
截图中的对话内容、地理位置及服务器名称均为示例数据;界面本身则是真实呈现效果,由 Edge 浏览器(即 WebView2 的底层引擎)配合项目开发阶段的模拟界面生成。
获取方式
整个程序仅发布于一个 MIT 许可证授权的代码库:github.com/LaserLloyd/ChatForge,其中还包含 运行时说明文档,详细记录了本文提及的所有 NPU 性能指标。若偏好直接下载压缩包,本页底部的下载区以及网站的 下载页面也提供了完整源码包。
整体架构
整个程序由单个 Python 进程统一管理:包括系统托盘图标、全局快捷键、弹出窗口与设置界面(基于 WebView2 的 pywebview 实现),以及负责流式生成回复并调度各类工具的 asyncio 核心。模型服务进程同样由该主进程完全掌控——当弹出窗口中选中本地模型时,该子进程随即启动;程序退出时则通过 Windows 作业对象强制终止,确保即便发生崩溃也不会有模型进程长期占用内存资源。
实际上,程序的大部分代码并非从头编写——这一点反倒值得骄傲:进程监控、下载器、系统托盘及日志记录模块均源自 StudioForge;聊天界面与 Markdown 渲染流程则借鉴自 DisPatch,流式通信客户端更是直接复用了我开发的性能测试工具。这些组件早已经受了数月的实际高频使用检验,每个被移植进来的模块开头均有相应说明。正因如此,首个提交记录与 v0.1.0 版本发布日期仅相隔两天(分别为 2026-09-30 晚间与 2026-10-02);整个组装过程由大语言模型代理依据约 1000 行书面规划指令完成。
安装步骤
代码库中的 docs/SETUP.md 提供了完整安装指南;简要流程仅需三条 PowerShell 命令及一次模型下载:
git clone https://github.com/LaserLloyd/ChatForge.git
cd ChatForge
py -3.12 -m uv sync --extra dev

py -3.12 -m uv run chatforge runtime install   # 安装 OpenVINO Model Server 2026.4.0,下载大小约 139 MB,SHA-256 校验值已预先设定
py -3.12 -m uv run chatforge doctor            # 检测表:显示 Python、WebView2、NPU、OVMS、密钥存储及磁盘空间状态,结果标记为 pass/warn/fail
随后运行 launchers\ChatForge.bat 启动程序,进入 Settings > Models 页面并搜索 Qwen,点击标有 Recommended 字样的行中的 Download 按钮即可下载 OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov 模型包,体积仅 0.94 GB。首次启动时程序会自动添加“开机即启动”任务(该任务为针对当前用户的计划任务,无需管理员权限),同时注册全局快捷键。首次加载模型时,NPU 需花费约 45 秒完成编译;期间弹出窗口顶部会显示倒计时,以免用户误以为程序卡死。此后每次启动仅需约 3 秒即可从缓存中读取并运行模型。
Copilot 快捷键的问题
以下是购买笔记本电脑时没人会告诉你的事情:Copilot键其实无法被自定义绑定。它发送的是 Win+Shift+F23 这个组合键指令,而Windows系统本身也预留了该组合键的用途;在官方设置界面中,可供绑定的也仅为那些经过签名、官方认可的软件。也就是说,你自己编写的程序根本无法利用这个键盘按键。
可行的解决方案是使用 PowerToys 的键盘管理器:将 Win (左) + Shift (左) + F23 这个快捷键重新映射为 Ctrl+Alt+C(即ChatForge的快捷调用键),同时开启PowerToys的“开机自动运行”功能。这样一来,原本被微软预留给Copilot的那个按键就能用来启动你的助手程序了。如果将来该按键又恢复了打开Windows搜索或Copilot的功能,那说明PowerToys并未正常运行——这种情况确实会发生,因此它也是故障排查时的首要检查项。
如何让1.5B参数的模型真正派上用场
一个仅有1.5B参数的模型,其上下文窗口长度仅为4096个标记符,能力实在有限。ChatForge的设计思路就是顺应这一限制而非试图绕过它:
- 精简工具列表:系统共提供了九种工具,但针对本地运行的模型仅开放五种(搜索、网页抓取、天气查询、日期/时间获取以及计算器)。参数较少的模型很容易被冗长的工具菜单搞糊涂;缩减工具数量能确保模型发出的调用指令清晰无误。
- 先查询再作答:当用户提出需要实时数据的需求时(如“今天的天气如何?”、“最新的价格信息”),系统会先于模型生成回复之前调用对应工具获取数据,让模型直接基于真实结果作答。整个过程仅涉及简单的模式匹配,无需额外调用模型。
- 拒绝响应恢复机制:小型模型常常会直接回复“我无法获取实时数据”,即便已有合适的搜索工具可用。遇到此类以第一人称形式拒绝应答或承诺查询却未实际执行的回复时,系统会自动代为执行查询操作,随后再让模型给出最终答复。此时弹窗会显示“正在查询中……”,用户也看不到最初的那个敷衍性回复。
- 不自动摘要:当对话内容超出上下文窗口容量时,最早的几条对话记录会被直接剔除出输入文本;弹窗上也会明确标示出模型可读取内容的起始点。整个过程不会在后台对内容进行改写或总结,既无需额外调用模型,也能避免模型因信息缺失而胡乱编造答案。
- 循环限制与预算控制:单个请求最多只允许进行6次工具调用;若同一调用指令反复出现,系统也会直接拒绝执行——毕竟1.5B参数的模型会毫无顾忌地反复调用天气查询工具。
- 安全兜底机制:万一NPU上的模型加载失败、崩溃或响应超时,用户也可将相同请求发送至预先指定的其他服务商处。
以上功能均无需依赖NPU即可实现——整个处理流程同样适用于大型模型;但正是这些设计使得免费的本地模型也能以NPU的最高运行速度准确回答“本周末会下雨吗?”这类问题,而不会只是礼貌性地予以拒绝。
能顺利编译却输出乱码的模型
最初我们计划选用Qwen3-4B作为本地运行模型:参数规模更大、属于较新版本系列,看起来是理想之选。然而该模型的 文档说明 却揭示了其致命缺陷:Qwen3-4B-int4-ov版本虽能在NPU上顺利编译,但在OVMS 2026.4环境下输出的内容却杂乱无章——而同样的模型文件在CPU环境下却能以24个标记符/秒的速度给出正确结果。该问题仅存在于NPU运行环境中;我们尝试过的所有NPU配置均未能奏效,其他可能适用的量化版本也无法在OVMS 2026.4下实现工具调用功能。可见在NPU平台上,编译顺利并不代表模型就能正常工作:必须验证其输出内容是否可靠才行。
最终我们选用了Qwen2.5-1.5B-Instruct INT4版本并在Intel Core Ultra 5 226V(Lunar Lake)处理器上进行了测试:
| 项目 | 数值 |
|---|---|
| NPU上的首次编译耗时 | 44.5秒 |
| 从编译缓存中加载所需时间 | 2.7–3.2秒 |
| 文本解码速度 | 42–51个标记符/秒 |
| 短提示词下首个字符生成耗时 | 0.5–0.8秒 |
| 编译缓存占用磁盘空间 | 306 MB |
| 最大上下文窗口容量 | 4096个标记符 |
同份文档还提到一个优化技巧:OVMS支持BEST_PERF编译参数,启用后可提升约10%的解码速度(达48.3个标记符/秒),但代价是编译时间延长至135秒——是默认设置下的三倍。ChatForge并未启用该选项,我认为这十分明智:45秒的首次编译耗时已经接近普通用户能接受的等待极限了。
文件上传与文档生成功能
每次对话最多可上传10个文件(支持点击附件图标、拖拽或粘贴方式;单个文件大小上限为20 MB):涵盖代码文本、CSV、JSON、HTML、Word文档、Excel表格、PowerPoint演示文稿、OpenDocument格式、RTF文档、电子邮件以及PDF文件,甚至可直接读取旧版.doc格式文件。若用户安装了Microsoft Office,系统还会自动转换老旧的.xls/.ppt格式文件。上传的图片会经过自动校正、尺寸压缩至1568像素以下并移除所有元数据——相机信息、GPS坐标及拍摄时间均会在存储或发送前被彻底清除;无法识别图像的模型则会改用Windows自带的OCR功能提取图片中的文字内容。
反过来,create_document功能则允许StudioForge云端模型或本地模型将生成的文本保存为文档:ChatForge仅借助Python标准库即可将模型的Markdown格式输出自动转换为.docx、.xlsx及.pptx格式文件,完全无需借助Office软件。这些文档会被保存在Documents\ChatForge目录下;若文件名重复,系统会自动添加序号以生成如report (2).docx之类的文件名,避免覆盖原文件。回复界面还会显示包含打开与在文件夹中显示按钮的操作卡片。不过该功能并未向小型本地模型开放——指望一个参数有限的模型帮你撰写季度报告,实在是不切实际。
ChatForge的功能边界
ChatForge并非真正的智能代理程序;其能力范围有着明确的结构性限制而非仅由提示词决定。九种工具中有八种仅为只读查询功能;第九种工具也仅能向指定文件夹添加新文件且绝不会覆盖原有内容;没有任何工具可以执行程序、修改系统设置或读取用户未主动上传的文件。fetch_url功能会自动拦截私有网络地址及本地地址(包括DNS重绑定攻击风险);内置计算器仅允许执行预设范围内的运算,不允许使用eval函数;所有API密钥均安全存储在Windows凭据管理器中并经过日志脱敏处理;模型服务器本身也会随应用程序一同关闭。系统每次仅维持一次对话记录,不会保存用户的所有历史提问内容。即便模型出现判断失误,其可能造成的影响也仅限于输出错误答案或生成新文件——这种影响程度对于一款初级型助手程序而言尚属可控。
使用注意事项
- Windows原生环境下不可直接使用
python指令:该命令实际指向微软商店中的占位程序。请始终使用py -3.12 -m uv run …命令,或直接调用launchers\目录下的启动器程序。此问题常导致后续操作无法进行。 - Copilot键无法作为自定义快捷键使用:其固定组合键为
Win+Shift+F23,且被Windows系统所占用。只能借助PowerToys进行重新映射(具体方法见上文)。 - 编译成功不等于模型可用:Qwen3-4B虽然能顺利编译,但在NPU环境下却输出乱码。官方目录中对该模型标注了“应避免使用”字样;其他未知模型则标记为“未经测试”。
- 驱动更新或电脑休眠/唤醒可能破坏编译缓存:此时需进入设置 > 模型选项点击清除缓存,随后重新加载模型即可;在此期间可临时启用备用服务商以保证服务不中断。
- 小型模型在长对话中性能会下降:此类模型容易停止调用工具、陷入循环甚至给出错误答案。这属于参数规模限制导致的必然现象而非程序缺陷:只需点击“清空对话”或切换至更大规模的模型处理复杂问题即可。
- 旧版
.xls/.ppt格式文件需依赖Office软件转换:系统会在临时文件中完成转换操作,用户无需手动干预;若未安装Office,则需先将文件另存为.xlsx/.pptx格式。HEIC格式的图片则需安装可选的pillow-heif扩展程序才能正常处理,否则只能导出为JPEG格式。 - 再分发许可说明:本软件采用MIT许可证授权;但所用到的
pystray托盘库则遵循LGPL-3.0协议且运行时直接调用未修改的原版代码。安装使用完全合规;但若要打包分发包含该库的独立程序包,则需遵守LGPL协议的相关规定重新链接相关组件。
个人总结
从首次提交代码到推出实际可用的v0.1.0版本仅用了两天时间——这一速度更多得益于对成熟代码的复用而非开发效率本身。整个系统的管理模块、聊天界面及实时数据流处理组件均直接取自此前已在运行的多个项目。实际上NPU平台的适配反而是最容易的部分;真正的挑战在于如何充分发挥1.5B参数模型的潜力:精简工具子集、优先调用查询功能以及完善拒绝响应恢复机制。同时我们也刻意限制了其功能范围:不赋予其代理能力、不保存对话历史,除非用户主动要求否则绝不向云端发送任何数据。目前该产品尚处于测试阶段且仅支持Windows系统;版本号0.1.0名副其实——当前测试套件包含1520条Python测试用例与114条JavaScript测试用例,在Windows及Linux平台上均顺利通过持续集成测试。
版本信息
本文所述代码库的最新版本信息如下(验证日期:2026年10月2日):
$ git log -1 --format='%h %ci'
2edd2d4 2026-10-02 18:04:38 +0900        # ChatForge v0.1.0
测试情况如下:
$ uv run pytest -q
1520 passed, 6 skipped, 6 deselected in 50.65s   # 在Linux平台、Python 3.13.14环境下执行

$ npm run -s test:js
tests 114 / pass 114 / fail 0                     # Node v24.18.0环境
Windows环境下的运行参数:OpenVINO Model Server 2026.4.0(python_on模式),所用模型为OpenVINO/Qwen2.5-1.5B-Instruct-int4-ov,测试平台为Intel Core Ultra 5 226V处理器。前文所述的NPU性能数据均引自代码库中的docs/RUNTIME-NOTES.md文档,该文档亦记录了Qwen3-4B模型在各种配置下的运行失败情况。
相关链接:StudioForge:仅支持GPU运行的LLM服务器 · DisPatch:可自建的AI聊天系统 · DeepSeek Harness(dsh)初探 · 如何在本地运行DeepSeek:零基础四步指南 · 我的AI助手实际运行成本:DeepSeek与大型云服务商对比
下载
仅限个人使用免费。如果它替你省下了一下午的时间,欢迎点旁边的咖啡按钮支持一下。